Determining whether online users are authorized to access digital objects is central to preserving privacy. This paper presents the design, implementation, and deployment of Zanzibar, a global system for storing and evaluating access control lists. Zanzibar provides a uniform data model and configuration language for expressing a wide range of access control policies from hundreds of client services at Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Its authorization decisions respect causal ordering of user actions and thus provide external consistency amid changes to access control lists and object contents. Zanzibar scales to trillions of access control lists and millions of authorization requests per second to support services used by billions of people. It has maintained 95th-percentile latency of less than 10 milliseconds and availability of greater than 99.999% over 3 years of production use.
Determinar se usuários online estão autorizados a acessar objetos digitais é fundamental para preservar a privacidade. Este artigo apresenta o projeto, a implementação e a implantação do Zanzibar, um sistema global para armazenar e avaliar listas de controle de acesso. O Zanzibar oferece um modelo de dados e uma linguagem de configuração uniformes para expressar uma ampla gama de políticas de controle de acesso de centenas de serviços clientes no Google, incluindo Calendar, Cloud, Drive, Maps, Photos e YouTube. Suas decisões de autorização respeitam a ordenação causal das ações dos usuários e, assim, oferecem consistência externa em meio a alterações nas listas de controle de acesso e no conteúdo dos objetos. O Zanzibar escala para trilhões de listas de controle de acesso e milhões de requisições de autorização por segundo, dando suporte a serviços usados por bilhões de pessoas. Ele manteve latência no 95º percentil inferior a 10 milissegundos e disponibilidade superior a 99,999% ao longo de 3 anos de uso em produção.
Many online interactions require authorization checks to confirm that a user has permission to carry out an operation on a digital object. For example, web-based photo storage services typically allow photo owners to share some photos with friends while keeping other photos private. Such a service must check whether a photo has been shared with a user before allowing that user to view the photo. Robust authorization checks are central to preserving online privacy.
Muitas interações online exigem verificações de autorização para confirmar que um usuário tem permissão para realizar uma operação sobre um objeto digital. Por exemplo, serviços de armazenamento de fotos baseados na web normalmente permitem que os donos das fotos compartilhem algumas fotos com amigos enquanto mantêm outras fotos privadas. Tal serviço precisa verificar se uma foto foi compartilhada com um usuário antes de permitir que esse usuário veja a foto. Verificações de autorização robustas são fundamentais para preservar a privacidade online.
This paper presents Zanzibar, a system for storing permissions and performing authorization checks based on the stored permissions. It is used by a wide array of services offered by Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Several of these services manage billions of objects on behalf of more than a billion users.
Este artigo apresenta o Zanzibar, um sistema para armazenar permissões e realizar verificações de autorização com base nas permissões armazenadas. Ele é usado por uma ampla variedade de serviços oferecidos pelo Google, incluindo Calendar, Cloud, Drive, Maps, Photos e YouTube. Vários desses serviços gerenciam bilhões de objetos em nome de mais de um bilhão de usuários.
A unified authorization system offers important advantages over maintaining separate access control mechanisms for individual applications. First, it helps establish consistent semantics and user experience across applications. Second, it makes it easier for applications to interoperate, for example, to coordinate access control when an object from one application embeds an object from another application. Third, useful common infrastructure can be built on top of a unified access control system, in particular, a search index that respects access control and works across applications. Finally, as we show below, authorization poses unique challenges involving data consistency and scalability. It saves engineering resources to tackle them once across applications.
Um sistema de autorização unificado oferece vantagens importantes em relação à manutenção de mecanismos de controle de acesso separados para aplicações individuais. Primeiro, ele ajuda a estabelecer semântica e experiência do usuário consistentes entre as aplicações. Segundo, ele facilita a interoperação entre aplicações, por exemplo, para coordenar o controle de acesso quando um objeto de uma aplicação incorpora um objeto de outra aplicação. Terceiro, uma infraestrutura comum útil pode ser construída sobre um sistema de controle de acesso unificado, em particular, um índice de busca que respeita o controle de acesso e funciona entre aplicações. Por fim, como mostramos a seguir, a autorização impõe desafios únicos envolvendo consistência de dados e escalabilidade. Enfrentá-los uma única vez para todas as aplicações economiza recursos de engenharia.
We have the following goals for the Zanzibar system:
Temos os seguintes objetivos para o sistema Zanzibar:
- Correctness: It must ensure consistency of access control decisions to respect user intentions.
- Flexibility: It must support a rich set of access control policies as required by both consumer and enterprise applications.
- Low latency: It must respond quickly because authorization checks are often in the critical path of user interactions. Low latency at the tail is particularly important for serving search results, which often require tens to hundreds of checks.
- High availability: It must reliably respond to requests because, in the absence of explicit authorizations, client services would be forced to deny their users access.
- Large scale: It needs to protect billions of objects shared by billions of users. It must be deployed around the globe to be near its clients and their end users.
- Corretude: ele deve garantir a consistência das decisões de controle de acesso para respeitar as intenções dos usuários.
- Flexibilidade: ele deve suportar um conjunto rico de políticas de controle de acesso, conforme exigido tanto por aplicações de consumo quanto por aplicações corporativas.
- Baixa latência: ele deve responder rapidamente, pois as verificações de autorização frequentemente estão no caminho crítico das interações dos usuários. Baixa latência na cauda é particularmente importante para servir resultados de busca, que frequentemente exigem de dezenas a centenas de verificações.
- Alta disponibilidade: ele deve responder às requisições de forma confiável, pois, na ausência de autorizações explícitas, os serviços clientes seriam forçados a negar acesso a seus usuários.
- Grande escala: ele precisa proteger bilhões de objetos compartilhados por bilhões de usuários. Ele deve ser implantado ao redor do globo para estar perto de seus clientes e dos usuários finais destes.
Zanzibar achieves these goals through a combination of notable features. To provide flexibility, Zanzibar pairs a simple data model with a powerful configuration language. The language allows clients to define arbitrary relations between users and objects, such as owner, editor, commenter, and viewer. It includes set-algebraic operators such as intersection and union for specifying potentially complex access control policies in terms of those user-object relations. For example, an application can specify that users granted editing rights on a document are also allowed to comment on the document, but not all commenters are given editing rights.
O Zanzibar atinge esses objetivos por meio de uma combinação de características notáveis. Para oferecer flexibilidade, o Zanzibar combina um modelo de dados simples com uma linguagem de configuração poderosa. A linguagem permite que os clientes definam relações arbitrárias entre usuários e objetos, como owner, editor, commenter e viewer. Ela inclui operadores de álgebra de conjuntos, como interseção e união, para especificar políticas de controle de acesso potencialmente complexas em termos dessas relações usuário-objeto. Por exemplo, uma aplicação pode especificar que usuários que receberam direitos de edição em um documento também podem comentar no documento, mas nem todos os comentaristas recebem direitos de edição.
At runtime, Zanzibar allows clients to create, modify, and evaluate access control lists (ACLs) through a remote procedure call (RPC) interface. A simple ACL takes the form of “user U has relation R to object O”. More complex ACLs take the form of “set of users S has relation R to object O”, where S is itself specified in terms of another object-relation pair. ACLs can thus refer to other ACLs, for example to specify that the set of users who can comment on a video consists of the users who have been granted viewing rights on that specific video along with those with viewing permissions on the video channel.
Em tempo de execução, o Zanzibar permite que os clientes criem, modifiquem e avaliem listas de controle de acesso (ACLs) por meio de uma interface de chamada de procedimento remoto (RPC). Uma ACL simples tem a forma “o usuário U tem a relação R com o objeto O”. ACLs mais complexas têm a forma “o conjunto de usuários S tem a relação R com o objeto O”, em que S é, por sua vez, especificado em termos de outro par objeto-relação. ACLs podem, assim, referir-se a outras ACLs, por exemplo, para especificar que o conjunto de usuários que podem comentar em um vídeo consiste nos usuários que receberam direitos de visualização sobre aquele vídeo específico, juntamente com aqueles que têm permissões de visualização sobre o canal do vídeo.
Group memberships are an important class of ACL where the object is a group and the relation is semantically equivalent to member. Groups can contain other groups, which illustrates one of the challenges facing Zanzibar, namely that evaluating whether a user belongs to a group can entail following a long chain of nested group memberships.
Associações a grupos são uma classe importante de ACL em que o objeto é um grupo e a relação é semanticamente equivalente a member. Grupos podem conter outros grupos, o que ilustra um dos desafios enfrentados pelo Zanzibar, a saber, que avaliar se um usuário pertence a um grupo pode implicar seguir uma longa cadeia de associações a grupos aninhados.
Authorization checks take the form of “does user U have relation R to object O?” and are evaluated by a collection of distributed servers. When a check request arrives to Zanzibar, the work to evaluate the check may fan out to multiple servers, for example when a group contains both individual members and other groups. Each of those servers may in turn contact other servers, for example to recursively traverse a hierarchy of group memberships.
As verificações de autorização têm a forma “o usuário U tem a relação R com o objeto O?” e são avaliadas por uma coleção de servidores distribuídos. Quando uma requisição de verificação chega ao Zanzibar, o trabalho de avaliar a verificação pode se espalhar por vários servidores, por exemplo, quando um grupo contém tanto membros individuais quanto outros grupos. Cada um desses servidores pode, por sua vez, contatar outros servidores, por exemplo, para percorrer recursivamente uma hierarquia de associações a grupos.
Zanzibar operates at a global scale along multiple dimensions. It stores more than two trillion ACLs and performs millions of authorization checks per second. The ACL data does not lend itself to geographic partitioning because authorization checks for any object can come from anywhere in the world. Therefore, Zanzibar replicates all ACL data in tens of geographically distributed data centers and distributes load across thousands of servers around the world.
O Zanzibar opera em escala global ao longo de múltiplas dimensões. Ele armazena mais de dois trilhões de ACLs e realiza milhões de verificações de autorização por segundo. Os dados de ACL não se prestam a particionamento geográfico, pois verificações de autorização para qualquer objeto podem vir de qualquer lugar do mundo. Portanto, o Zanzibar replica todos os dados de ACL em dezenas de data centers geograficamente distribuídos e distribui a carga entre milhares de servidores ao redor do mundo.
Zanzibar supports global consistency of access control decisions through two interrelated features. One, it respects the order in which ACL changes are committed to the underlying data store. Two, it can ensure that authorization checks are based on ACL data no older than a client-specified change. Thus, for example, a client can remove a user from a group and be assured that subsequent membership checks reflect that removal. Zanzibar provides these ordering properties by storing ACLs in a globally distributed database system with external consistency guarantees [15, 18].
O Zanzibar oferece consistência global das decisões de controle de acesso por meio de duas características inter-relacionadas. Primeiro, ele respeita a ordem em que as alterações de ACL são confirmadas no armazenamento de dados subjacente. Segundo, ele pode garantir que as verificações de autorização se baseiem em dados de ACL não mais antigos do que uma alteração especificada pelo cliente. Assim, por exemplo, um cliente pode remover um usuário de um grupo e ter a garantia de que as verificações de associação subsequentes refletirão essa remoção. O Zanzibar fornece essas propriedades de ordenação armazenando as ACLs em um sistema de banco de dados globalmente distribuído com garantias de consistência externa [15, 18].
Zanzibar employs an array of techniques to achieve low latency and high availability in this globally distributed environment. Its consistency protocol allows the vast majority of requests to be served with locally replicated data, without requiring cross-region round trips. Zanzibar stores its data in normalized forms for consistency. It handles hot spots on normalized data by caching final and intermediate results, and by deduplicating simultaneous requests. It also applies techniques such as hedging requests and optimizing computations on deeply nested sets with limited denormalization. Zanzibar responds to more than 95% of authorization checks within 10 milliseconds and has maintained more than 99.999% availability for the last 3 years.
O Zanzibar emprega um conjunto de técnicas para alcançar baixa latência e alta disponibilidade nesse ambiente globalmente distribuído. Seu protocolo de consistência permite que a grande maioria das requisições seja servida com dados replicados localmente, sem exigir viagens de ida e volta entre regiões. O Zanzibar armazena seus dados em formas normalizadas por questões de consistência. Ele lida com pontos quentes (hot spots) em dados normalizados armazenando em cache resultados finais e intermediários e deduplicando requisições simultâneas. Ele também aplica técnicas como hedging de requisições e otimização de computações sobre conjuntos profundamente aninhados com desnormalização limitada. O Zanzibar responde a mais de 95% das verificações de autorização em até 10 milissegundos e manteve disponibilidade superior a 99,999% nos últimos 3 anos.
The main contributions of this paper lie in conveying the engineering challenges in building and deploying a consistent, world-scale authorization system. While most elements of Zanzibar’s design have their roots in previous research, this paper provides a record of the features and techniques Zanzibar brings together to satisfy its stringent requirements for correctness, flexibility, latency, availability, and scalability. The paper also highlights lessons learned from operating Zanzibar in service of a diverse set of demanding clients.
As principais contribuições deste artigo consistem em transmitir os desafios de engenharia envolvidos na construção e implantação de um sistema de autorização consistente em escala mundial. Embora a maioria dos elementos do projeto do Zanzibar tenha raízes em pesquisas anteriores, este artigo fornece um registro das características e técnicas que o Zanzibar reúne para satisfazer seus rigorosos requisitos de corretude, flexibilidade, latência, disponibilidade e escalabilidade. O artigo também destaca lições aprendidas ao operar o Zanzibar a serviço de um conjunto diversificado de clientes exigentes.
This section describes Zanzibar’s data model, configuration language, and application programming interface (API).
Esta seção descreve o modelo de dados, a linguagem de configuração e a interface de programação de aplicações (API) do Zanzibar.
In Zanzibar, ACLs are collections of object-user or object-object relations represented as relation tuples. Groups are simply ACLs with membership semantics. Relation tuples have efficient binary encodings, but in this paper we represent them using a convenient text notation:
No Zanzibar, ACLs são coleções de relações objeto-usuário ou objeto-objeto representadas como tuplas de relação. Grupos são simplesmente ACLs com semântica de associação. As tuplas de relação têm codificações binárias eficientes, mas neste artigo nós as representamos usando uma notação textual conveniente:
where ⟨namespace⟩ and ⟨relation⟩ are predefined in client configurations (§2.3), ⟨object_id⟩ is a string, and ⟨user_id⟩ is an integer. The primary keys required to identify a relation tuple are ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩, and ⟨user⟩. One feature worth noting is that a ⟨userset⟩ allows ACLs to refer to groups and thus supports representing nested group membership.
em que ⟨namespace⟩ e ⟨relation⟩ são predefinidos nas configurações do cliente (§2.3), ⟨object_id⟩ é uma string e ⟨user_id⟩ é um inteiro. As chaves primárias necessárias para identificar uma tupla de relação são ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩ e ⟨user⟩. Uma característica digna de nota é que um ⟨userset⟩ permite que ACLs se refiram a grupos e, assim, possibilita representar associações a grupos aninhados.
Table 1 shows some example tuples and corresponding semantics. While some relations (e.g. viewer) define access control directly, others (e.g. parent, pointing to a folder) only define abstract relations between objects. These abstract relations may indirectly affect access control given userset rewrite rules specified in namespace configs (§2.3.1).
A Tabela 1 mostra alguns exemplos de tuplas e a semântica correspondente. Enquanto algumas relações (por exemplo, viewer) definem o controle de acesso diretamente, outras (por exemplo, parent, que aponta para uma pasta) apenas definem relações abstratas entre objetos. Essas relações abstratas podem afetar indiretamente o controle de acesso, dadas as regras de reescrita de userset especificadas nas configurações de namespace (§2.3.1).
Table 1: Example relation tuples. “#...” represents a relation that does not affect the semantics of the tuple.
Tabela 1: Exemplos de tuplas de relação. “#...” representa uma relação que não afeta a semântica da tupla.
Defining our data model around tuples, instead of per-object ACLs, allows us to unify the concepts of ACLs and groups and to support efficient reads and incremental updates, as we will see in §2.4.
Definir nosso modelo de dados em torno de tuplas, em vez de ACLs por objeto, permite-nos unificar os conceitos de ACLs e grupos e oferecer suporte a leituras eficientes e atualizações incrementais, como veremos na §2.4.
ACL checks must respect the order in which users modify ACLs and object contents to avoid unexpected sharing behaviors. Specifically, our clients care about preventing the “new enemy” problem, which can arise when we fail to respect the ordering between ACL updates or when we apply old ACLs to new content. Consider these two examples:
As verificações de ACL devem respeitar a ordem em que os usuários modificam as ACLs e o conteúdo dos objetos, a fim de evitar comportamentos de compartilhamento inesperados. Especificamente, nossos clientes se preocupam em evitar o problema do “novo inimigo”, que pode surgir quando deixamos de respeitar a ordenação entre atualizações de ACL ou quando aplicamos ACLs antigas a conteúdo novo. Considere estes dois exemplos:
Example A: Neglecting ACL update order
- Alice removes Bob from the ACL of a folder;
- Alice then asks Charlie to move new documents to the folder, where document ACLs inherit from folder ACLs;
- Bob should not be able to see the new documents, but may do so if the ACL check neglects the ordering between the two ACL changes.
Exemplo A: Negligenciar a ordem das atualizações de ACL
- Alice remove Bob da ACL de uma pasta;
- Em seguida, Alice pede a Charlie que mova novos documentos para a pasta, em que as ACLs dos documentos herdam das ACLs da pasta;
- Bob não deveria conseguir ver os novos documentos, mas poderá fazê-lo se a verificação de ACL negligenciar a ordenação entre as duas alterações de ACL.
Example B: Misapplying old ACL to new content
- Alice removes Bob from the ACL of a document;
- Alice then asks Charlie to add new contents to the document;
- Bob should not be able to see the new contents, but may do so if the ACL check is evaluated with a stale ACL from before Bob’s removal.
Exemplo B: Aplicar indevidamente uma ACL antiga a conteúdo novo
- Alice remove Bob da ACL de um documento;
- Em seguida, Alice pede a Charlie que adicione novo conteúdo ao documento;
- Bob não deveria conseguir ver o novo conteúdo, mas poderá fazê-lo se a verificação de ACL for avaliada com uma ACL desatualizada, anterior à remoção de Bob.
Preventing the “new enemy” problem requires Zanzibar to understand and respect the causal ordering between ACL or content updates, including updates on different ACLs or objects and those coordinated via channels invisible to Zanzibar. Hence Zanzibar must provide two key consistency properties: external consistency [18] and snapshot reads with bounded staleness.
Evitar o problema do “novo inimigo” exige que o Zanzibar compreenda e respeite a ordenação causal entre atualizações de ACL ou de conteúdo, incluindo atualizações em ACLs ou objetos diferentes e aquelas coordenadas por canais invisíveis ao Zanzibar. Portanto, o Zanzibar deve fornecer duas propriedades de consistência fundamentais: consistência externa [18] e leituras de snapshot com defasagem limitada.
External consistency allows Zanzibar to assign a timestamp to each ACL or content update, such that two causally related updates will be assigned timestamps that reflect the causal order: . With causally meaningful timestamps, a snapshot read of the ACL database at timestamp , which observes all updates with timestamps , will respect ordering between ACL updates. That is, if the read observes an update , it will observe all updates that happen causally before .
A consistência externa permite que o Zanzibar atribua um timestamp a cada atualização de ACL ou de conteúdo, de modo que duas atualizações causalmente relacionadas recebam timestamps que reflitam a ordem causal: . Com timestamps causalmente significativos, uma leitura de snapshot do banco de dados de ACLs no timestamp , que observa todas as atualizações com timestamps , respeitará a ordenação entre as atualizações de ACL. Ou seja, se a leitura observar uma atualização , ela observará todas as atualizações que acontecem causalmente antes de .
Furthermore, to avoid applying old ACLs to new contents, the ACL check evaluation snapshot must not be staler than the causal timestamp assigned to the content update. Given a content update at timestamp , a snapshot read at timestamp ensures that all ACL updates that happen causally before the content update will be observed by the ACL check.
Além disso, para evitar aplicar ACLs antigas a conteúdo novo, o snapshot de avaliação da verificação de ACL não deve ser mais defasado do que o timestamp causal atribuído à atualização de conteúdo. Dada uma atualização de conteúdo no timestamp , uma leitura de snapshot em um timestamp garante que todas as atualizações de ACL que acontecem causalmente antes da atualização de conteúdo serão observadas pela verificação de ACL.
To provide external consistency and snapshot reads with bounded staleness, we store ACLs in the Spanner global database system [15]. Spanner’s TrueTime mechanism assigns each ACL write a microsecond-resolution timestamp, such that the timestamps of writes reflect the causal ordering between writes, and thereby provide external consistency. We evaluate each ACL check at a single snapshot timestamp across multiple database reads, so that all writes with timestamps up to the check snapshot, and only those writes, are visible to the ACL check.
Para fornecer consistência externa e leituras de snapshot com defasagem limitada, armazenamos as ACLs no sistema de banco de dados global Spanner [15]. O mecanismo TrueTime do Spanner atribui a cada escrita de ACL um timestamp com resolução de microssegundos, de modo que os timestamps das escritas reflitam a ordenação causal entre elas e, com isso, forneçam consistência externa. Avaliamos cada verificação de ACL em um único timestamp de snapshot ao longo de múltiplas leituras do banco de dados, de modo que todas as escritas com timestamps até o snapshot da verificação, e somente essas escritas, sejam visíveis para a verificação de ACL.
To avoid evaluating checks for new contents using stale ACLs, one could try to always evaluate at the latest snapshot such that the check result reflects all ACL writes up to the check call. However, such evaluation would require global data synchronization with high-latency round trips and limited availability. Instead, we design the following protocol to allow most checks to be evaluated on already replicated data with cooperation from Zanzibar clients:
Para evitar avaliar verificações de conteúdo novo usando ACLs desatualizadas, poder-se-ia tentar avaliar sempre no snapshot mais recente, de modo que o resultado da verificação refletisse todas as escritas de ACL até a chamada da verificação. No entanto, tal avaliação exigiria sincronização global de dados com viagens de ida e volta de alta latência e disponibilidade limitada. Em vez disso, projetamos o seguinte protocolo para permitir que a maioria das verificações seja avaliada sobre dados já replicados, com a cooperação dos clientes do Zanzibar:
- A Zanzibar client requests an opaque consistency token called a zookie for each content version, via a content-change ACL check (§2.4.4) when the content modification is about to be saved. Zanzibar encodes a current global timestamp in the zookie and ensures that all prior ACL writes have lower timestamps. The client stores the zookie with the content change in an atomic write to the client storage. Note that the content-change check does not need to be evaluated in the same transaction as the application content modification, but only has to be triggered when the user modifies the contents.
- The client sends this zookie in subsequent ACL check requests to ensure that the check snapshot is at least as fresh as the timestamp for the content version.
- Um cliente do Zanzibar solicita um token de consistência opaco chamado zookie para cada versão de conteúdo, por meio de uma verificação de ACL de alteração de conteúdo (§2.4.4), quando a modificação de conteúdo está prestes a ser salva. O Zanzibar codifica um timestamp global atual no zookie e garante que todas as escritas de ACL anteriores tenham timestamps menores. O cliente armazena o zookie junto com a alteração de conteúdo em uma escrita atômica no armazenamento do cliente. Note que a verificação de alteração de conteúdo não precisa ser avaliada na mesma transação que a modificação de conteúdo da aplicação, mas apenas precisa ser disparada quando o usuário modifica o conteúdo.
- O cliente envia esse zookie nas requisições de verificação de ACL subsequentes para garantir que o snapshot da verificação seja pelo menos tão atual quanto o timestamp da versão do conteúdo.
External consistency and snapshot reads with staleness bounded by zookie prevent the “new enemy” problem. In Example A, ACL updates A1 and A2 will be assigned timestamps , respectively. Bob will not be able to see the new documents added by Charlie: if a check is evaluated at , the document ACLs will not include the folder ACL; if a check is evaluated at , the check will observe update A1, which removed Bob from the folder ACL. In Example B, Bob will not see the new contents added to the document. For Bob to see the new contents, the check must be evaluated with a zookie , the timestamp assigned to the content update. Because , such a check will also observe the ACL update B1, which removed Bob from the ACL.
A consistência externa e as leituras de snapshot com defasagem limitada pelo zookie evitam o problema do “novo inimigo”. No Exemplo A, as atualizações de ACL A1 e A2 receberão os timestamps , respectivamente. Bob não conseguirá ver os novos documentos adicionados por Charlie: se uma verificação for avaliada em , as ACLs dos documentos não incluirão a ACL da pasta; se uma verificação for avaliada em , a verificação observará a atualização A1, que removeu Bob da ACL da pasta. No Exemplo B, Bob não verá o novo conteúdo adicionado ao documento. Para que Bob veja o novo conteúdo, a verificação deve ser avaliada com um zookie , o timestamp atribuído à atualização de conteúdo. Como , tal verificação também observará a atualização de ACL B1, que removeu Bob da ACL.
The zookie protocol is a key feature of Zanzibar’s consistency model. It ensures that Zanzibar respects causal ordering between ACL and content updates, but otherwise grants Zanzibar freedom to choose evaluation timestamps so as to meet its latency and availability goals. The freedom arises from the protocol’s at-least-as-fresh semantics, which allow Zanzibar to choose any timestamp fresher than the one encoded in a zookie. Such freedom in turn allows Zanzibar to serve most checks at a default staleness with already replicated data (§3.2.1) and to quantize evaluation timestamps to avoid hot spots (§3.2.5).
O protocolo de zookie é uma característica fundamental do modelo de consistência do Zanzibar. Ele garante que o Zanzibar respeite a ordenação causal entre atualizações de ACL e de conteúdo, mas, fora isso, concede ao Zanzibar liberdade para escolher os timestamps de avaliação de modo a atingir seus objetivos de latência e disponibilidade. Essa liberdade decorre da semântica “pelo menos tão atual quanto” do protocolo, que permite ao Zanzibar escolher qualquer timestamp mais atual do que o codificado em um zookie. Essa liberdade, por sua vez, permite que o Zanzibar sirva a maioria das verificações com uma defasagem padrão usando dados já replicados (§3.2.1) e quantize os timestamps de avaliação para evitar pontos quentes (§3.2.5).
Before clients can store relation tuples in Zanzibar, they must configure their namespaces. A namespace configuration specifies its relations as well as its storage parameters. Each relation has a name, which is a client-defined string such as viewer or editor, and a relation config. Storage parameters include sharding settings and an encoding for object IDs that helps Zanzibar optimize storage of integer, string, and other object ID formats.
Antes que os clientes possam armazenar tuplas de relação no Zanzibar, eles precisam configurar seus namespaces (espaços de nomes). Uma configuração de namespace especifica suas relações, bem como seus parâmetros de armazenamento. Cada relação tem um nome, que é uma string definida pelo cliente, como viewer ou editor, e uma configuração de relação. Os parâmetros de armazenamento incluem configurações de sharding e uma codificação para IDs de objeto que ajuda o Zanzibar a otimizar o armazenamento de IDs de objeto em formato inteiro, string e outros.
While relation tuples reflect relationships between objects and users, they do not completely define the effective ACLs. For example, some clients specify that users with editor permissions on each object should have viewer permission on the same object. While such relationships between relations can be represented by a relation tuple per object, storing a tuple for each object in a namespace would be wasteful and make it hard to make modifications across all objects. Instead, we let clients define object-agnostic relationships via userset rewrite rules in relation configs. Figure 1 demonstrates a simple namespace configuration with concentric relations, where viewer contains editor, and editor contains owner.
Embora as tuplas de relação reflitam relacionamentos entre objetos e usuários, elas não definem completamente as ACLs efetivas. Por exemplo, alguns clientes especificam que usuários com permissões de editor em cada objeto devem ter permissão de viewer sobre o mesmo objeto. Embora tais relacionamentos entre relações possam ser representados por uma tupla de relação por objeto, armazenar uma tupla para cada objeto em um namespace seria um desperdício e dificultaria fazer modificações em todos os objetos. Em vez disso, permitimos que os clientes definam relacionamentos independentes de objeto por meio de regras de reescrita de userset nas configurações de relação. A Figura 1 demonstra uma configuração de namespace simples com relações concêntricas, em que viewer contém editor, e editor contém owner.
Figure 1: Simple namespace configuration with concentric relations on documents. All owners are editors, and all editors are viewers. Further, viewers of the parent folder are also viewers of the document.
Figura 1: Configuração de namespace simples com relações concêntricas sobre documentos. Todos os donos são editores, e todos os editores são visualizadores. Além disso, os visualizadores da pasta pai também são visualizadores do documento.
Userset rewrite rules are defined per relation in a namespace. Each rule specifies a function that takes an object ID as input and outputs a userset expression tree. Each leaf node of the tree can be any of the following:
As regras de reescrita de userset são definidas por relação em um namespace. Cada regra especifica uma função que recebe um ID de objeto como entrada e produz como saída uma árvore de expressão de userset. Cada nó folha da árvore pode ser qualquer um dos seguintes:
_this: Returns all users from stored relation tuples for the ⟨object#relation⟩ pair, including indirect ACLs referenced by usersets from the tuples. This is the default behavior when no rewrite rule is specified.computed_userset: Computes, for the input object, a new userset. For example, this allows the userset expression for aviewerrelation to refer to theeditoruserset on the same object, thus offering an ACL inheritance capability between relations.tuple_to_userset: Computes a tupleset (§2.4.1) from the input object, fetches relation tuples matching the tupleset, and computes a userset from every fetched relation tuple. This flexible primitive allows our clients to express complex policies such as “look up the parent folder of the document and inherit its viewers”.
_this: retorna todos os usuários das tuplas de relação armazenadas para o par ⟨object#relation⟩, incluindo ACLs indiretas referenciadas por usersets das tuplas. Este é o comportamento padrão quando nenhuma regra de reescrita é especificada.computed_userset: calcula, para o objeto de entrada, um novo userset. Por exemplo, isso permite que a expressão de userset de uma relaçãoviewerse refira ao userseteditorsobre o mesmo objeto, oferecendo assim uma capacidade de herança de ACL entre relações.tuple_to_userset: calcula um conjunto de tuplas (tupleset) (§2.4.1) a partir do objeto de entrada, busca as tuplas de relação que correspondem ao tupleset e calcula um userset a partir de cada tupla de relação obtida. Essa primitiva flexível permite que nossos clientes expressem políticas complexas, como “procure a pasta pai do documento e herde seus visualizadores”.
A userset expression can also be composed of multiple sub-expressions, combined by operations such as union, intersection, and exclusion.
Uma expressão de userset também pode ser composta de múltiplas subexpressões, combinadas por operações como união, interseção e exclusão.
In addition to supporting ACL checks, Zanzibar also provides APIs for clients to read and write relation tuples, watch tuple updates, and inspect the effective ACLs.
Além de oferecer suporte a verificações de ACL, o Zanzibar também fornece APIs para que os clientes leiam e escrevam tuplas de relação, observem atualizações de tuplas e inspecionem as ACLs efetivas.
A concept used throughout these API methods is that of a zookie. A zookie is an opaque byte sequence encoding a globally meaningful timestamp that reflects an ACL write, a client content version, or a read snapshot. Zookies in ACL read and check requests specify staleness bounds for snapshot reads, thus providing one of Zanzibar’s core consistency properties. We choose to use an opaque cookie instead of the actual timestamp to discourage our clients from choosing arbitrary timestamps and to allow future extensions.
Um conceito usado em todos esses métodos da API é o de zookie. Um zookie é uma sequência de bytes opaca que codifica um timestamp globalmente significativo que reflete uma escrita de ACL, uma versão de conteúdo do cliente ou um snapshot de leitura. Zookies em requisições de leitura e verificação de ACL especificam limites de defasagem para leituras de snapshot, fornecendo assim uma das propriedades de consistência centrais do Zanzibar. Optamos por usar um cookie opaco em vez do timestamp real para desencorajar nossos clientes de escolher timestamps arbitrários e para permitir extensões futuras.
Our clients read relation tuples to display ACLs or group membership to users, or to prepare for a subsequent write. A read request specifies one or multiple tuplesets and an optional zookie.
Nossos clientes leem tuplas de relação para exibir ACLs ou associações a grupos aos usuários, ou para se preparar para uma escrita subsequente. Uma requisição de leitura especifica um ou vários conjuntos de tuplas (tuplesets) e um zookie opcional.
Each tupleset specifies keys of a set of relation tuples. The set can include a single tuple key, or all tuples with a given object ID or userset in a namespace, optionally constrained by a relation name. With the tuplesets, clients can look up a specific membership entry, read all entries in an ACL or group, or look up all groups with a given user as a direct member. All tuplesets in a read request are processed at a single snapshot.
Cada conjunto de tuplas especifica chaves de um conjunto de tuplas de relação. O conjunto pode incluir uma única chave de tupla, ou todas as tuplas com um dado ID de objeto ou userset em um namespace, opcionalmente restritas por um nome de relação. Com os conjuntos de tuplas, os clientes podem consultar uma entrada de associação específica, ler todas as entradas de uma ACL ou grupo, ou consultar todos os grupos que têm um dado usuário como membro direto. Todos os conjuntos de tuplas de uma requisição de leitura são processados em um único snapshot.
With the zookie, clients can request a read snapshot no earlier than a previous write if the zookie from the write response is given in the read request, or at the same snapshot as a previous read if the zookie from the earlier read response is given in the subsequent request. If the request doesn’t contain a zookie, Zanzibar will choose a reasonably recent snapshot, possibly offering a lower-latency response than if a zookie were provided.
Com o zookie, os clientes podem solicitar um snapshot de leitura não anterior a uma escrita prévia, se o zookie da resposta da escrita for fornecido na requisição de leitura, ou no mesmo snapshot de uma leitura prévia, se o zookie da resposta da leitura anterior for fornecido na requisição subsequente. Se a requisição não contiver um zookie, o Zanzibar escolherá um snapshot razoavelmente recente, possivelmente oferecendo uma resposta de menor latência do que se um zookie tivesse sido fornecido.
Read results only depend on contents of relation tuples and do not reflect userset rewrite rules. For example, even if the viewer userset always includes the owner userset, reading tuples with the viewer relation will not return tuples with the owner relation. Clients that need to understand the effective userset can use the Expand API (§2.4.5).
Os resultados de leitura dependem apenas do conteúdo das tuplas de relação e não refletem as regras de reescrita de userset. Por exemplo, mesmo que o userset viewer sempre inclua o userset owner, ler tuplas com a relação viewer não retornará tuplas com a relação owner. Clientes que precisam entender o userset efetivo podem usar a API Expand (§2.4.5).
Clients may modify a single relation tuple to add or remove an ACL. They may also modify all tuples related to an object via a read-modify-write process with optimistic concurrency control [21] that uses a read RPC followed by a write RPC:
Os clientes podem modificar uma única tupla de relação para adicionar ou remover uma ACL. Eles também podem modificar todas as tuplas relacionadas a um objeto por meio de um processo de leitura-modificação-escrita com controle de concorrência otimista [21] que usa uma RPC de leitura seguida de uma RPC de escrita:
- Read all relation tuples of an object, including a per-object “lock” tuple.
- Generate the tuples to write or delete. Send the writes, along with a touch on the lock tuple, to Zanzibar, with the condition that the writes will be committed only if the lock tuple has not been modified since the read.
- If the write condition is not met, go back to step 1.
- Ler todas as tuplas de relação de um objeto, incluindo uma tupla de “bloqueio” por objeto.
- Gerar as tuplas a escrever ou excluir. Enviar as escritas, junto com um toque na tupla de bloqueio, ao Zanzibar, com a condição de que as escritas só serão confirmadas se a tupla de bloqueio não tiver sido modificada desde a leitura.
- Se a condição de escrita não for satisfeita, voltar ao passo 1.
The lock tuple is just a regular relation tuple used by clients to detect write races.
A tupla de bloqueio é apenas uma tupla de relação comum, usada pelos clientes para detectar condições de corrida de escrita.
Some clients maintain secondary indices of relation tuples in Zanzibar. They can do so with our Watch API. A watch request specifies one or more namespaces and a zookie representing the time to start watching. A watch response contains all tuple modification events in ascending timestamp order, from the requested start timestamp to a timestamp encoded in a heartbeat zookie included in the watch response. The client can use the heartbeat zookie to resume watching where the previous watch response left off.
Alguns clientes mantêm índices secundários de tuplas de relação no Zanzibar. Eles podem fazer isso com nossa API Watch. Uma requisição de watch especifica um ou mais namespaces e um zookie que representa o momento a partir do qual observar. Uma resposta de watch contém todos os eventos de modificação de tuplas em ordem crescente de timestamp, desde o timestamp inicial solicitado até um timestamp codificado em um zookie de heartbeat incluído na resposta de watch. O cliente pode usar o zookie de heartbeat para retomar a observação de onde a resposta de watch anterior parou.
A check request specifies a userset, represented by ⟨object#relation⟩, a putative user, often represented by an authentication token, and a zookie corresponding to the desired object version. Like reads, a check is always evaluated at a consistent snapshot no earlier than the given zookie.
Uma requisição de verificação especifica um userset, representado por ⟨object#relation⟩, um suposto usuário, frequentemente representado por um token de autenticação, e um zookie correspondente à versão desejada do objeto. Assim como as leituras, uma verificação é sempre avaliada em um snapshot consistente não anterior ao zookie fornecido.
To authorize application content modifications, our clients send a special type of check request, a content-change check. A content-change check request does not carry a zookie and is evaluated at the latest snapshot. If a content change is authorized, the check response includes a zookie for clients to store along with object contents and use for subsequent checks of the content version. The zookie encodes the evaluation snapshot and captures any possible causality from ACL changes to content changes, because the zookie’s timestamp will be greater than that of the ACL updates that protect the new content (§2.2).
Para autorizar modificações de conteúdo da aplicação, nossos clientes enviam um tipo especial de requisição de verificação, uma verificação de alteração de conteúdo. Uma requisição de verificação de alteração de conteúdo não carrega um zookie e é avaliada no snapshot mais recente. Se uma alteração de conteúdo for autorizada, a resposta da verificação inclui um zookie para que os clientes o armazenem junto com o conteúdo do objeto e o usem em verificações subsequentes dessa versão do conteúdo. O zookie codifica o snapshot de avaliação e captura qualquer causalidade possível das alterações de ACL para as alterações de conteúdo, pois o timestamp do zookie será maior do que o das atualizações de ACL que protegem o novo conteúdo (§2.2).
The Expand API returns the effective userset given an ⟨object#relation⟩ pair and an optional zookie. Unlike the Read API, Expand follows indirect references expressed through userset rewrite rules. The result is represented by a userset tree whose leaf nodes are user IDs or usersets pointing to other ⟨object#relation⟩ pairs, and intermediate nodes represent union, intersection, or exclusion operators. Expand is crucial for our clients to reason about the complete set of users and groups that have access to their objects, which allows them to build efficient search indices for access-controlled content.
A API Expand retorna o userset efetivo, dado um par ⟨object#relation⟩ e um zookie opcional. Diferentemente da API Read, a Expand segue as referências indiretas expressas por meio de regras de reescrita de userset. O resultado é representado por uma árvore de userset cujos nós folha são IDs de usuário ou usersets que apontam para outros pares ⟨object#relation⟩, e cujos nós intermediários representam operadores de união, interseção ou exclusão. A Expand é crucial para que nossos clientes raciocinem sobre o conjunto completo de usuários e grupos que têm acesso a seus objetos, o que lhes permite construir índices de busca eficientes para conteúdo com controle de acesso.
Figure 2 shows the architecture of the Zanzibar system. aclservers are the main server type. They are organized in clusters and respond to Check, Read, Expand, and Write requests. Requests arrive at any server in a cluster and that server fans out the work to other servers in the cluster as necessary. Those servers may in turn contact other servers to compute intermediate results. The initial server gathers the final result and returns it to the client.
A Figura 2 mostra a arquitetura do sistema Zanzibar. Os aclservers são o principal tipo de servidor. Eles são organizados em clusters e respondem a requisições Check, Read, Expand e Write. As requisições chegam a qualquer servidor de um cluster, e esse servidor distribui o trabalho para outros servidores do cluster conforme necessário. Esses servidores podem, por sua vez, contatar outros servidores para calcular resultados intermediários. O servidor inicial reúne o resultado final e o retorna ao cliente.
Zanzibar stores ACLs and their metadata in Spanner databases. There is one database to store relation tuples for each client namespace, one database to hold all namespace configurations, and one changelog database shared across all namespaces. aclservers read and write those databases in the course of responding to client requests.
O Zanzibar armazena as ACLs e seus metadados em bancos de dados Spanner. Há um banco de dados para armazenar as tuplas de relação de cada namespace de cliente, um banco de dados para guardar todas as configurações de namespace e um banco de dados de log de alterações (changelog) compartilhado por todos os namespaces. Os aclservers leem e escrevem nesses bancos de dados no decorrer do atendimento às requisições dos clientes.
watchservers are a specialized server type that respond to Watch requests. They tail the changelog and serve a stream of namespace changes to clients in near real time.
Os watchservers são um tipo especializado de servidor que responde a requisições Watch. Eles acompanham o final do log de alterações e servem aos clientes um fluxo de alterações de namespace quase em tempo real.
Zanzibar periodically runs a data processing pipeline to perform a variety of offline functions across all Zanzibar data in Spanner. One such function is to produce dumps of the relation tuples in each namespace at a known snapshot timestamp. Another is to garbage-collect tuple versions older than a threshold configured per namespace.
O Zanzibar executa periodicamente um pipeline de processamento de dados para realizar uma variedade de funções offline sobre todos os dados do Zanzibar no Spanner. Uma dessas funções é produzir dumps das tuplas de relação de cada namespace em um timestamp de snapshot conhecido. Outra é coletar como lixo as versões de tuplas mais antigas do que um limite configurado por namespace.
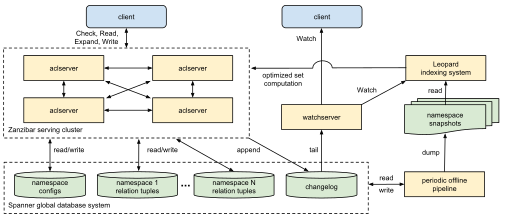
Figure 2: Zanzibar architecture. Arrows indicate the direction of data flow.
Figura 2: Arquitetura do Zanzibar. As setas indicam a direção do fluxo de dados.
Leopard is an indexing system used to optimize operations on large and deeply nested sets. It reads periodic snapshots of ACL data and watches for changes between snapshots. It performs transformations on that data, such as denormalization, and responds to requests from aclservers.
O Leopard é um sistema de indexação usado para otimizar operações sobre conjuntos grandes e profundamente aninhados. Ele lê snapshots periódicos dos dados de ACL e observa as alterações entre snapshots. Ele realiza transformações sobre esses dados, como desnormalização, e responde a requisições dos aclservers.
The rest of this section presents the implementation of these architectural elements in more detail.
O restante desta seção apresenta a implementação desses elementos arquiteturais em mais detalhes.
We store relation tuples of each namespace in a separate database, where each row is identified by primary key (shard ID, object ID, relation, user, commit timestamp). Multiple tuple versions are stored on different rows, so that we can evaluate checks and reads at any timestamp within the garbage collection window. The ordering of primary keys allows us to look up all relation tuples for a given object ID or (object ID, relation) pair.
Armazenamos as tuplas de relação de cada namespace em um banco de dados separado, em que cada linha é identificada pela chave primária (ID do shard, ID do objeto, relação, usuário, timestamp de commit). Múltiplas versões de tuplas são armazenadas em linhas diferentes, de modo que podemos avaliar verificações e leituras em qualquer timestamp dentro da janela de coleta de lixo. A ordenação das chaves primárias nos permite consultar todas as tuplas de relação de um dado ID de objeto ou par (ID do objeto, relação).
Our clients configure sharding of a namespace according to its data pattern. Usually the shard ID is determined solely by the object ID. In some cases, for example, when a namespace stores groups with very large numbers of members, the shard ID is computed from both object ID and user.
Nossos clientes configuram o sharding de um namespace de acordo com seu padrão de dados. Normalmente, o ID do shard é determinado unicamente pelo ID do objeto. Em alguns casos, por exemplo, quando um namespace armazena grupos com números muito grandes de membros, o ID do shard é calculado a partir tanto do ID do objeto quanto do usuário.
Zanzibar also maintains a changelog database that stores a history of tuple updates for the Watch API. The primary keys are (changelog shard ID, timestamp, unique update ID), where a changelog shard is randomly selected for each write.
O Zanzibar também mantém um banco de dados de log de alterações que armazena um histórico das atualizações de tuplas para a API Watch. As chaves primárias são (ID do shard do log de alterações, timestamp, ID único da atualização), em que um shard do log de alterações é selecionado aleatoriamente para cada escrita.
Every Zanzibar write is committed to both the tuple storage and the changelog shard in a single transaction. We designate the Spanner server hosting the changelog shard as the transaction coordinator to minimize blocking of changelog reads on pending transactions.
Toda escrita do Zanzibar é confirmada tanto no armazenamento de tuplas quanto no shard do log de alterações em uma única transação. Designamos o servidor Spanner que hospeda o shard do log de alterações como coordenador da transação, para minimizar o bloqueio de leituras do log de alterações por transações pendentes.
Namespace configs are stored in a database with two tables. One table contains the configs and is keyed by namespace IDs. The other is a changelog of config updates and is keyed by commit timestamps. This structure allows a Zanzibar server to load all configs upon startup and monitor the changelog to refresh configs continuously.
As configurações de namespace são armazenadas em um banco de dados com duas tabelas. Uma tabela contém as configurações e é indexada pelos IDs de namespace. A outra é um log de alterações das atualizações de configuração e é indexada pelos timestamps de commit. Essa estrutura permite que um servidor do Zanzibar carregue todas as configurações na inicialização e monitore o log de alterações para atualizar as configurações continuamente.
To reduce latency, Zanzibar data is replicated to be close to our clients. Replicas exist in dozens of locations around the world, with multiple replicas per region. The 5 voting replicas are in eastern and central United States, in 3 different metropolitan areas to isolate failures but within 25 milliseconds of each other so that Paxos transactions commit quickly.
Para reduzir a latência, os dados do Zanzibar são replicados para ficar perto de nossos clientes. Há réplicas em dezenas de localidades ao redor do mundo, com múltiplas réplicas por região. As 5 réplicas votantes ficam no leste e no centro dos Estados Unidos, em 3 áreas metropolitanas diferentes para isolar falhas, mas a até 25 milissegundos umas das outras, para que as transações Paxos sejam confirmadas rapidamente.
As noted in §2.4, clients can provide zookies to ensure a minimum snapshot timestamp for request evaluation. When a zookie is not provided, the server uses a default staleness chosen to ensure that all transactions are evaluated at a timestamp that is as recent as possible without impacting latency.
Como observado na §2.4, os clientes podem fornecer zookies para garantir um timestamp mínimo de snapshot para a avaliação da requisição. Quando um zookie não é fornecido, o servidor usa uma defasagem padrão escolhida para garantir que todas as transações sejam avaliadas em um timestamp tão recente quanto possível sem impactar a latência.
On each read request it makes to Spanner, Zanzibar receives a hint about whether or not the data at that timestamp required an out-of-zone read and thus incurred additional latency. Each server tracks the frequency of such out-of-zone reads for data at a default staleness as well as for fresher and staler data, and uses these frequencies to compute a binomial proportion confidence interval of the probability that any given piece of data is available locally at each staleness.
Em cada requisição de leitura que faz ao Spanner, o Zanzibar recebe uma indicação sobre se os dados naquele timestamp exigiram ou não uma leitura fora da zona e, portanto, incorreram em latência adicional. Cada servidor acompanha a frequência dessas leituras fora da zona para dados com a defasagem padrão, bem como para dados mais atuais e mais defasados, e usa essas frequências para calcular um intervalo de confiança de proporção binomial da probabilidade de que qualquer dado específico esteja disponível localmente em cada nível de defasagem.
Upon collecting enough data, the server checks to see if each staleness value has a sufficiently low probability of incurring an out-of-zone read, and thus will be low-latency. If so, it updates the default staleness bound to the lowest “safe” value. If no known staleness values are safe, we use a two-proportion z-test to see if increasing the default will be a statistically significant amount safer. In that case, we increase the default value in the hopes of improving latency. This default staleness mechanism is purely a performance optimization. It does not violate consistency semantics because Zanzibar always respects zookies when provided.
Após coletar dados suficientes, o servidor verifica se cada valor de defasagem tem uma probabilidade suficientemente baixa de incorrer em uma leitura fora da zona e, portanto, terá baixa latência. Em caso afirmativo, ele atualiza o limite de defasagem padrão para o menor valor “seguro”. Se nenhum valor de defasagem conhecido for seguro, usamos um teste z de duas proporções para verificar se aumentar o padrão o tornará mais seguro em uma quantidade estatisticamente significativa. Nesse caso, aumentamos o valor padrão na esperança de melhorar a latência. Esse mecanismo de defasagem padrão é puramente uma otimização de desempenho. Ele não viola a semântica de consistência, pois o Zanzibar sempre respeita os zookies quando fornecidos.
Because changes to namespace configs can change the results of ACL evaluations, and therefore their correctness, Zanzibar chooses a single snapshot timestamp for config metadata when evaluating each client request. All aclservers in a cluster use that same timestamp for the same request, including for any subrequests that fan out from the original client request.
Como alterações nas configurações de namespace podem mudar os resultados das avaliações de ACL e, portanto, sua corretude, o Zanzibar escolhe um único timestamp de snapshot para os metadados de configuração ao avaliar cada requisição de cliente. Todos os aclservers de um cluster usam esse mesmo timestamp para a mesma requisição, inclusive para quaisquer sub-requisições que se ramifiquem a partir da requisição original do cliente.
Each server independently loads namespace configs from storage continuously as they change (§3.1.3). Therefore, each server in a cluster may have access to a different range of config timestamps due to restarts or network latency. Zanzibar must pick a timestamp that is available across all of them. To facilitate this, a monitoring job tracks the timestamp range available to every server and aggregates them, reporting a globally available range to every other server. On each incoming request the server picks a time from this range, ensuring that all servers can continue serving even if they are no longer able to read from the config storage.
Cada servidor carrega de forma independente e contínua as configurações de namespace do armazenamento à medida que elas mudam (§3.1.3). Portanto, cada servidor de um cluster pode ter acesso a um intervalo diferente de timestamps de configuração, devido a reinicializações ou à latência da rede. O Zanzibar precisa escolher um timestamp que esteja disponível em todos eles. Para facilitar isso, um job de monitoramento acompanha o intervalo de timestamps disponível para cada servidor e os agrega, informando um intervalo globalmente disponível a todos os demais servidores. Em cada requisição recebida, o servidor escolhe um momento desse intervalo, garantindo que todos os servidores possam continuar atendendo mesmo que não consigam mais ler do armazenamento de configurações.
Zanzibar evaluates ACL checks by converting check requests to boolean expressions. In a simple case, when there are no userset rewrite rules, checking a user against a userset ⟨object#relation⟩ can be expressed as
O Zanzibar avalia as verificações de ACL convertendo as requisições de verificação em expressões booleanas. Em um caso simples, quando não há regras de reescrita de userset, verificar um usuário em relação a um userset ⟨object#relation⟩ pode ser expresso como
Finding a valid involves evaluating membership on all indirect ACLs or groups, recursively. This kind of “pointer chasing” works well for most types of ACLs and groups, but can be expensive when indirect ACLs or groups are deep or wide. §3.2.4 explains how we handle this problem. Userset rewrite rules are also translated to boolean expressions as part of check evaluation.
Encontrar um válido envolve avaliar a associação em todas as ACLs ou grupos indiretos, recursivamente. Esse tipo de “perseguição de ponteiros” funciona bem para a maioria dos tipos de ACLs e grupos, mas pode ser custoso quando as ACLs ou grupos indiretos são profundos ou largos. A §3.2.4 explica como lidamos com esse problema. As regras de reescrita de userset também são traduzidas em expressões booleanas como parte da avaliação da verificação.
To minimize check latency, we evaluate all leaf nodes of the boolean expression tree concurrently. When the outcome of one node determines the result of a subtree, evaluation of other nodes in the subtree is cancelled.
Para minimizar a latência das verificações, avaliamos todos os nós folha da árvore de expressão booleana concorrentemente. Quando o resultado de um nó determina o resultado de uma subárvore, a avaliação dos demais nós da subárvore é cancelada.
Evaluation of leaf nodes usually involves reading relation tuples from databases. We apply a pooling mechanism to group reads for the same ACL check to minimize the number of read RPCs to Spanner.
A avaliação dos nós folha normalmente envolve ler tuplas de relação dos bancos de dados. Aplicamos um mecanismo de agrupamento (pooling) para reunir as leituras de uma mesma verificação de ACL, a fim de minimizar o número de RPCs de leitura ao Spanner.
Recursive pointer chasing during check evaluation has difficulty maintaining low latency with groups that are deeply nested or have a large number of child groups. For selected namespaces that exhibit such structure, Zanzibar handles checks using Leopard, a specialized index that supports efficient set computation.
A perseguição recursiva de ponteiros durante a avaliação de verificações tem dificuldade em manter baixa latência com grupos que são profundamente aninhados ou que têm um grande número de grupos filhos. Para namespaces selecionados que exibem tal estrutura, o Zanzibar processa as verificações usando o Leopard, um índice especializado que oferece suporte à computação eficiente de conjuntos.
A Leopard index represents a collection of named sets using tuples, where is an enum representing the set type and and are 64-bit integers representing the set ID and the element ID, respectively. A query evaluates an expression of union, intersection, or exclusion of named sets and returns the result set ordered by the element ID up to a specified number of results.
Um índice Leopard representa uma coleção de conjuntos nomeados usando tuplas , em que é um enum que representa o tipo do conjunto e e são inteiros de 64 bits que representam o ID do conjunto e o ID do elemento, respectivamente. Uma consulta avalia uma expressão de união, interseção ou exclusão de conjuntos nomeados e retorna o conjunto resultante ordenado pelo ID do elemento, até um número especificado de resultados.
To index and evaluate group membership, Zanzibar represents group membership with two set types, and , which we show here as functions mapping from a set ID to element IDs:
Para indexar e avaliar a associação a grupos, o Zanzibar representa a associação a grupos com dois tipos de conjunto, e , que mostramos aqui como funções que mapeiam um ID de conjunto para IDs de elemento:
- , where represents an ancestor group and represents a descendent group that is directly or indirectly a sub-group of the ancestor group.
- , where represents an individual user and represents a parent group in which the user is a direct member.
- , em que representa um grupo ancestral e representa um grupo descendente que é, direta ou indiretamente, um subgrupo do grupo ancestral.
- , em que representa um usuário individual e representa um grupo pai do qual o usuário é membro direto.
To evaluate whether user is a member of group , we check whether
Para avaliar se o usuário é membro do grupo , verificamos se
Group membership can be considered as a reachability problem in a graph, where nodes represent groups and users and edges represent direct membership. Flattening group-to-group paths allows reachability to be efficently evaluated by Leopard, though other types of denormalization can also be applied as data patterns demand.
A associação a grupos pode ser considerada um problema de alcançabilidade em um grafo, em que os nós representam grupos e usuários e as arestas representam associação direta. Achatar os caminhos de grupo para grupo permite que a alcançabilidade seja avaliada eficientemente pelo Leopard, embora outros tipos de desnormalização também possam ser aplicados conforme os padrões de dados exigirem.
The Leopard system consists of three discrete parts: a serving system capable of consistent and low-latency operations across sets; an offline, periodic index building system; and an online real-time layer capable of continuously updating the serving system as tuple changes occur.
O sistema Leopard consiste em três partes distintas: um sistema de atendimento capaz de realizar operações consistentes e de baixa latência sobre conjuntos; um sistema offline e periódico de construção de índices; e uma camada online de tempo real capaz de atualizar continuamente o sistema de atendimento à medida que ocorrem alterações nas tuplas.
Index tuples are stored as ordered lists of integers in a structure such as a skip list, thus allowing for efficient union and intersections among sets. For example, evaluating the intersection between two sets, and , requires only skip-list seeks. The index is sharded by element IDs and can be distributed across multiple servers. Shards are usually served entirely from memory, but they can also be served from a mix of hot and cold data spread between memory and remote solid-state devices.
As tuplas do índice são armazenadas como listas ordenadas de inteiros em uma estrutura como uma skip list, permitindo assim união e interseções eficientes entre conjuntos. Por exemplo, avaliar a interseção entre dois conjuntos, e , exige apenas buscas na skip list. O índice é particionado em shards por IDs de elemento e pode ser distribuído entre múltiplos servidores. Os shards normalmente são servidos inteiramente a partir da memória, mas também podem ser servidos a partir de uma mistura de dados quentes e frios, distribuídos entre a memória e dispositivos de estado sólido remotos.
The offline index builder generates index shards from a snapshot of Zanzibar relation tuples and configs, and replicates the shards globally. It respects userset rewrite rules and recursively expands edges in an ACL graph to form Leopard index tuples. The Leopard servers continously watch for new shards and swap old shards with new ones when they become available.
O construtor de índices offline gera shards do índice a partir de um snapshot das tuplas de relação e das configurações do Zanzibar e replica os shards globalmente. Ele respeita as regras de reescrita de userset e expande recursivamente as arestas de um grafo de ACL para formar as tuplas do índice Leopard. Os servidores Leopard observam continuamente o surgimento de novos shards e substituem os shards antigos pelos novos quando estes ficam disponíveis.
The Leopard system described thus far is able to efficiently evaluate deeply and widely nested group membership, but cannot do so at a fresh and consistent snapshot due to offline index generation and shard swapping. To support consistent ACL evaluation, Leopard servers maintain an incremental layer that indexes all updates since the offline snapshot, where each update is represented by a tuple, where is the timestamp of the update and is a deletion marker. Updates with timestamps less than or equal to the query timestamp are merged on top of the offline index during query processing.
O sistema Leopard descrito até aqui é capaz de avaliar eficientemente associações a grupos profunda e amplamente aninhados, mas não consegue fazê-lo em um snapshot atual e consistente, devido à geração offline do índice e à substituição de shards. Para oferecer suporte à avaliação consistente de ACLs, os servidores Leopard mantêm uma camada incremental que indexa todas as atualizações desde o snapshot offline, em que cada atualização é representada por uma tupla , em que é o timestamp da atualização e é um marcador de exclusão. As atualizações com timestamps menores ou iguais ao timestamp da consulta são mescladas sobre o índice offline durante o processamento da consulta.
To maintain the incremental layer, the Leopard incremental indexer calls Zanzibar’s Watch API to receive a temporally ordered stream of Zanzibar tuple modifications and transforms the updates into a temporally ordered stream of Leopard tuple additions, updates, and deletions. Generating updates for the tuples requires the incremental indexer to maintain group-to-group membership for denormalizing the effects of a relation tuple update to potentially multiple index updates.
Para manter a camada incremental, o indexador incremental do Leopard chama a API Watch do Zanzibar para receber um fluxo temporalmente ordenado de modificações de tuplas do Zanzibar e transforma as atualizações em um fluxo temporalmente ordenado de adições, atualizações e exclusões de tuplas do Leopard. Gerar atualizações para as tuplas exige que o indexador incremental mantenha a associação de grupo para grupo, a fim de desnormalizar os efeitos de uma atualização de tupla de relação em potencialmente múltiplas atualizações do índice.
In practice, a single Zanzibar tuple addition or deletion may yield potentially tens of thousands of discrete Leopard tuple events. Each Leopard serving instance receives the complete stream of these Zanzibar tuple changes through the Watch API. The Leopard serving system is designed to continuously ingest this stream and update its various posting lists with minimal impact to query serving.
Na prática, uma única adição ou exclusão de tupla do Zanzibar pode gerar potencialmente dezenas de milhares de eventos distintos de tuplas do Leopard. Cada instância de atendimento do Leopard recebe o fluxo completo dessas alterações de tuplas do Zanzibar por meio da API Watch. O sistema de atendimento do Leopard é projetado para ingerir continuamente esse fluxo e atualizar suas várias listas de postings com impacto mínimo no atendimento às consultas.
The workload of ACL reads and checks is often bursty and subject to hot spots. For example, answering a search query requires conducting ACL checks for all candidate results, whose ACLs often share common groups or indirect ACLs. To facilitate consistency, Zanzibar avoids storage denormalization and relies only on normalized data (except for the cases described in §3.2.4). With normalized data, hot spots on common ACLs (e.g., popular groups) may overload the underlying database servers. We found the handling of hot spots to be the most critical frontier in our pursuit of low latency and high availability.
A carga de trabalho de leituras e verificações de ACL frequentemente ocorre em rajadas e está sujeita a pontos quentes. Por exemplo, responder a uma consulta de busca exige realizar verificações de ACL para todos os resultados candidatos, cujas ACLs frequentemente compartilham grupos comuns ou ACLs indiretas. Para facilitar a consistência, o Zanzibar evita a desnormalização no armazenamento e depende apenas de dados normalizados (exceto nos casos descritos na §3.2.4). Com dados normalizados, pontos quentes em ACLs comuns (por exemplo, grupos populares) podem sobrecarregar os servidores de banco de dados subjacentes. Constatamos que o tratamento de pontos quentes é a fronteira mais crítica em nossa busca por baixa latência e alta disponibilidade.
Zanzibar servers in each cluster form a distributed cache for both reads and check evaluations, including intermediate check results evaluated during pointer chasing. Cache entries are distributed across Zanzibar servers with consistent hashing [20]. To process checks or reads, we fan out requests to the corresponding Zanzibar servers via an internal RPC interface. To minimize the number of internal RPCs, for most namespaces we compute the forwarding key from the object ID, since processing a check on ⟨object#relation⟩ often involves indirect ACL checks on other relations of the same object and reading relation tuples of the object. These checks and reads can be processed by the same server since they share the same forwarding key with the parent check request. To handle hot forwarding keys, we cache results at both the caller and the callee of internal RPCs, effectively forming cache trees. We also use Slicer [12] to help distribute hot keys to multiple servers.
Os servidores do Zanzibar em cada cluster formam um cache distribuído tanto para leituras quanto para avaliações de verificações, incluindo resultados intermediários de verificações avaliados durante a perseguição de ponteiros. As entradas do cache são distribuídas entre os servidores do Zanzibar com hashing consistente [20]. Para processar verificações ou leituras, distribuímos as requisições aos servidores do Zanzibar correspondentes por meio de uma interface RPC interna. Para minimizar o número de RPCs internas, na maioria dos namespaces calculamos a chave de encaminhamento a partir do ID do objeto, já que processar uma verificação sobre ⟨object#relation⟩ frequentemente envolve verificações de ACL indiretas sobre outras relações do mesmo objeto e a leitura de tuplas de relação do objeto. Essas verificações e leituras podem ser processadas pelo mesmo servidor, pois compartilham a mesma chave de encaminhamento com a requisição de verificação pai. Para lidar com chaves de encaminhamento quentes, armazenamos os resultados em cache tanto no chamador quanto no chamado das RPCs internas, formando efetivamente árvores de cache. Também usamos o Slicer [12] para ajudar a distribuir chaves quentes entre múltiplos servidores.
We avoid reusing results evaluated from a different snapshot by encoding snapshot timestamps in cache keys. We choose evaluation timestamps rounded up to a coarse granularity, such as one or ten seconds, while respecting staleness constraints from request zookies. This timestamp quantization allows the vast majority of recent checks and reads to be evaluated at the same timestamps and to share cache results, despite having microsecond-resolution timestamps in cache keys. It is worth noting that rounding up timestamps does not affect Zanzibar’s consistency properties, since Spanner ensures that a snapshot read at timestamp will observe all writes up to —this holds even if is in the future, in which case the read will wait until TrueTime has moved past .
Evitamos reutilizar resultados avaliados a partir de um snapshot diferente codificando os timestamps de snapshot nas chaves de cache. Escolhemos timestamps de avaliação arredondados para cima até uma granularidade grossa, como um ou dez segundos, respeitando ao mesmo tempo as restrições de defasagem dos zookies das requisições. Essa quantização de timestamps permite que a grande maioria das verificações e leituras recentes seja avaliada nos mesmos timestamps e compartilhe resultados de cache, apesar de haver timestamps com resolução de microssegundos nas chaves de cache. Vale notar que arredondar timestamps para cima não afeta as propriedades de consistência do Zanzibar, já que o Spanner garante que uma leitura de snapshot no timestamp observará todas as escritas até — isso vale mesmo que esteja no futuro, caso em que a leitura aguardará até que o TrueTime tenha passado de .
To handle the “cache stampede” problem [3], where concurrent requests create flash hot spots before the cache is populated with results, we maintain a lock table on each server to track outstanding reads and checks. Among requests sharing the same cache key only one request will begin processing; the rest block until the cache is populated.
Para lidar com o problema de “estouro de cache” (cache stampede) [3], em que requisições concorrentes criam pontos quentes repentinos antes que o cache seja preenchido com os resultados, mantemos uma tabela de bloqueios em cada servidor para acompanhar as leituras e verificações pendentes. Entre as requisições que compartilham a mesma chave de cache, apenas uma começará a ser processada; as demais ficam bloqueadas até que o cache seja preenchido.
We can effectively handle the vast majority of hot spots with distributed caches and lock tables. Over time we made the following two improvements.
Conseguimos lidar efetivamente com a grande maioria dos pontos quentes com caches distribuídos e tabelas de bloqueios. Com o tempo, fizemos as duas melhorias a seguir.
First, direct membership checks of a user for an object and relation (i.e. ⟨object#relation@user⟩) are usually handled by a single relation tuple lookup. However, occasionally a very popular object invites many concurrent checks for different users, causing a hot spot on the storage server hosting relation tuples for the object. To avoid these hot spots, we read and cache all relation tuples of ⟨object#relation⟩ for the hot object, trading read bandwidth for cacheability. We dynamically detect hot objects to apply this method to by tracking the number of outstanding reads on each object.
Primeiro, as verificações de associação direta de um usuário a um objeto e relação (isto é, ⟨object#relation@user⟩) normalmente são tratadas por uma única consulta de tupla de relação. No entanto, ocasionalmente um objeto muito popular atrai muitas verificações concorrentes para usuários diferentes, causando um ponto quente no servidor de armazenamento que hospeda as tuplas de relação do objeto. Para evitar esses pontos quentes, lemos e armazenamos em cache todas as tuplas de relação de ⟨object#relation⟩ para o objeto quente, trocando largura de banda de leitura por capacidade de cache. Detectamos dinamicamente os objetos quentes aos quais aplicar esse método acompanhando o número de leituras pendentes em cada objeto.
Second, indirect ACL checks are frequently cancelled when the result of the parent ACL check is already determined. This leaves the cache key unpopulated. While eager cancellation reduces resource usage significantly, it negatively affects latency of concurrent requests that are blocked by the lock table entry. To prevent this latency impact, we delay eager cancellation when there are waiters on the corresponding lock table entry.
Segundo, as verificações de ACL indiretas são frequentemente canceladas quando o resultado da verificação de ACL pai já está determinado. Isso deixa a chave de cache sem preenchimento. Embora o cancelamento antecipado reduza significativamente o uso de recursos, ele afeta negativamente a latência das requisições concorrentes que estão bloqueadas pela entrada da tabela de bloqueios. Para evitar esse impacto na latência, adiamos o cancelamento antecipado quando há requisições aguardando na entrada correspondente da tabela de bloqueios.
Performance isolation is indispensable for shared services targeting low latency and high availability. If Zanzibar or one of its clients occasionally fails to provision enough resources to handle an unexpected usage pattern, the following isolation mechanisms ensure that performance problems are isolated to the problematic use case and do not adversely affect other clients.
O isolamento de desempenho é indispensável para serviços compartilhados que visam baixa latência e alta disponibilidade. Se o Zanzibar ou um de seus clientes ocasionalmente deixar de provisionar recursos suficientes para lidar com um padrão de uso inesperado, os seguintes mecanismos de isolamento garantem que os problemas de desempenho fiquem isolados no caso de uso problemático e não afetem negativamente outros clientes.
First, to ensure proper allocation of CPU capacity, Zanzibar measures the cost of each RPC in terms of generic cpu-seconds, a hardware-agnostic metric. Each client has a global limit on maximum CPU usage per second; its RPCs will be throttled if it exceeds the limit and there is no spare capacity in the overall system.
Primeiro, para garantir a alocação adequada de capacidade de CPU, o Zanzibar mede o custo de cada RPC em termos de cpu-segundos genéricos, uma métrica independente de hardware. Cada cliente tem um limite global de uso máximo de CPU por segundo; suas RPCs serão limitadas (throttled) se ele exceder o limite e não houver capacidade ociosa no sistema como um todo.
Each Zanzibar server also limits the total number of outstanding RPCs to control its memory usage. Likewise it limits the number of oustanding RPCs per client.
Cada servidor do Zanzibar também limita o número total de RPCs pendentes para controlar seu uso de memória. Da mesma forma, ele limita o número de RPCs pendentes por cliente.
Zanzibar further limits the maximum number of concurrent reads per (object, client) and per client on each Spanner server. This ensures that no single object or client can monopolize a Spanner server.
O Zanzibar limita ainda o número máximo de leituras concorrentes por (objeto, cliente) e por cliente em cada servidor Spanner. Isso garante que nenhum objeto ou cliente individual possa monopolizar um servidor Spanner.
Finally, we use different lock table keys for requests from different clients to prevent any throttling that Spanner applies to one client from affecting other clients.
Por fim, usamos chaves de tabela de bloqueios diferentes para requisições de clientes diferentes, a fim de evitar que qualquer limitação (throttling) que o Spanner aplique a um cliente afete outros clientes.
Zanzibar’s distributed processing requires measures to accommodate slow tasks. For calls to Spanner and to the Leopard index we rely on request hedging [16] (i.e. we send the same request to multiple servers, use whichever response comes back first, and cancel the other requests). To reduce round-trip times, we try to place at least two replicas of these backend services in every geographical region where we have Zanzibar servers. To avoid unnecessarily multiplying load, we first send one request and defer sending hedged requests until the initial request is known to be slow.
O processamento distribuído do Zanzibar exige medidas para acomodar tarefas lentas. Para chamadas ao Spanner e ao índice Leopard, contamos com o hedging de requisições [16] (isto é, enviamos a mesma requisição a vários servidores, usamos a resposta que chegar primeiro e cancelamos as demais requisições). Para reduzir os tempos de ida e volta, procuramos posicionar pelo menos duas réplicas desses serviços de backend em cada região geográfica onde temos servidores do Zanzibar. Para evitar multiplicar a carga desnecessariamente, primeiro enviamos uma requisição e adiamos o envio de requisições de hedging até que se saiba que a requisição inicial está lenta.
To determine the appropriate hedging delay threshold, each server maintains a delay estimator that dynamically computes an Nth percentile latency based on recent measurements. This mechanism allows us to limit the additional traffic incurred by hedging to a small fraction of total traffic.
Para determinar o limiar de atraso de hedging adequado, cada servidor mantém um estimador de atraso que calcula dinamicamente a latência do N-ésimo percentil com base em medições recentes. Esse mecanismo nos permite limitar o tráfego adicional gerado pelo hedging a uma pequena fração do tráfego total.
Effective hedging requires the requests to have similar costs. In the case of Zanzibar’s authorization checks, some checks are inherently more time-consuming than others because they require more work. Hedging check requests would result in duplicating the most expensive workloads and, ironically, worsening latency. Therefore we do not hedge requests between Zanzibar servers, but rely on the previously discussed sharding among multiple replicas and on monitoring mechanisms to detect and avoid slow servers.
Um hedging eficaz exige que as requisições tenham custos semelhantes. No caso das verificações de autorização do Zanzibar, algumas verificações são inerentemente mais demoradas do que outras porque exigem mais trabalho. Fazer hedging das requisições de verificação resultaria na duplicação das cargas de trabalho mais custosas e, ironicamente, na piora da latência. Portanto, não fazemos hedging de requisições entre servidores do Zanzibar, mas contamos com o sharding entre múltiplas réplicas, discutido anteriormente, e com mecanismos de monitoramento para detectar e evitar servidores lentos.
Zanzibar has been in production use for more than 5 years. Throughout that time, the number of clients using Zanzibar and the load they place on Zanzibar have grown steadily. This section discusses our experience operating Zanzibar as a globally distributed authorization system.
O Zanzibar está em uso em produção há mais de 5 anos. Ao longo desse tempo, o número de clientes que usam o Zanzibar e a carga que eles impõem ao Zanzibar cresceram de forma constante. Esta seção discute nossa experiência operando o Zanzibar como um sistema de autorização globalmente distribuído.
Zanzibar manages more than 1,500 namespaces defined by hundreds of client applications. The size of a namespace configuration file serves as a rough measure of the complexity of the access control policy implemented by that namespace. These configuration files range from tens of lines to thousands of lines, with the median near 500 lines.
O Zanzibar gerencia mais de 1.500 namespaces definidos por centenas de aplicações clientes. O tamanho do arquivo de configuração de um namespace serve como uma medida aproximada da complexidade da política de controle de acesso implementada por esse namespace. Esses arquivos de configuração variam de dezenas a milhares de linhas, com a mediana próxima de 500 linhas.
These namespaces contain more than 2 trillion relation tuples that occupy close to 100 terabytes. The number of tuples per namespace ranges over many orders of magnitude, from tens to a trillion, with the median near 15,000. This data is fully replicated in more than 30 locations around the world to maintain both proximity to users and high availability.
Esses namespaces contêm mais de 2 trilhões de tuplas de relação, que ocupam cerca de 100 terabytes. O número de tuplas por namespace varia ao longo de muitas ordens de grandeza, de dezenas a um trilhão, com a mediana próxima de 15.000. Esses dados são totalmente replicados em mais de 30 localidades ao redor do mundo, para manter tanto a proximidade com os usuários quanto a alta disponibilidade.
Zanzibar serves more than 10 million client queries per second (QPS). Over a sample 7-day period in December 2018, Check requests peak at roughly 4.2M QPS, Read at 8.2M, Expand at 760K, and Write at 25K. Queries that read data are thus two orders of magnitude more frequent than those that write data.
O Zanzibar atende mais de 10 milhões de consultas de clientes por segundo (QPS). Em um período amostral de 7 dias em dezembro de 2018, as requisições Check atingiram picos de aproximadamente 4,2M QPS, Read de 8,2M, Expand de 760K e Write de 25K. As consultas que leem dados são, portanto, duas ordens de grandeza mais frequentes do que as que escrevem dados.
Zanzibar distributes this load across more than 10,000 servers organized in several dozen clusters around the world. The number of servers per cluster ranges from fewer than 100 to more than 1,000, with the median near 500. Clusters are sized in proportion to load in their geographic regions.
O Zanzibar distribui essa carga entre mais de 10.000 servidores organizados em várias dezenas de clusters ao redor do mundo. O número de servidores por cluster varia de menos de 100 a mais de 1.000, com a mediana próxima de 500. Os clusters são dimensionados proporcionalmente à carga em suas regiões geográficas.
We divide requests into two categories according to the required data freshness, which can have a large impact on latency and availability of the requests. Specifically, Check, Read, and Expand requests carry zookies to specify lower bounds on evaluation timestamps. When a zookie timestamp is higher than that of the most recent data replicated to the region, the storage reads require cross-region round trips to the leader replica to retrieve fresher data. As our storage is configured with replication heartbeats with 8-second intervals, we divide our requests into two categories: Safe requests have zookies more than 10 seconds old and can be served within the region most of time, while Recent requests have zookies less than 10 seconds old and often require inter-region round trips. We report separate statistics for each.
Dividimos as requisições em duas categorias de acordo com a atualidade dos dados exigida, que pode ter grande impacto na latência e na disponibilidade das requisições. Especificamente, as requisições Check, Read e Expand carregam zookies para especificar limites inferiores para os timestamps de avaliação. Quando o timestamp de um zookie é maior do que o dos dados mais recentes replicados para a região, as leituras do armazenamento exigem viagens de ida e volta entre regiões até a réplica líder para obter dados mais atuais. Como nosso armazenamento é configurado com heartbeats de replicação em intervalos de 8 segundos, dividimos nossas requisições em duas categorias: as requisições Safe têm zookies com mais de 10 segundos de idade e podem ser atendidas dentro da região na maior parte do tempo, enquanto as requisições Recent têm zookies com menos de 10 segundos de idade e frequentemente exigem viagens de ida e volta entre regiões. Relatamos estatísticas separadas para cada uma.
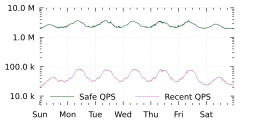
Figure 3: Rate of Check Safe and Check Recent requests over a 7-day period in December 2018.
Figura 3: Taxa de requisições Check Safe e Check Recent ao longo de um período de 7 dias em dezembro de 2018.
Figure 3 shows the rate of Check Safe and Check Recent requests over 7 days. Both exhibit a diurnal cycle. The rate of Safe requests is about two orders of magnitude larger than that of Recent requests, which allows Zanzibar to serve the vast majority of ACL checks locally.
A Figura 3 mostra a taxa de requisições Check Safe e Check Recent ao longo de 7 dias. Ambas exibem um ciclo diário. A taxa de requisições Safe é cerca de duas ordens de grandeza maior do que a de requisições Recent, o que permite ao Zanzibar atender localmente a grande maioria das verificações de ACL.
Zanzibar’s latency budget is generally a small fraction of the few hundreds of milliseconds of total response time that its clients must provide to be viable interactive services. Consider for example a client that performs authorization checks on multiple documents before it can show the results of a search on those documents.
O orçamento de latência do Zanzibar é geralmente uma pequena fração das poucas centenas de milissegundos de tempo de resposta total que seus clientes precisam oferecer para serem serviços interativos viáveis. Considere, por exemplo, um cliente que realiza verificações de autorização em vários documentos antes de poder mostrar os resultados de uma busca sobre esses documentos.
We measure latency on the server side using live traffic because (1) latency is heavily influenced by our caching and de-duplication mechanisms so that it is only realistically reflected by live traffic, and (2) accurately measuring latency from clients requires well-behaving clients. Provisioning of client jobs is outside of Zanzibar’s control and sometimes client jobs are overloaded.
Medimos a latência no lado do servidor usando tráfego real porque (1) a latência é fortemente influenciada por nossos mecanismos de cache e deduplicação, de modo que só é refletida de forma realista pelo tráfego real, e (2) medir com precisão a latência a partir dos clientes exige clientes bem-comportados. O provisionamento dos jobs dos clientes está fora do controle do Zanzibar e, às vezes, os jobs dos clientes ficam sobrecarregados.
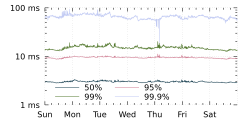
Figure 4: Latency of Check Safe responses at different percentiles over a 7-day period in December 2018.
Figura 4: Latência das respostas Check Safe em diferentes percentis ao longo de um período de 7 dias em dezembro de 2018.
Figure 4 shows the latency of Check Safe responses over 7 days. At the 50th, 95th, 99th, and 99.9th percentiles it peaks at roughly 3, 11, 20, and 93 msec, respectively. This performance meets our latency goals for an operation that is frequently in the critical path of user interactions.
A Figura 4 mostra a latência das respostas Check Safe ao longo de 7 dias. Nos percentis 50, 95, 99 e 99,9, ela atinge picos de aproximadamente 3, 11, 20 e 93 ms, respectivamente. Esse desempenho atende aos nossos objetivos de latência para uma operação que frequentemente está no caminho crítico das interações dos usuários.
Table 2 summarizes the latency distributions of Check, Read, Expand, and Write responses over the same 7 days. As intended, the more frequently used Safe versions of Check, Read, and Expand are significantly faster than the less frequently used Recent versions. Writes are the least frequently used of all the APIs, and the slowest because they always require distributed coordination among Spanner servers.
A Tabela 2 resume as distribuições de latência das respostas Check, Read, Expand e Write ao longo dos mesmos 7 dias. Como pretendido, as versões Safe de Check, Read e Expand, usadas com mais frequência, são significativamente mais rápidas do que as versões Recent, usadas com menos frequência. As escritas são as menos usadas de todas as APIs e as mais lentas, porque sempre exigem coordenação distribuída entre servidores Spanner.
Table 2: Mean and standard deviation of RPC response latency over a 7-day period in December 2018.
Tabela 2: Média e desvio-padrão da latência de resposta das RPCs ao longo de um período de 7 dias em dezembro de 2018.
We define availability as the fraction of “qualified” RPCs the service answers successfully within latency thresholds: 5 seconds for a Safe request, and 15 seconds for a Recent request as leader re-election in Spanner may take up to 10 seconds. For an RPC to be qualified, the request must be well-formed and have a deadline longer than the latency threshold. In addition, the client must stay within its resource quota.
Definimos disponibilidade como a fração de RPCs “qualificadas” que o serviço responde com sucesso dentro dos limiares de latência: 5 segundos para uma requisição Safe e 15 segundos para uma requisição Recent, já que a reeleição do líder no Spanner pode levar até 10 segundos. Para que uma RPC seja qualificada, a requisição deve estar bem-formada e ter um prazo (deadline) maior do que o limiar de latência. Além disso, o cliente deve permanecer dentro de sua cota de recursos.
For these reasons, we cannot measure availability directly with live traffic, as our clients sometimes send RPCs with short deadlines or cancel their in-progress RPCs. Instead, we sample a small fraction of valid requests from live traffic and replay them later with our own probers. When replaying the requests, we set the timeout to be longer than the availability threshold. We also adjust the request zookie, if one is specified, so that the relative age of the zookie remains the same as when the request was received in the live traffic. Finally, we run 3 probers per cluster and exclude outliers to eliminate false alarms caused by rare prober failures.
Por essas razões, não podemos medir a disponibilidade diretamente com o tráfego real, pois nossos clientes às vezes enviam RPCs com prazos curtos ou cancelam suas RPCs em andamento. Em vez disso, amostramos uma pequena fração das requisições válidas do tráfego real e as reproduzimos posteriormente com nossos próprios probers. Ao reproduzir as requisições, definimos o timeout como maior do que o limiar de disponibilidade. Também ajustamos o zookie da requisição, se houver um especificado, de modo que a idade relativa do zookie permaneça a mesma de quando a requisição foi recebida no tráfego real. Por fim, executamos 3 probers por cluster e excluímos os valores discrepantes para eliminar alarmes falsos causados por falhas raras dos probers.
To compute availability, we aggregate success ratios over 90-day windows averaged across clusters. Figure 5 shows Zanzibar’s availability as measured by these probers. Availability has remained above 99.999% over the past 3 years of operation at Google. In other words, for every quarter, Zanzibar has less than 2 minutes of global downtime and fewer than 13 minutes when the global error ratio exceeds 10%.
Para calcular a disponibilidade, agregamos as taxas de sucesso em janelas de 90 dias, com média entre os clusters. A Figura 5 mostra a disponibilidade do Zanzibar medida por esses probers. A disponibilidade permaneceu acima de 99,999% nos últimos 3 anos de operação no Google. Em outras palavras, a cada trimestre, o Zanzibar tem menos de 2 minutos de indisponibilidade global e menos de 13 minutos em que a taxa de erro global excede 10%.
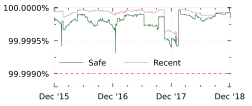
Figure 5: Zanzibar’s availability over the past three years has remained above 99.999%.
Figura 5: A disponibilidade do Zanzibar nos últimos três anos permaneceu acima de 99,999%.
Zanzibar servers delegate checks and reads to each other based on consistent hashing, and both the caller and the callee sides of the delegated operations cache the results to prevent hot spots (§3.2.5). At peak, Zanzibar handles 22 million internal “delegated” RPCs per second, split about evenly between reads and checks. In-memory caching handles approximately 200 million lookups per second at peak, 150 million from checks and 50 million from reads. Caching for checks has a 10% hit rate on the delegate’s side, with an additional 12% saved by the lock table. Meanwhile, caching on the delegator’s side has a 2% hit rate with an additional 3% from the lock table. While these hit rates appear low, they prevent 500K internal RPCs per second from creating hot spots.
Os servidores do Zanzibar delegam verificações e leituras uns aos outros com base em hashing consistente, e tanto o lado chamador quanto o lado chamado das operações delegadas armazenam os resultados em cache para evitar pontos quentes (§3.2.5). No pico, o Zanzibar processa 22 milhões de RPCs internas “delegadas” por segundo, divididas de forma aproximadamente igual entre leituras e verificações. O cache em memória processa aproximadamente 200 milhões de consultas por segundo no pico, 150 milhões provenientes de verificações e 50 milhões de leituras. O cache de verificações tem uma taxa de acerto de 10% no lado do delegado, com mais 12% poupados pela tabela de bloqueios. Enquanto isso, o cache no lado do delegante tem uma taxa de acerto de 2%, com mais 3% provenientes da tabela de bloqueios. Embora essas taxas de acerto pareçam baixas, elas impedem que 500K RPCs internas por segundo criem pontos quentes.
Delegated reads see higher hit rates on the delegate’s side—24% on the cache and 9% on the lock table—but the delegator’s cache is hit less than 1% of the time. For super-hot groups, Zanzibar further optimizes by reading and caching the full set of members in advance—this happens for 0.1% of groups but further prevents hot spots.
As leituras delegadas apresentam taxas de acerto mais altas no lado do delegado — 24% no cache e 9% na tabela de bloqueios —, mas o cache do delegante registra acertos em menos de 1% das vezes. Para grupos super quentes, o Zanzibar otimiza ainda mais lendo e armazenando em cache antecipadamente o conjunto completo de membros — isso acontece para 0,1% dos grupos, mas evita ainda mais pontos quentes.
This caching, along with aggressive pooling of read requests, allows Zanzibar to issue only 20 million read RPCs per second to Spanner. The median of these requests reads 1.5 rows per RPC, but at the 99th percentile they each read close to 1 thousand rows.
Esse cache, junto com o agrupamento agressivo de requisições de leitura, permite que o Zanzibar emita apenas 20 milhões de RPCs de leitura por segundo ao Spanner. A mediana dessas requisições lê 1,5 linha por RPC, mas no 99º percentil cada uma lê cerca de mil linhas.
Zanzibar’s Spanner reads take 0.5 msec at the median, and 2 msec at the 95th percentile. We find that 1% of Spanner reads, or 200K reads per second, benefit from hedging. We note that Zanzibar uses an instance of Spanner that runs internally to Google, not an instance of Cloud Spanner [6].
As leituras do Zanzibar no Spanner levam 0,5 ms na mediana e 2 ms no 95º percentil. Constatamos que 1% das leituras do Spanner, ou 200K leituras por segundo, se beneficiam do hedging. Observamos que o Zanzibar usa uma instância do Spanner que roda internamente no Google, e não uma instância do Cloud Spanner [6].
The Leopard index is performing 1.56M QPS at the median, or 2.22M QPS at the 99th percentile, based on data aggregated over 7 days. Over the same 7 days, Leopard servers respond in fewer than 150 μsec at the median, or under 1 msec at the 99th percentile. Leopard’s incremental layer during those 7 days writes roughly 500 index updates per second at the median, and approximately 1.5K updates per second at the 99th percentile.
O índice Leopard processa 1,56M QPS na mediana, ou 2,22M QPS no 99º percentil, com base em dados agregados ao longo de 7 dias. Ao longo dos mesmos 7 dias, os servidores Leopard respondem em menos de 150 μs na mediana, ou abaixo de 1 ms no 99º percentil. A camada incremental do Leopard, durante esses 7 dias, escreve aproximadamente 500 atualizações de índice por segundo na mediana e aproximadamente 1,5K atualizações por segundo no 99º percentil.
Zanzibar has evolved to meet the varied and heavy demands of a growing set of clients, including Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos, and YouTube. This section highlights lessons learned from this experience.
O Zanzibar evoluiu para atender às demandas variadas e intensas de um conjunto crescente de clientes, incluindo Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos e YouTube. Esta seção destaca as lições aprendidas com essa experiência.
One common theme has been the importance of flexibility to accommodate differences between clients. For example:
Um tema recorrente tem sido a importância da flexibilidade para acomodar as diferenças entre os clientes. Por exemplo:
- Access control patterns vary widely: Over time we have added features to support specific clients. For instance, we added
computed_usersetto allow inferring an object’s owner ID from the object ID prefix, which reduces space requirements for clients such as Drive and Photos that manage many private objects. Similarly, we addedtuple_to_usersetto represent object hierarchy with only one relation tuple per hop. The benefits are both space reduction and flexibility—it allows clients such as Cloud both to express ACL inheritance compactly and to change ACL inheritance rules without having to update large numbers of tuples. See §2.3.1. - Freshness requirements are often but not always loose: Clients often allow unspecified, moderate staleness during ACL evaluation, but sometimes require more precisely specified freshness. We designed our zookie protocol around this property so that we can serve most requests from a default, already replicated snapshot, while allowing clients to bound the staleness when needed. We also tuned the granularity of our snapshot timestamps to match clients’ freshness requirements. The resulting coarse timestamp quanta allow us to perform the majority of authorization checks on a small number of snapshots, thus greatly reducing the frequency of database reads. See §3.2.1.
- Os padrões de controle de acesso variam amplamente: ao longo do tempo, adicionamos funcionalidades para atender a clientes específicos. Por exemplo, adicionamos
computed_usersetpara permitir inferir o ID do dono de um objeto a partir do prefixo do ID do objeto, o que reduz os requisitos de espaço para clientes como Drive e Photos, que gerenciam muitos objetos privados. Da mesma forma, adicionamostuple_to_usersetpara representar a hierarquia de objetos com apenas uma tupla de relação por salto. Os benefícios são tanto a redução de espaço quanto a flexibilidade — isso permite que clientes como o Cloud tanto expressem a herança de ACL de forma compacta quanto alterem as regras de herança de ACL sem precisar atualizar grandes quantidades de tuplas. Veja a §2.3.1. - Os requisitos de atualidade são frequentemente, mas nem sempre, flexíveis: os clientes frequentemente admitem uma defasagem moderada e não especificada durante a avaliação de ACLs, mas às vezes exigem uma atualidade especificada com mais precisão. Projetamos nosso protocolo de zookie em torno dessa propriedade, de modo que possamos atender à maioria das requisições a partir de um snapshot padrão já replicado, permitindo ao mesmo tempo que os clientes limitem a defasagem quando necessário. Também ajustamos a granularidade de nossos timestamps de snapshot para corresponder aos requisitos de atualidade dos clientes. Os quanta de timestamp grossos resultantes nos permitem realizar a maioria das verificações de autorização sobre um pequeno número de snapshots, reduzindo assim enormemente a frequência de leituras do banco de dados. Veja a §3.2.1.
Another theme has been the need to add performance optimizations to support client behaviors observed in production. For example:
Outro tema tem sido a necessidade de adicionar otimizações de desempenho para dar suporte aos comportamentos dos clientes observados em produção. Por exemplo:
- Request hedging is key to reducing tail latency: Clients that offer search capabilities to their users, such as Drive, often issue tens to hundreds of authorization checks to serve a single set of search results. We introduced hedging of Spanner and Leopard requests to prevent an occasional slow operation from slowing the overall user interaction. See §3.2.7.
- Hot-spot mitigation is critical for high availability: Some workloads create hot spots in ACL data that can overwhelm the underlying database servers. A common pattern is a burst of ACL checks for an object that is indirectly referenced by the ACLs for many different objects. Specific instances arise from the search use case mentioned above, where the documents in the search indirectly share ACLs for a large social or work group, and Cloud use cases where many objects indirectly share ACLs for the same object high in a hierarchy. Zanzibar handles most hot spots with general mechanisms such as its distributed cache and lock table, but we have found the need to optimize specific uses cases. For example, we added cache prefetching of all relation tuples for a hot object. We also delayed cancellation of secondary ACL checks when there are concurrent requests for the same ACL data. See §3.2.5.
- Performance isolation is indispensable to protect against misbehaving clients: Even with hot-spot mitigation measures, unexpected and sometimes unintended client behaviors could still overload our system or its underlying infrastructure. Examples include when clients launch new features that prove unexpectedly popular or exercise Zanzibar in unintended ways. Over time we have added isolation safeguards to ensure that there are no cascading failures between clients or between objects of the same client. These safeguards include fine-grained cost accounting, quotas, and throttling. See §3.2.6.
- O hedging de requisições é fundamental para reduzir a latência de cauda: clientes que oferecem recursos de busca a seus usuários, como o Drive, frequentemente emitem de dezenas a centenas de verificações de autorização para servir um único conjunto de resultados de busca. Introduzimos o hedging de requisições ao Spanner e ao Leopard para evitar que uma operação lenta ocasional torne lenta toda a interação do usuário. Veja a §3.2.7.
- A mitigação de pontos quentes é crítica para a alta disponibilidade: algumas cargas de trabalho criam pontos quentes nos dados de ACL que podem sobrecarregar os servidores de banco de dados subjacentes. Um padrão comum é uma rajada de verificações de ACL para um objeto que é referenciado indiretamente pelas ACLs de muitos objetos diferentes. Casos específicos surgem do caso de uso de busca mencionado acima, em que os documentos da busca compartilham indiretamente ACLs de um grande grupo social ou de trabalho, e de casos de uso do Cloud em que muitos objetos compartilham indiretamente ACLs do mesmo objeto, situado no alto de uma hierarquia. O Zanzibar lida com a maioria dos pontos quentes com mecanismos gerais, como seu cache distribuído e sua tabela de bloqueios, mas constatamos a necessidade de otimizar casos de uso específicos. Por exemplo, adicionamos a pré-busca em cache de todas as tuplas de relação de um objeto quente. Também adiamos o cancelamento de verificações de ACL secundárias quando há requisições concorrentes para os mesmos dados de ACL. Veja a §3.2.5.
- O isolamento de desempenho é indispensável para proteger contra clientes que se comportam mal: mesmo com medidas de mitigação de pontos quentes, comportamentos inesperados e às vezes não intencionais dos clientes ainda podem sobrecarregar nosso sistema ou sua infraestrutura subjacente. Exemplos incluem quando os clientes lançam novas funcionalidades que se mostram inesperadamente populares ou que usam o Zanzibar de maneiras não previstas. Com o tempo, adicionamos salvaguardas de isolamento para garantir que não haja falhas em cascata entre clientes ou entre objetos do mesmo cliente. Essas salvaguardas incluem contabilização de custos de granularidade fina, cotas e limitação (throttling). Veja a §3.2.6.
Zanzibar is a planet-scale distributed ACL storage and evaluation system. Many of its authorization concepts have been explored previously within the domains of access control and social graphs, and its scaling challenges have been investigated within the field of distributed systems.
O Zanzibar é um sistema distribuído de armazenamento e avaliação de ACLs em escala planetária. Muitos de seus conceitos de autorização já foram explorados anteriormente nos domínios de controle de acesso e de grafos sociais, e seus desafios de escalabilidade foram investigados no campo de sistemas distribuídos.
Access control is a core part of multi-user operating systems. Multics [23] supports ACLs on segments and directories. ACL entries consist of a principal identifier and a set of permissions bits. In the first edition of UNIX [9], file flags indicate whether owner and non-owner can read or write the file. By the 4th edition, the permissions bits had been expanded to read/write/execute bits for owner, group, and others. POSIX ACLs [4] add an arbitrary list of users and groups, each with up to 32 permissions bits. VMS [7, 8] supports ACL inheritance for files created within a directory tree. Zanzibar’s data model supports permissions, users, groups, and inheritance as found in the above systems.
O controle de acesso é uma parte central dos sistemas operacionais multiusuário. O Multics [23] oferece suporte a ACLs em segmentos e diretórios. As entradas de ACL consistem em um identificador de principal e um conjunto de bits de permissão. Na primeira edição do UNIX [9], flags de arquivo indicam se o dono e os não donos podem ler ou escrever o arquivo. Na 4ª edição, os bits de permissão já haviam sido expandidos para bits de leitura/escrita/execução para o dono, o grupo e os demais. As ACLs POSIX [4] adicionam uma lista arbitrária de usuários e grupos, cada um com até 32 bits de permissão. O VMS [7, 8] oferece suporte à herança de ACL para arquivos criados dentro de uma árvore de diretórios. O modelo de dados do Zanzibar oferece suporte a permissões, usuários, grupos e herança, tal como encontrados nos sistemas acima.
Taos [24, 10] supports compound principals that incorporate how an identity has been transformed as it passes through a distributed system. For example, if user logged into workstation to access file server , would see requests authenticated as “ for ” rather than just . This would allow one to write an ACL on a user’s e-mail that would be accessible only to the user, and only if being accessed via the mail server. Abadi et al. discuss in [11] a model of group-based ACLs with support for compound identities. Their notion of “blessings” are similar to Zanzibar tuples. However, Zanzibar adopts a unified representation for ACLs and groups using usersets, while they are separate concepts in [11].
O Taos [24, 10] oferece suporte a principais compostos, que incorporam como uma identidade foi transformada ao passar por um sistema distribuído. Por exemplo, se o usuário fizesse login na estação de trabalho para acessar o servidor de arquivos , veria requisições autenticadas como “ em nome de ”, em vez de apenas . Isso permitiria escrever uma ACL sobre o e-mail de um usuário que seria acessível apenas ao usuário, e apenas se acessado por meio do servidor de e-mail. Abadi et al. discutem em [11] um modelo de ACLs baseadas em grupos com suporte a identidades compostas. Sua noção de “bênçãos” (blessings) é semelhante às tuplas do Zanzibar. No entanto, o Zanzibar adota uma representação unificada para ACLs e grupos usando usersets, enquanto em [11] eles são conceitos separados.
Role-based access control (RBAC), first proposed in [17], introduced the notion of roles, which are similar to Zanzibar relations. Roles can inherit from each other and imply permissions. A number of Zanzibar clients have implemented RBAC policies on top of Zanzibar’s namespace configuration language.
O controle de acesso baseado em papéis (RBAC), proposto pela primeira vez em [17], introduziu a noção de papéis, que são semelhantes às relações do Zanzibar. Os papéis podem herdar uns dos outros e implicar permissões. Diversos clientes do Zanzibar implementaram políticas RBAC sobre a linguagem de configuração de namespace do Zanzibar.
A discussion of ACL stores in 2019 would be remiss without mentioning the Identity and Access Management (IAM) systems offered commercially by Amazon [1], Google [5], Microsoft [2], and others. These systems allow customers of those companies’ cloud products to configure flexible access controls based on various features such as: assigning users to roles or groups; domain-specific policy languages; and APIs that allow the creation and modification of ACLs. What all of these systems have in common is unified ACL storage and an RPC-based API, a philosophy also core to Zanzibar’s design. Google’s Cloud IAM system [5] is built as a layer on top of Zanzibar’s ACL storage and evaluation system.
Uma discussão sobre armazenamentos de ACL em 2019 estaria incompleta sem mencionar os sistemas de Gerenciamento de Identidade e Acesso (IAM) oferecidos comercialmente pela Amazon [1], pelo Google [5], pela Microsoft [2] e por outros. Esses sistemas permitem que os clientes dos produtos de nuvem dessas empresas configurem controles de acesso flexíveis com base em diversas funcionalidades, como: atribuição de usuários a papéis ou grupos; linguagens de política específicas de domínio; e APIs que permitem a criação e a modificação de ACLs. O que todos esses sistemas têm em comum é o armazenamento unificado de ACLs e uma API baseada em RPC, uma filosofia também central ao projeto do Zanzibar. O sistema Cloud IAM do Google [5] é construído como uma camada sobre o sistema de armazenamento e avaliação de ACLs do Zanzibar.
TAO [13] is a distributed datastore for Facebook’s social graph. Several Zanzibar clients also use Zanzibar to store their social graphs. Both Zanzibar and TAO provide authorization checks to clients. Both are deployed as single-instance services, both operate at a large scale, and both are optimized for read-only operations. TAO offers eventual global consistency with asynchronous replication and best-effort read-after-write consistency with synchronous cache updates. In contrast, Zanzibar provides external consistency and snapshot reads with bounded staleness, so that it respects causal ordering between ACL and content updates and thus protects against the “new enemy” problem.
O TAO [13] é um armazenamento de dados distribuído para o grafo social do Facebook. Vários clientes do Zanzibar também usam o Zanzibar para armazenar seus grafos sociais. Tanto o Zanzibar quanto o TAO fornecem verificações de autorização aos clientes. Ambos são implantados como serviços de instância única, ambos operam em grande escala e ambos são otimizados para operações somente de leitura. O TAO oferece consistência global eventual com replicação assíncrona e consistência de leitura após escrita, em regime de melhor esforço, com atualizações síncronas de cache. Em contraste, o Zanzibar fornece consistência externa e leituras de snapshot com defasagem limitada, de modo que respeita a ordenação causal entre atualizações de ACL e de conteúdo e, assim, protege contra o problema do “novo inimigo”.
Lamport clocks [22] provide partially ordered vector timestamps that can be used to determine the order of events. However, Lamport clocks require explicit participation of all “processes”, where in Zanzibar’s use cases some of the “processes” can be external clients or even human users. In contrast, Zanzibar relies on its underlying database system, Spanner [15], to offer both external consistency and snapshot reads with bounded staleness. In particular, Zanzibar builds on Spanner’s TrueTime abstraction [15] to provide linearizable commit timestamps encoded as zookies.
Os relógios de Lamport [22] fornecem timestamps vetoriais parcialmente ordenados que podem ser usados para determinar a ordem dos eventos. No entanto, os relógios de Lamport exigem a participação explícita de todos os “processos”, ao passo que, nos casos de uso do Zanzibar, alguns dos “processos” podem ser clientes externos ou até mesmo usuários humanos. Em contraste, o Zanzibar depende de seu sistema de banco de dados subjacente, o Spanner [15], para oferecer tanto consistência externa quanto leituras de snapshot com defasagem limitada. Em particular, o Zanzibar se apoia na abstração TrueTime do Spanner [15] para fornecer timestamps de commit linearizáveis codificados como zookies.
At the same time, Zanzibar adds a number of features on top of those provided by Spanner. For one, the zookie protocol does not let clients read or evaluate ACLs at an arbitrary snapshot. This restriction allows Zanzibar to choose a snapshot that facilitates fast ACL evaluation. In addition, Zanzibar provides resilience to database hotspots (e.g. authorization checks on a suddenly popular video) and safe pointer chasing despite potentially deep recursion (e.g. membership checks on hierarchical groups).
Ao mesmo tempo, o Zanzibar adiciona várias funcionalidades além das fornecidas pelo Spanner. Para começar, o protocolo de zookie não permite que os clientes leiam ou avaliem ACLs em um snapshot arbitrário. Essa restrição permite que o Zanzibar escolha um snapshot que facilite a avaliação rápida de ACLs. Além disso, o Zanzibar oferece resiliência a pontos quentes no banco de dados (por exemplo, verificações de autorização sobre um vídeo que repentinamente se tornou popular) e perseguição de ponteiros segura apesar de recursão potencialmente profunda (por exemplo, verificações de associação em grupos hierárquicos).
The Chubby distributed lock service [14] offers reliable storage, linearizes writes, and provides access control, but it lacks features needed to support Zanzibar’s use cases. In particular, it does not support high volumes of data, efficient range reads, or reads at a client-specified snapshot with bounded staleness. Its cache invalidation mechanism also limits its write throughput.
O serviço de bloqueio distribuído Chubby [14] oferece armazenamento confiável, lineariza as escritas e fornece controle de acesso, mas carece de funcionalidades necessárias para dar suporte aos casos de uso do Zanzibar. Em particular, ele não oferece suporte a grandes volumes de dados, leituras de intervalo eficientes, nem leituras em um snapshot especificado pelo cliente com defasagem limitada. Seu mecanismo de invalidação de cache também limita sua vazão de escrita.
Finally, ZooKeeper offers a high-performance coordination service [19] but also lacks features required by Zanzibar. Relative to Chubby, it can handle higher read and write rates with more relaxed cache consistency. However, it does not provide external consistency for updates across different nodes since its linearizability is on a per-node basis. It also does not provide snapshot reads with bounded staleness.
Por fim, o ZooKeeper oferece um serviço de coordenação de alto desempenho [19], mas também carece de funcionalidades exigidas pelo Zanzibar. Em relação ao Chubby, ele consegue lidar com taxas de leitura e escrita mais altas, com uma consistência de cache mais relaxada. No entanto, ele não fornece consistência externa para atualizações entre nós diferentes, já que sua linearizabilidade é por nó. Ele também não fornece leituras de snapshot com defasagem limitada.
The Zanzibar authorization system unifies access control data and logic for Google. Its simple yet flexible data model and configuration language support a variety of access control policies from both consumer and enterprise applications.
O sistema de autorização Zanzibar unifica os dados e a lógica de controle de acesso do Google. Seu modelo de dados e sua linguagem de configuração, simples porém flexíveis, oferecem suporte a uma variedade de políticas de controle de acesso tanto de aplicações de consumo quanto de aplicações corporativas.
Zanzibar’s external consistency model is one of its most salient features. It respects the ordering of user actions, yet at the same time allows authorization checks to be evaluated at distributed locations without global synchronization.
O modelo de consistência externa do Zanzibar é uma de suas características mais marcantes. Ele respeita a ordenação das ações dos usuários e, ao mesmo tempo, permite que as verificações de autorização sejam avaliadas em locais distribuídos sem sincronização global.
Zanzibar employs other key techniques to provide scalability, low latency, and high availability. For example, it evaluates deeply or widely nested group membership with Leopard, a specialized index for efficient computation of set operations with snapshot consistency. As another example, it combines a distributed cache with a mechanism to deduplicate in-flight requests. It thus mitigates hot spots, a critical production issue when serving data on top of normalized, consistent storage. These measures together result in a system that scales to trillions of access control rules and millions of authorization requests per second.
O Zanzibar emprega outras técnicas fundamentais para fornecer escalabilidade, baixa latência e alta disponibilidade. Por exemplo, ele avalia associações a grupos profunda ou amplamente aninhados com o Leopard, um índice especializado para a computação eficiente de operações sobre conjuntos com consistência de snapshot. Como outro exemplo, ele combina um cache distribuído com um mecanismo para deduplicar requisições em andamento. Assim, ele mitiga os pontos quentes, um problema crítico em produção ao servir dados sobre um armazenamento normalizado e consistente. Essas medidas, em conjunto, resultam em um sistema que escala para trilhões de regras de controle de acesso e milhões de requisições de autorização por segundo.
Many people have made technical contributions to Zanzibar. We thank previous and recent members of the development team, including Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp, and Yuliya Zabiyaka. We also thank previous and current members of the Site Reliability Engineering team, including Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson, and Andrea Yu.
Muitas pessoas fizeram contribuições técnicas ao Zanzibar. Agradecemos aos membros antigos e recentes da equipe de desenvolvimento, incluindo Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp e Yuliya Zabiyaka. Agradecemos também aos membros antigos e atuais da equipe de Site Reliability Engineering, incluindo Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson e Andrea Yu.
In addition, a number of people have helped to improve this paper. We received insightful comments from David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen, and Lawrence You. We are also grateful to Nadav Eiron and Royal Hansen for their support. Finally, we thank the anonymous reviewers and our shepherd, Eric Eide, for their constructive feedback.
Além disso, várias pessoas ajudaram a melhorar este artigo. Recebemos comentários perspicazes de David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen e Lawrence You. Também somos gratos a Nadav Eiron e Royal Hansen pelo apoio. Por fim, agradecemos aos revisores anônimos e ao nosso shepherd, Eric Eide, pelo feedback construtivo.