Determining whether online users are authorized to access digital objects is central to preserving privacy. This paper presents the design, implementation, and deployment of Zanzibar, a global system for storing and evaluating access control lists. Zanzibar provides a uniform data model and configuration language for expressing a wide range of access control policies from hundreds of client services at Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Its authorization decisions respect causal ordering of user actions and thus provide external consistency amid changes to access control lists and object contents. Zanzibar scales to trillions of access control lists and millions of authorization requests per second to support services used by billions of people. It has maintained 95th-percentile latency of less than 10 milliseconds and availability of greater than 99.999% over 3 years of production use.
Determinar si los usuarios en línea están autorizados a acceder a objetos digitales es fundamental para preservar la privacidad. Este artículo presenta el diseño, la implementación y el despliegue de Zanzibar, un sistema global para almacenar y evaluar listas de control de acceso. Zanzibar proporciona un modelo de datos y un lenguaje de configuración uniformes para expresar una amplia variedad de políticas de control de acceso de cientos de servicios cliente de Google, entre ellos Calendar, Cloud, Drive, Maps, Photos y YouTube. Sus decisiones de autorización respetan el orden causal de las acciones de los usuarios y, por lo tanto, proporcionan consistencia externa ante los cambios en las listas de control de acceso y en el contenido de los objetos. Zanzibar escala a billones de listas de control de acceso y a millones de solicitudes de autorización por segundo para dar soporte a servicios utilizados por miles de millones de personas. Ha mantenido una latencia en el percentil 95 inferior a 10 milisegundos y una disponibilidad superior al 99.999% a lo largo de 3 años de uso en producción.
Many online interactions require authorization checks to confirm that a user has permission to carry out an operation on a digital object. For example, web-based photo storage services typically allow photo owners to share some photos with friends while keeping other photos private. Such a service must check whether a photo has been shared with a user before allowing that user to view the photo. Robust authorization checks are central to preserving online privacy.
Muchas interacciones en línea requieren comprobaciones de autorización para confirmar que un usuario tiene permiso para realizar una operación sobre un objeto digital. Por ejemplo, los servicios web de almacenamiento de fotos suelen permitir a los propietarios de las fotos compartir algunas de ellas con amigos y mantener otras privadas. Un servicio de este tipo debe comprobar si una foto se ha compartido con un usuario antes de permitir que ese usuario la vea. Unas comprobaciones de autorización robustas son fundamentales para preservar la privacidad en línea.
This paper presents Zanzibar, a system for storing permissions and performing authorization checks based on the stored permissions. It is used by a wide array of services offered by Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Several of these services manage billions of objects on behalf of more than a billion users.
Este artículo presenta Zanzibar, un sistema para almacenar permisos y realizar comprobaciones de autorización basadas en los permisos almacenados. Lo utiliza una amplia gama de servicios ofrecidos por Google, entre ellos Calendar, Cloud, Drive, Maps, Photos y YouTube. Varios de estos servicios gestionan miles de millones de objetos en nombre de más de mil millones de usuarios.
A unified authorization system offers important advantages over maintaining separate access control mechanisms for individual applications. First, it helps establish consistent semantics and user experience across applications. Second, it makes it easier for applications to interoperate, for example, to coordinate access control when an object from one application embeds an object from another application. Third, useful common infrastructure can be built on top of a unified access control system, in particular, a search index that respects access control and works across applications. Finally, as we show below, authorization poses unique challenges involving data consistency and scalability. It saves engineering resources to tackle them once across applications.
Un sistema de autorización unificado ofrece ventajas importantes frente a mantener mecanismos de control de acceso separados para cada aplicación. En primer lugar, ayuda a establecer una semántica y una experiencia de usuario consistentes entre aplicaciones. En segundo lugar, facilita la interoperabilidad entre aplicaciones, por ejemplo, para coordinar el control de acceso cuando un objeto de una aplicación incrusta un objeto de otra aplicación. En tercer lugar, sobre un sistema de control de acceso unificado puede construirse una infraestructura común útil, en particular, un índice de búsqueda que respete el control de acceso y funcione entre aplicaciones. Por último, como mostramos más adelante, la autorización plantea desafíos únicos relacionados con la consistencia de los datos y la escalabilidad. Abordarlos una sola vez para todas las aplicaciones ahorra recursos de ingeniería.
We have the following goals for the Zanzibar system:
Para el sistema Zanzibar nos planteamos los siguientes objetivos:
- Correctness: It must ensure consistency of access control decisions to respect user intentions.
- Flexibility: It must support a rich set of access control policies as required by both consumer and enterprise applications.
- Low latency: It must respond quickly because authorization checks are often in the critical path of user interactions. Low latency at the tail is particularly important for serving search results, which often require tens to hundreds of checks.
- High availability: It must reliably respond to requests because, in the absence of explicit authorizations, client services would be forced to deny their users access.
- Large scale: It needs to protect billions of objects shared by billions of users. It must be deployed around the globe to be near its clients and their end users.
- Corrección: debe garantizar la consistencia de las decisiones de control de acceso para respetar las intenciones de los usuarios.
- Flexibilidad: debe admitir un conjunto amplio de políticas de control de acceso, según lo requieran tanto las aplicaciones de consumo como las empresariales.
- Baja latencia: debe responder con rapidez, porque las comprobaciones de autorización se encuentran a menudo en la ruta crítica de las interacciones de los usuarios. La baja latencia en la cola es especialmente importante para servir resultados de búsqueda, que con frecuencia requieren de decenas a cientos de comprobaciones.
- Alta disponibilidad: debe responder a las solicitudes de forma fiable, porque, a falta de autorizaciones explícitas, los servicios cliente se verían obligados a denegar el acceso a sus usuarios.
- Gran escala: necesita proteger miles de millones de objetos compartidos por miles de millones de usuarios. Debe desplegarse en todo el mundo para estar cerca de sus clientes y de los usuarios finales de estos.
Zanzibar achieves these goals through a combination of notable features. To provide flexibility, Zanzibar pairs a simple data model with a powerful configuration language. The language allows clients to define arbitrary relations between users and objects, such as owner, editor, commenter, and viewer. It includes set-algebraic operators such as intersection and union for specifying potentially complex access control policies in terms of those user-object relations. For example, an application can specify that users granted editing rights on a document are also allowed to comment on the document, but not all commenters are given editing rights.
Zanzibar alcanza estos objetivos mediante una combinación de características notables. Para proporcionar flexibilidad, Zanzibar combina un modelo de datos sencillo con un lenguaje de configuración potente. El lenguaje permite a los clientes definir relaciones arbitrarias entre usuarios y objetos, como owner, editor, commenter y viewer. Incluye operadores de álgebra de conjuntos, como la intersección y la unión, para especificar políticas de control de acceso potencialmente complejas en términos de esas relaciones entre usuarios y objetos. Por ejemplo, una aplicación puede especificar que los usuarios a los que se conceden derechos de edición sobre un documento también pueden comentar el documento, pero que no todos los comentaristas reciben derechos de edición.
At runtime, Zanzibar allows clients to create, modify, and evaluate access control lists (ACLs) through a remote procedure call (RPC) interface. A simple ACL takes the form of “user U has relation R to object O”. More complex ACLs take the form of “set of users S has relation R to object O”, where S is itself specified in terms of another object-relation pair. ACLs can thus refer to other ACLs, for example to specify that the set of users who can comment on a video consists of the users who have been granted viewing rights on that specific video along with those with viewing permissions on the video channel.
En tiempo de ejecución, Zanzibar permite a los clientes crear, modificar y evaluar listas de control de acceso (ACL) mediante una interfaz de llamada a procedimiento remoto (RPC). Una ACL simple adopta la forma “el usuario U tiene la relación R con el objeto O”. Las ACL más complejas adoptan la forma “el conjunto de usuarios S tiene la relación R con el objeto O”, donde S se especifica a su vez en términos de otro par objeto-relación. Así, las ACL pueden hacer referencia a otras ACL, por ejemplo, para especificar que el conjunto de usuarios que pueden comentar un vídeo está formado por los usuarios a los que se han concedido derechos de visualización sobre ese vídeo concreto junto con quienes tienen permisos de visualización sobre el canal del vídeo.
Group memberships are an important class of ACL where the object is a group and the relation is semantically equivalent to member. Groups can contain other groups, which illustrates one of the challenges facing Zanzibar, namely that evaluating whether a user belongs to a group can entail following a long chain of nested group memberships.
Las pertenencias a grupos son una clase importante de ACL en la que el objeto es un grupo y la relación es semánticamente equivalente a member. Los grupos pueden contener otros grupos, lo que ilustra uno de los desafíos a los que se enfrenta Zanzibar, a saber, que evaluar si un usuario pertenece a un grupo puede implicar seguir una larga cadena de pertenencias a grupos anidados.
Authorization checks take the form of “does user U have relation R to object O?” and are evaluated by a collection of distributed servers. When a check request arrives to Zanzibar, the work to evaluate the check may fan out to multiple servers, for example when a group contains both individual members and other groups. Each of those servers may in turn contact other servers, for example to recursively traverse a hierarchy of group memberships.
Las comprobaciones de autorización adoptan la forma “¿tiene el usuario U la relación R con el objeto O?” y las evalúa un conjunto de servidores distribuidos. Cuando llega a Zanzibar una solicitud de comprobación, el trabajo para evaluarla puede repartirse entre varios servidores, por ejemplo, cuando un grupo contiene tanto miembros individuales como otros grupos. Cada uno de esos servidores puede, a su vez, contactar con otros servidores, por ejemplo, para recorrer recursivamente una jerarquía de pertenencias a grupos.
Zanzibar operates at a global scale along multiple dimensions. It stores more than two trillion ACLs and performs millions of authorization checks per second. The ACL data does not lend itself to geographic partitioning because authorization checks for any object can come from anywhere in the world. Therefore, Zanzibar replicates all ACL data in tens of geographically distributed data centers and distributes load across thousands of servers around the world.
Zanzibar opera a escala global en múltiples dimensiones. Almacena más de dos billones de ACL y realiza millones de comprobaciones de autorización por segundo. Los datos de las ACL no se prestan a una partición geográfica, porque las comprobaciones de autorización de cualquier objeto pueden proceder de cualquier parte del mundo. Por ello, Zanzibar replica todos los datos de las ACL en decenas de centros de datos distribuidos geográficamente y reparte la carga entre miles de servidores de todo el mundo.
Zanzibar supports global consistency of access control decisions through two interrelated features. One, it respects the order in which ACL changes are committed to the underlying data store. Two, it can ensure that authorization checks are based on ACL data no older than a client-specified change. Thus, for example, a client can remove a user from a group and be assured that subsequent membership checks reflect that removal. Zanzibar provides these ordering properties by storing ACLs in a globally distributed database system with external consistency guarantees [15, 18].
Zanzibar ofrece consistencia global de las decisiones de control de acceso mediante dos características interrelacionadas. Primera, respeta el orden en que los cambios de las ACL se confirman en el almacén de datos subyacente. Segunda, puede garantizar que las comprobaciones de autorización se basen en datos de ACL no más antiguos que un cambio especificado por el cliente. Así, por ejemplo, un cliente puede eliminar a un usuario de un grupo y tener la certeza de que las comprobaciones de pertenencia posteriores reflejarán esa eliminación. Zanzibar proporciona estas propiedades de ordenación almacenando las ACL en un sistema de base de datos distribuido globalmente con garantías de consistencia externa [15, 18].
Zanzibar employs an array of techniques to achieve low latency and high availability in this globally distributed environment. Its consistency protocol allows the vast majority of requests to be served with locally replicated data, without requiring cross-region round trips. Zanzibar stores its data in normalized forms for consistency. It handles hot spots on normalized data by caching final and intermediate results, and by deduplicating simultaneous requests. It also applies techniques such as hedging requests and optimizing computations on deeply nested sets with limited denormalization. Zanzibar responds to more than 95% of authorization checks within 10 milliseconds and has maintained more than 99.999% availability for the last 3 years.
Zanzibar emplea una serie de técnicas para lograr baja latencia y alta disponibilidad en este entorno distribuido globalmente. Su protocolo de consistencia permite servir la gran mayoría de las solicitudes con datos replicados localmente, sin necesidad de viajes de ida y vuelta entre regiones. Zanzibar almacena sus datos en formas normalizadas por motivos de consistencia. Gestiona los puntos calientes sobre los datos normalizados almacenando en caché los resultados finales e intermedios y deduplicando las solicitudes simultáneas. También aplica técnicas como las solicitudes de cobertura (hedging) y la optimización de los cálculos sobre conjuntos profundamente anidados con una desnormalización limitada. Zanzibar responde a más del 95% de las comprobaciones de autorización en menos de 10 milisegundos y ha mantenido una disponibilidad superior al 99.999% durante los últimos 3 años.
The main contributions of this paper lie in conveying the engineering challenges in building and deploying a consistent, world-scale authorization system. While most elements of Zanzibar’s design have their roots in previous research, this paper provides a record of the features and techniques Zanzibar brings together to satisfy its stringent requirements for correctness, flexibility, latency, availability, and scalability. The paper also highlights lessons learned from operating Zanzibar in service of a diverse set of demanding clients.
Las principales contribuciones de este artículo consisten en transmitir los desafíos de ingeniería que plantea construir y desplegar un sistema de autorización consistente a escala mundial. Aunque la mayoría de los elementos del diseño de Zanzibar tienen sus raíces en investigaciones previas, este artículo deja constancia de las características y técnicas que Zanzibar reúne para satisfacer sus estrictos requisitos de corrección, flexibilidad, latencia, disponibilidad y escalabilidad. El artículo también destaca las lecciones aprendidas al operar Zanzibar al servicio de un conjunto diverso de clientes exigentes.
This section describes Zanzibar’s data model, configuration language, and application programming interface (API).
Esta sección describe el modelo de datos, el lenguaje de configuración y la interfaz de programación de aplicaciones (API) de Zanzibar.
In Zanzibar, ACLs are collections of object-user or object-object relations represented as relation tuples. Groups are simply ACLs with membership semantics. Relation tuples have efficient binary encodings, but in this paper we represent them using a convenient text notation:
En Zanzibar, las ACL son colecciones de relaciones objeto-usuario u objeto-objeto representadas como tuplas de relación. Los grupos son simplemente ACL con semántica de pertenencia. Las tuplas de relación tienen codificaciones binarias eficientes, pero en este artículo las representamos mediante una notación textual práctica:
where ⟨namespace⟩ and ⟨relation⟩ are predefined in client configurations (§2.3), ⟨object_id⟩ is a string, and ⟨user_id⟩ is an integer. The primary keys required to identify a relation tuple are ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩, and ⟨user⟩. One feature worth noting is that a ⟨userset⟩ allows ACLs to refer to groups and thus supports representing nested group membership.
donde ⟨namespace⟩ y ⟨relation⟩ están predefinidos en las configuraciones de los clientes (§2.3), ⟨object_id⟩ es una cadena y ⟨user_id⟩ es un entero. Las claves primarias necesarias para identificar una tupla de relación son ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩ y ⟨user⟩. Una característica digna de mención es que un ⟨userset⟩ permite que las ACL hagan referencia a grupos y, por tanto, admite la representación de pertenencias a grupos anidados.
Table 1 shows some example tuples and corresponding semantics. While some relations (e.g. viewer) define access control directly, others (e.g. parent, pointing to a folder) only define abstract relations between objects. These abstract relations may indirectly affect access control given userset rewrite rules specified in namespace configs (§2.3.1).
La Tabla 1 muestra algunas tuplas de ejemplo y su semántica correspondiente. Mientras que algunas relaciones (p. ej., viewer) definen el control de acceso directamente, otras (p. ej., parent, que apunta a una carpeta) solo definen relaciones abstractas entre objetos. Estas relaciones abstractas pueden afectar indirectamente al control de acceso en virtud de las reglas de reescritura de usersets especificadas en las configuraciones de los espacios de nombres (§2.3.1).
Table 1: Example relation tuples. “#...” represents a relation that does not affect the semantics of the tuple.
Tabla 1: Tuplas de relación de ejemplo. “#...” representa una relación que no afecta a la semántica de la tupla.
Defining our data model around tuples, instead of per-object ACLs, allows us to unify the concepts of ACLs and groups and to support efficient reads and incremental updates, as we will see in §2.4.
Definir nuestro modelo de datos en torno a tuplas, en lugar de ACL por objeto, nos permite unificar los conceptos de ACL y de grupo y admitir lecturas eficientes y actualizaciones incrementales, como veremos en §2.4.
ACL checks must respect the order in which users modify ACLs and object contents to avoid unexpected sharing behaviors. Specifically, our clients care about preventing the “new enemy” problem, which can arise when we fail to respect the ordering between ACL updates or when we apply old ACLs to new content. Consider these two examples:
Las comprobaciones de ACL deben respetar el orden en que los usuarios modifican las ACL y el contenido de los objetos para evitar comportamientos de compartición inesperados. En concreto, a nuestros clientes les importa prevenir el problema del “nuevo enemigo”, que puede surgir cuando no respetamos el orden entre actualizaciones de ACL o cuando aplicamos ACL antiguas a contenido nuevo. Considérense estos dos ejemplos:
Example A: Neglecting ACL update order
- Alice removes Bob from the ACL of a folder;
- Alice then asks Charlie to move new documents to the folder, where document ACLs inherit from folder ACLs;
- Bob should not be able to see the new documents, but may do so if the ACL check neglects the ordering between the two ACL changes.
Ejemplo A: desatender el orden de actualización de las ACL
- Alice elimina a Bob de la ACL de una carpeta;
- a continuación, Alice pide a Charlie que mueva documentos nuevos a la carpeta, donde las ACL de los documentos heredan de las ACL de la carpeta;
- Bob no debería poder ver los documentos nuevos, pero podría hacerlo si la comprobación de ACL desatiende el orden entre los dos cambios de ACL.
Example B: Misapplying old ACL to new content
- Alice removes Bob from the ACL of a document;
- Alice then asks Charlie to add new contents to the document;
- Bob should not be able to see the new contents, but may do so if the ACL check is evaluated with a stale ACL from before Bob’s removal.
Ejemplo B: aplicar erróneamente una ACL antigua a contenido nuevo
- Alice elimina a Bob de la ACL de un documento;
- a continuación, Alice pide a Charlie que añada contenido nuevo al documento;
- Bob no debería poder ver el contenido nuevo, pero podría hacerlo si la comprobación de ACL se evalúa con una ACL obsoleta anterior a la eliminación de Bob.
Preventing the “new enemy” problem requires Zanzibar to understand and respect the causal ordering between ACL or content updates, including updates on different ACLs or objects and those coordinated via channels invisible to Zanzibar. Hence Zanzibar must provide two key consistency properties: external consistency [18] and snapshot reads with bounded staleness.
Prevenir el problema del “nuevo enemigo” requiere que Zanzibar comprenda y respete el orden causal entre las actualizaciones de ACL o de contenido, incluidas las actualizaciones sobre ACL u objetos distintos y las coordinadas a través de canales invisibles para Zanzibar. Por ello, Zanzibar debe proporcionar dos propiedades de consistencia clave: consistencia externa [18] y lecturas de instantánea con desactualización acotada.
External consistency allows Zanzibar to assign a timestamp to each ACL or content update, such that two causally related updates will be assigned timestamps that reflect the causal order: . With causally meaningful timestamps, a snapshot read of the ACL database at timestamp , which observes all updates with timestamps , will respect ordering between ACL updates. That is, if the read observes an update , it will observe all updates that happen causally before .
La consistencia externa permite a Zanzibar asignar una marca de tiempo a cada actualización de ACL o de contenido, de modo que a dos actualizaciones causalmente relacionadas se les asignen marcas de tiempo que reflejen el orden causal: . Con marcas de tiempo causalmente significativas, una lectura de instantánea de la base de datos de ACL en la marca de tiempo , que observa todas las actualizaciones con marcas de tiempo , respetará el orden entre las actualizaciones de ACL. Es decir, si la lectura observa una actualización , observará todas las actualizaciones que ocurren causalmente antes de .
Furthermore, to avoid applying old ACLs to new contents, the ACL check evaluation snapshot must not be staler than the causal timestamp assigned to the content update. Given a content update at timestamp , a snapshot read at timestamp ensures that all ACL updates that happen causally before the content update will be observed by the ACL check.
Además, para evitar aplicar ACL antiguas a contenido nuevo, la instantánea de evaluación de la comprobación de ACL no debe estar más desactualizada que la marca de tiempo causal asignada a la actualización del contenido. Dada una actualización de contenido en la marca de tiempo , una lectura de instantánea en una marca de tiempo garantiza que la comprobación de ACL observará todas las actualizaciones de ACL que ocurren causalmente antes de la actualización del contenido.
To provide external consistency and snapshot reads with bounded staleness, we store ACLs in the Spanner global database system [15]. Spanner’s TrueTime mechanism assigns each ACL write a microsecond-resolution timestamp, such that the timestamps of writes reflect the causal ordering between writes, and thereby provide external consistency. We evaluate each ACL check at a single snapshot timestamp across multiple database reads, so that all writes with timestamps up to the check snapshot, and only those writes, are visible to the ACL check.
Para proporcionar consistencia externa y lecturas de instantánea con desactualización acotada, almacenamos las ACL en el sistema de base de datos global Spanner [15]. El mecanismo TrueTime de Spanner asigna a cada escritura de ACL una marca de tiempo con resolución de microsegundos, de modo que las marcas de tiempo de las escrituras reflejan el orden causal entre ellas y proporcionan así consistencia externa. Evaluamos cada comprobación de ACL en una única marca de tiempo de instantánea a lo largo de múltiples lecturas de la base de datos, de modo que todas las escrituras con marcas de tiempo hasta la instantánea de la comprobación, y solo esas escrituras, son visibles para la comprobación de ACL.
To avoid evaluating checks for new contents using stale ACLs, one could try to always evaluate at the latest snapshot such that the check result reflects all ACL writes up to the check call. However, such evaluation would require global data synchronization with high-latency round trips and limited availability. Instead, we design the following protocol to allow most checks to be evaluated on already replicated data with cooperation from Zanzibar clients:
Para evitar evaluar comprobaciones de contenido nuevo con ACL obsoletas, se podría intentar evaluar siempre en la instantánea más reciente, de modo que el resultado de la comprobación refleje todas las escrituras de ACL hasta la llamada de comprobación. Sin embargo, tal evaluación requeriría una sincronización global de los datos, con viajes de ida y vuelta de alta latencia y una disponibilidad limitada. En su lugar, diseñamos el siguiente protocolo para permitir que la mayoría de las comprobaciones se evalúen sobre datos ya replicados, con la cooperación de los clientes de Zanzibar:
- A Zanzibar client requests an opaque consistency token called a zookie for each content version, via a content-change ACL check (§2.4.4) when the content modification is about to be saved. Zanzibar encodes a current global timestamp in the zookie and ensures that all prior ACL writes have lower timestamps. The client stores the zookie with the content change in an atomic write to the client storage. Note that the content-change check does not need to be evaluated in the same transaction as the application content modification, but only has to be triggered when the user modifies the contents.
- The client sends this zookie in subsequent ACL check requests to ensure that the check snapshot is at least as fresh as the timestamp for the content version.
- Un cliente de Zanzibar solicita un token de consistencia opaco llamado zookie para cada versión del contenido, mediante una comprobación de ACL de cambio de contenido (§2.4.4) cuando la modificación del contenido está a punto de guardarse. Zanzibar codifica una marca de tiempo global actual en el zookie y garantiza que todas las escrituras de ACL anteriores tengan marcas de tiempo menores. El cliente almacena el zookie junto con el cambio de contenido en una escritura atómica en el almacenamiento del cliente. Obsérvese que la comprobación de cambio de contenido no necesita evaluarse en la misma transacción que la modificación del contenido de la aplicación, sino que solo tiene que desencadenarse cuando el usuario modifica el contenido.
- El cliente envía este zookie en las solicitudes de comprobación de ACL posteriores para garantizar que la instantánea de la comprobación sea al menos tan reciente como la marca de tiempo de la versión del contenido.
External consistency and snapshot reads with staleness bounded by zookie prevent the “new enemy” problem. In Example A, ACL updates A1 and A2 will be assigned timestamps , respectively. Bob will not be able to see the new documents added by Charlie: if a check is evaluated at , the document ACLs will not include the folder ACL; if a check is evaluated at , the check will observe update A1, which removed Bob from the folder ACL. In Example B, Bob will not see the new contents added to the document. For Bob to see the new contents, the check must be evaluated with a zookie , the timestamp assigned to the content update. Because , such a check will also observe the ACL update B1, which removed Bob from the ACL.
La consistencia externa y las lecturas de instantánea con una desactualización acotada por el zookie previenen el problema del “nuevo enemigo”. En el Ejemplo A, a las actualizaciones de ACL A1 y A2 se les asignarán las marcas de tiempo , respectivamente. Bob no podrá ver los documentos nuevos añadidos por Charlie: si una comprobación se evalúa en , las ACL de los documentos no incluirán la ACL de la carpeta; si una comprobación se evalúa en , la comprobación observará la actualización A1, que eliminó a Bob de la ACL de la carpeta. En el Ejemplo B, Bob no verá el contenido nuevo añadido al documento. Para que Bob vea el contenido nuevo, la comprobación debe evaluarse con un zookie , la marca de tiempo asignada a la actualización del contenido. Como , tal comprobación observará también la actualización de ACL B1, que eliminó a Bob de la ACL.
The zookie protocol is a key feature of Zanzibar’s consistency model. It ensures that Zanzibar respects causal ordering between ACL and content updates, but otherwise grants Zanzibar freedom to choose evaluation timestamps so as to meet its latency and availability goals. The freedom arises from the protocol’s at-least-as-fresh semantics, which allow Zanzibar to choose any timestamp fresher than the one encoded in a zookie. Such freedom in turn allows Zanzibar to serve most checks at a default staleness with already replicated data (§3.2.1) and to quantize evaluation timestamps to avoid hot spots (§3.2.5).
El protocolo de zookies es una característica clave del modelo de consistencia de Zanzibar. Garantiza que Zanzibar respete el orden causal entre las actualizaciones de ACL y de contenido, pero, por lo demás, concede a Zanzibar libertad para elegir las marcas de tiempo de evaluación con el fin de cumplir sus objetivos de latencia y disponibilidad. Esta libertad se deriva de la semántica de “al menos tan reciente” del protocolo, que permite a Zanzibar elegir cualquier marca de tiempo más reciente que la codificada en un zookie. A su vez, dicha libertad permite a Zanzibar servir la mayoría de las comprobaciones con una desactualización predeterminada a partir de datos ya replicados (§3.2.1) y cuantizar las marcas de tiempo de evaluación para evitar puntos calientes (§3.2.5).
Before clients can store relation tuples in Zanzibar, they must configure their namespaces. A namespace configuration specifies its relations as well as its storage parameters. Each relation has a name, which is a client-defined string such as viewer or editor, and a relation config. Storage parameters include sharding settings and an encoding for object IDs that helps Zanzibar optimize storage of integer, string, and other object ID formats.
Antes de que los clientes puedan almacenar tuplas de relación en Zanzibar, deben configurar sus espacios de nombres. La configuración de un espacio de nombres especifica sus relaciones, así como sus parámetros de almacenamiento. Cada relación tiene un nombre, que es una cadena definida por el cliente como viewer o editor, y una configuración de relación. Los parámetros de almacenamiento incluyen los ajustes de fragmentación y una codificación de los ID de objeto que ayuda a Zanzibar a optimizar el almacenamiento de ID de objeto enteros, de cadena y de otros formatos.
2.3.1Relation Configs and Userset Rewrites
2.3.1Configuraciones de relación y reescrituras de usersets
While relation tuples reflect relationships between objects and users, they do not completely define the effective ACLs. For example, some clients specify that users with editor permissions on each object should have viewer permission on the same object. While such relationships between relations can be represented by a relation tuple per object, storing a tuple for each object in a namespace would be wasteful and make it hard to make modifications across all objects. Instead, we let clients define object-agnostic relationships via userset rewrite rules in relation configs. Figure 1 demonstrates a simple namespace configuration with concentric relations, where viewer contains editor, and editor contains owner.
Aunque las tuplas de relación reflejan las relaciones entre objetos y usuarios, no definen por completo las ACL efectivas. Por ejemplo, algunos clientes especifican que los usuarios con permisos editor sobre cada objeto deben tener el permiso viewer sobre ese mismo objeto. Aunque tales relaciones entre relaciones pueden representarse mediante una tupla de relación por objeto, almacenar una tupla para cada objeto de un espacio de nombres sería un derroche y dificultaría realizar modificaciones en todos los objetos. En su lugar, permitimos que los clientes definan relaciones independientes del objeto mediante reglas de reescritura de usersets en las configuraciones de relación. La Figura 1 muestra una configuración sencilla de un espacio de nombres con relaciones concéntricas, donde viewer contiene a editor y editor contiene a owner.
Figure 1: Simple namespace configuration with concentric relations on documents. All owners are editors, and all editors are viewers. Further, viewers of the parent folder are also viewers of the document.
Figura 1: Configuración sencilla de un espacio de nombres con relaciones concéntricas sobre documentos. Todos los propietarios son editores y todos los editores son lectores. Además, los lectores de la carpeta padre también son lectores del documento.
Userset rewrite rules are defined per relation in a namespace. Each rule specifies a function that takes an object ID as input and outputs a userset expression tree. Each leaf node of the tree can be any of the following:
Las reglas de reescritura de usersets se definen por relación dentro de un espacio de nombres. Cada regla especifica una función que toma como entrada un ID de objeto y produce como salida un árbol de expresiones de usersets. Cada nodo hoja del árbol puede ser cualquiera de los siguientes:
_this: Returns all users from stored relation tuples for the ⟨object#relation⟩ pair, including indirect ACLs referenced by usersets from the tuples. This is the default behavior when no rewrite rule is specified.computed_userset: Computes, for the input object, a new userset. For example, this allows the userset expression for aviewerrelation to refer to theeditoruserset on the same object, thus offering an ACL inheritance capability between relations.tuple_to_userset: Computes a tupleset (§2.4.1) from the input object, fetches relation tuples matching the tupleset, and computes a userset from every fetched relation tuple. This flexible primitive allows our clients to express complex policies such as “look up the parent folder of the document and inherit its viewers”.
_this: devuelve todos los usuarios de las tuplas de relación almacenadas para el par ⟨object#relation⟩, incluidas las ACL indirectas referenciadas por los usersets de las tuplas. Este es el comportamiento predeterminado cuando no se especifica ninguna regla de reescritura.computed_userset: calcula, para el objeto de entrada, un nuevo userset. Por ejemplo, esto permite que la expresión de userset de una relaciónviewerhaga referencia al userseteditordel mismo objeto, lo que ofrece una capacidad de herencia de ACL entre relaciones.tuple_to_userset: calcula un conjunto de tuplas (§2.4.1) a partir del objeto de entrada, obtiene las tuplas de relación que coinciden con el conjunto de tuplas y calcula un userset a partir de cada tupla de relación obtenida. Esta primitiva flexible permite a nuestros clientes expresar políticas complejas como “buscar la carpeta padre del documento y heredar sus lectores”.
A userset expression can also be composed of multiple sub-expressions, combined by operations such as union, intersection, and exclusion.
Una expresión de userset también puede componerse de múltiples subexpresiones, combinadas mediante operaciones como la unión, la intersección y la exclusión.
In addition to supporting ACL checks, Zanzibar also provides APIs for clients to read and write relation tuples, watch tuple updates, and inspect the effective ACLs.
Además de admitir comprobaciones de ACL, Zanzibar también proporciona API para que los clientes lean y escriban tuplas de relación, observen las actualizaciones de tuplas e inspeccionen las ACL efectivas.
A concept used throughout these API methods is that of a zookie. A zookie is an opaque byte sequence encoding a globally meaningful timestamp that reflects an ACL write, a client content version, or a read snapshot. Zookies in ACL read and check requests specify staleness bounds for snapshot reads, thus providing one of Zanzibar’s core consistency properties. We choose to use an opaque cookie instead of the actual timestamp to discourage our clients from choosing arbitrary timestamps and to allow future extensions.
Un concepto utilizado en todos estos métodos de la API es el de zookie. Un zookie es una secuencia de bytes opaca que codifica una marca de tiempo con significado global que refleja una escritura de ACL, una versión de contenido del cliente o una instantánea de lectura. Los zookies de las solicitudes de lectura y de comprobación de ACL especifican cotas de desactualización para las lecturas de instantánea, con lo que proporcionan una de las propiedades de consistencia centrales de Zanzibar. Optamos por utilizar una cookie opaca en lugar de la marca de tiempo real para disuadir a nuestros clientes de elegir marcas de tiempo arbitrarias y para permitir extensiones futuras.
Our clients read relation tuples to display ACLs or group membership to users, or to prepare for a subsequent write. A read request specifies one or multiple tuplesets and an optional zookie.
Nuestros clientes leen tuplas de relación para mostrar a los usuarios las ACL o la pertenencia a grupos, o para preparar una escritura posterior. Una solicitud de lectura especifica uno o varios conjuntos de tuplas y un zookie opcional.
Each tupleset specifies keys of a set of relation tuples. The set can include a single tuple key, or all tuples with a given object ID or userset in a namespace, optionally constrained by a relation name. With the tuplesets, clients can look up a specific membership entry, read all entries in an ACL or group, or look up all groups with a given user as a direct member. All tuplesets in a read request are processed at a single snapshot.
Cada conjunto de tuplas especifica las claves de un conjunto de tuplas de relación. El conjunto puede incluir una única clave de tupla, o todas las tuplas con un ID de objeto o userset dado dentro de un espacio de nombres, opcionalmente restringidas por un nombre de relación. Con los conjuntos de tuplas, los clientes pueden buscar una entrada de pertenencia concreta, leer todas las entradas de una ACL o de un grupo, o buscar todos los grupos que tienen a un usuario dado como miembro directo. Todos los conjuntos de tuplas de una solicitud de lectura se procesan en una única instantánea.
With the zookie, clients can request a read snapshot no earlier than a previous write if the zookie from the write response is given in the read request, or at the same snapshot as a previous read if the zookie from the earlier read response is given in the subsequent request. If the request doesn’t contain a zookie, Zanzibar will choose a reasonably recent snapshot, possibly offering a lower-latency response than if a zookie were provided.
Con el zookie, los clientes pueden solicitar una instantánea de lectura no anterior a una escritura previa, si en la solicitud de lectura se proporciona el zookie de la respuesta de la escritura, o en la misma instantánea que una lectura previa, si en la solicitud posterior se proporciona el zookie de la respuesta de la lectura anterior. Si la solicitud no contiene un zookie, Zanzibar elegirá una instantánea razonablemente reciente, lo que posiblemente ofrezca una respuesta de menor latencia que si se proporcionara un zookie.
Read results only depend on contents of relation tuples and do not reflect userset rewrite rules. For example, even if the viewer userset always includes the owner userset, reading tuples with the viewer relation will not return tuples with the owner relation. Clients that need to understand the effective userset can use the Expand API (§2.4.5).
Los resultados de lectura dependen únicamente del contenido de las tuplas de relación y no reflejan las reglas de reescritura de usersets. Por ejemplo, aunque el userset viewer incluya siempre el userset owner, leer las tuplas con la relación viewer no devolverá las tuplas con la relación owner. Los clientes que necesitan comprender el userset efectivo pueden utilizar la API Expand (§2.4.5).
Clients may modify a single relation tuple to add or remove an ACL. They may also modify all tuples related to an object via a read-modify-write process with optimistic concurrency control [21] that uses a read RPC followed by a write RPC:
Los clientes pueden modificar una única tupla de relación para añadir o eliminar una ACL. También pueden modificar todas las tuplas relacionadas con un objeto mediante un proceso de lectura-modificación-escritura con control de concurrencia optimista [21] que utiliza una RPC de lectura seguida de una RPC de escritura:
- Read all relation tuples of an object, including a per-object “lock” tuple.
- Generate the tuples to write or delete. Send the writes, along with a touch on the lock tuple, to Zanzibar, with the condition that the writes will be committed only if the lock tuple has not been modified since the read.
- If the write condition is not met, go back to step 1.
- Leer todas las tuplas de relación de un objeto, incluida una tupla de “bloqueo” por objeto.
- Generar las tuplas que se van a escribir o eliminar. Enviar las escrituras a Zanzibar, junto con un toque (touch) sobre la tupla de bloqueo, con la condición de que las escrituras solo se confirmen si la tupla de bloqueo no se ha modificado desde la lectura.
- Si no se cumple la condición de escritura, volver al paso 1.
The lock tuple is just a regular relation tuple used by clients to detect write races.
La tupla de bloqueo no es más que una tupla de relación normal que los clientes utilizan para detectar carreras de escritura.
Some clients maintain secondary indices of relation tuples in Zanzibar. They can do so with our Watch API. A watch request specifies one or more namespaces and a zookie representing the time to start watching. A watch response contains all tuple modification events in ascending timestamp order, from the requested start timestamp to a timestamp encoded in a heartbeat zookie included in the watch response. The client can use the heartbeat zookie to resume watching where the previous watch response left off.
Algunos clientes mantienen índices secundarios de las tuplas de relación de Zanzibar. Pueden hacerlo con nuestra API Watch. Una solicitud de observación especifica uno o varios espacios de nombres y un zookie que representa el momento en que se empieza a observar. Una respuesta de observación contiene todos los eventos de modificación de tuplas en orden ascendente de marca de tiempo, desde la marca de tiempo de inicio solicitada hasta una marca de tiempo codificada en un zookie de latido (heartbeat zookie) incluido en la respuesta de observación. El cliente puede utilizar el zookie de latido para reanudar la observación donde la dejó la respuesta de observación anterior.
A check request specifies a userset, represented by ⟨object#relation⟩, a putative user, often represented by an authentication token, and a zookie corresponding to the desired object version. Like reads, a check is always evaluated at a consistent snapshot no earlier than the given zookie.
Una solicitud de comprobación especifica un userset, representado por ⟨object#relation⟩, un supuesto usuario, a menudo representado por un token de autenticación, y un zookie correspondiente a la versión deseada del objeto. Al igual que las lecturas, una comprobación se evalúa siempre en una instantánea consistente no anterior al zookie dado.
To authorize application content modifications, our clients send a special type of check request, a content-change check. A content-change check request does not carry a zookie and is evaluated at the latest snapshot. If a content change is authorized, the check response includes a zookie for clients to store along with object contents and use for subsequent checks of the content version. The zookie encodes the evaluation snapshot and captures any possible causality from ACL changes to content changes, because the zookie’s timestamp will be greater than that of the ACL updates that protect the new content (§2.2).
Para autorizar las modificaciones del contenido de las aplicaciones, nuestros clientes envían un tipo especial de solicitud de comprobación, una comprobación de cambio de contenido. Una solicitud de comprobación de cambio de contenido no lleva zookie y se evalúa en la instantánea más reciente. Si se autoriza un cambio de contenido, la respuesta de la comprobación incluye un zookie para que los clientes lo almacenen junto con el contenido del objeto y lo utilicen en las comprobaciones posteriores de esa versión del contenido. El zookie codifica la instantánea de evaluación y captura cualquier posible causalidad de los cambios de ACL a los cambios de contenido, porque la marca de tiempo del zookie será mayor que la de las actualizaciones de ACL que protegen el nuevo contenido (§2.2).
The Expand API returns the effective userset given an ⟨object#relation⟩ pair and an optional zookie. Unlike the Read API, Expand follows indirect references expressed through userset rewrite rules. The result is represented by a userset tree whose leaf nodes are user IDs or usersets pointing to other ⟨object#relation⟩ pairs, and intermediate nodes represent union, intersection, or exclusion operators. Expand is crucial for our clients to reason about the complete set of users and groups that have access to their objects, which allows them to build efficient search indices for access-controlled content.
La API Expand devuelve el userset efectivo dado un par ⟨object#relation⟩ y un zookie opcional. A diferencia de la API Read, Expand sigue las referencias indirectas expresadas mediante reglas de reescritura de usersets. El resultado se representa mediante un árbol de usersets cuyos nodos hoja son ID de usuario o usersets que apuntan a otros pares ⟨object#relation⟩, y cuyos nodos intermedios representan operadores de unión, intersección o exclusión. Expand es crucial para que nuestros clientes razonen sobre el conjunto completo de usuarios y grupos que tienen acceso a sus objetos, lo que les permite construir índices de búsqueda eficientes para contenido con control de acceso.
Figure 2 shows the architecture of the Zanzibar system. aclservers are the main server type. They are organized in clusters and respond to Check, Read, Expand, and Write requests. Requests arrive at any server in a cluster and that server fans out the work to other servers in the cluster as necessary. Those servers may in turn contact other servers to compute intermediate results. The initial server gathers the final result and returns it to the client.
La Figura 2 muestra la arquitectura del sistema Zanzibar. Los aclservers son el tipo de servidor principal. Están organizados en clústeres y responden a solicitudes Check, Read, Expand y Write. Las solicitudes llegan a cualquier servidor de un clúster y ese servidor reparte el trabajo entre otros servidores del clúster según sea necesario. Esos servidores pueden, a su vez, contactar con otros servidores para calcular resultados intermedios. El servidor inicial reúne el resultado final y lo devuelve al cliente.
Zanzibar stores ACLs and their metadata in Spanner databases. There is one database to store relation tuples for each client namespace, one database to hold all namespace configurations, and one changelog database shared across all namespaces. aclservers read and write those databases in the course of responding to client requests.
Zanzibar almacena las ACL y sus metadatos en bases de datos Spanner. Hay una base de datos para almacenar las tuplas de relación de cada espacio de nombres de cliente, una base de datos para contener todas las configuraciones de los espacios de nombres y una base de datos de registro de cambios compartida por todos los espacios de nombres. Los aclservers leen y escriben en esas bases de datos en el curso de la respuesta a las solicitudes de los clientes.
watchservers are a specialized server type that respond to Watch requests. They tail the changelog and serve a stream of namespace changes to clients in near real time.
Los watchservers son un tipo de servidor especializado que responde a las solicitudes Watch. Siguen el final (tail) del registro de cambios y sirven a los clientes un flujo de cambios de los espacios de nombres casi en tiempo real.
Zanzibar periodically runs a data processing pipeline to perform a variety of offline functions across all Zanzibar data in Spanner. One such function is to produce dumps of the relation tuples in each namespace at a known snapshot timestamp. Another is to garbage-collect tuple versions older than a threshold configured per namespace.
Zanzibar ejecuta periódicamente una canalización de procesamiento de datos para llevar a cabo diversas funciones fuera de línea sobre todos los datos de Zanzibar en Spanner. Una de esas funciones es producir volcados de las tuplas de relación de cada espacio de nombres en una marca de tiempo de instantánea conocida. Otra es eliminar mediante recolección de basura las versiones de tuplas más antiguas que un umbral configurado por espacio de nombres.
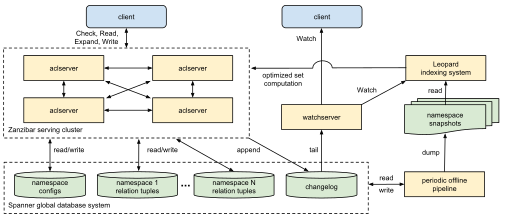
Figure 2: Zanzibar architecture. Arrows indicate the direction of data flow.
Figura 2: Arquitectura de Zanzibar. Las flechas indican la dirección del flujo de datos.
Leopard is an indexing system used to optimize operations on large and deeply nested sets. It reads periodic snapshots of ACL data and watches for changes between snapshots. It performs transformations on that data, such as denormalization, and responds to requests from aclservers.
Leopard es un sistema de indexación utilizado para optimizar operaciones sobre conjuntos grandes y profundamente anidados. Lee instantáneas periódicas de los datos de las ACL y observa los cambios entre instantáneas. Realiza transformaciones sobre esos datos, como la desnormalización, y responde a solicitudes de los aclservers.
The rest of this section presents the implementation of these architectural elements in more detail.
El resto de esta sección presenta con más detalle la implementación de estos elementos arquitectónicos.
We store relation tuples of each namespace in a separate database, where each row is identified by primary key (shard ID, object ID, relation, user, commit timestamp). Multiple tuple versions are stored on different rows, so that we can evaluate checks and reads at any timestamp within the garbage collection window. The ordering of primary keys allows us to look up all relation tuples for a given object ID or (object ID, relation) pair.
Almacenamos las tuplas de relación de cada espacio de nombres en una base de datos separada, donde cada fila se identifica mediante la clave primaria (ID de fragmento, ID de objeto, relación, usuario, marca de tiempo de confirmación). Las múltiples versiones de una tupla se almacenan en filas distintas, de modo que podemos evaluar comprobaciones y lecturas en cualquier marca de tiempo dentro de la ventana de recolección de basura. El orden de las claves primarias nos permite buscar todas las tuplas de relación de un ID de objeto o de un par (ID de objeto, relación) dado.
Our clients configure sharding of a namespace according to its data pattern. Usually the shard ID is determined solely by the object ID. In some cases, for example, when a namespace stores groups with very large numbers of members, the shard ID is computed from both object ID and user.
Nuestros clientes configuran la fragmentación de un espacio de nombres según el patrón de sus datos. Normalmente, el ID de fragmento se determina únicamente a partir del ID de objeto. En algunos casos, por ejemplo, cuando un espacio de nombres almacena grupos con un número muy grande de miembros, el ID de fragmento se calcula a partir tanto del ID de objeto como del usuario.
Zanzibar also maintains a changelog database that stores a history of tuple updates for the Watch API. The primary keys are (changelog shard ID, timestamp, unique update ID), where a changelog shard is randomly selected for each write.
Zanzibar mantiene además una base de datos de registro de cambios que almacena un historial de las actualizaciones de tuplas para la API Watch. Las claves primarias son (ID de fragmento del registro de cambios, marca de tiempo, ID único de actualización), donde para cada escritura se selecciona aleatoriamente un fragmento del registro de cambios.
Every Zanzibar write is committed to both the tuple storage and the changelog shard in a single transaction. We designate the Spanner server hosting the changelog shard as the transaction coordinator to minimize blocking of changelog reads on pending transactions.
Cada escritura de Zanzibar se confirma tanto en el almacenamiento de tuplas como en el fragmento del registro de cambios en una única transacción. Designamos el servidor de Spanner que aloja el fragmento del registro de cambios como coordinador de la transacción para minimizar el bloqueo de las lecturas del registro de cambios por transacciones pendientes.
Namespace configs are stored in a database with two tables. One table contains the configs and is keyed by namespace IDs. The other is a changelog of config updates and is keyed by commit timestamps. This structure allows a Zanzibar server to load all configs upon startup and monitor the changelog to refresh configs continuously.
Las configuraciones de los espacios de nombres se almacenan en una base de datos con dos tablas. Una tabla contiene las configuraciones y tiene como clave los ID de los espacios de nombres. La otra es un registro de cambios de las actualizaciones de configuración y tiene como clave las marcas de tiempo de confirmación. Esta estructura permite a un servidor de Zanzibar cargar todas las configuraciones al arrancar y vigilar el registro de cambios para actualizar las configuraciones de forma continua.
To reduce latency, Zanzibar data is replicated to be close to our clients. Replicas exist in dozens of locations around the world, with multiple replicas per region. The 5 voting replicas are in eastern and central United States, in 3 different metropolitan areas to isolate failures but within 25 milliseconds of each other so that Paxos transactions commit quickly.
Para reducir la latencia, los datos de Zanzibar se replican para estar cerca de nuestros clientes. Hay réplicas en decenas de ubicaciones de todo el mundo, con múltiples réplicas por región. Las 5 réplicas con derecho a voto se encuentran en el este y el centro de Estados Unidos, en 3 áreas metropolitanas distintas para aislar los fallos, pero a menos de 25 milisegundos unas de otras para que las transacciones de Paxos se confirmen con rapidez.
As noted in §2.4, clients can provide zookies to ensure a minimum snapshot timestamp for request evaluation. When a zookie is not provided, the server uses a default staleness chosen to ensure that all transactions are evaluated at a timestamp that is as recent as possible without impacting latency.
Como se indicó en §2.4, los clientes pueden proporcionar zookies para garantizar una marca de tiempo de instantánea mínima para la evaluación de las solicitudes. Cuando no se proporciona un zookie, el servidor utiliza una desactualización predeterminada elegida para garantizar que todas las transacciones se evalúen en una marca de tiempo lo más reciente posible sin afectar a la latencia.
On each read request it makes to Spanner, Zanzibar receives a hint about whether or not the data at that timestamp required an out-of-zone read and thus incurred additional latency. Each server tracks the frequency of such out-of-zone reads for data at a default staleness as well as for fresher and staler data, and uses these frequencies to compute a binomial proportion confidence interval of the probability that any given piece of data is available locally at each staleness.
En cada solicitud de lectura que hace a Spanner, Zanzibar recibe una indicación de si los datos en esa marca de tiempo requirieron o no una lectura fuera de la zona y, por tanto, incurrieron en latencia adicional. Cada servidor registra la frecuencia de tales lecturas fuera de la zona para los datos con la desactualización predeterminada, así como para datos más recientes y más desactualizados, y utiliza estas frecuencias para calcular un intervalo de confianza de proporción binomial de la probabilidad de que cualquier dato dado esté disponible localmente para cada nivel de desactualización.
Upon collecting enough data, the server checks to see if each staleness value has a sufficiently low probability of incurring an out-of-zone read, and thus will be low-latency. If so, it updates the default staleness bound to the lowest “safe” value. If no known staleness values are safe, we use a two-proportion z-test to see if increasing the default will be a statistically significant amount safer. In that case, we increase the default value in the hopes of improving latency. This default staleness mechanism is purely a performance optimization. It does not violate consistency semantics because Zanzibar always respects zookies when provided.
Tras recopilar suficientes datos, el servidor comprueba si cada valor de desactualización tiene una probabilidad suficientemente baja de incurrir en una lectura fuera de la zona y, por tanto, tendrá baja latencia. En tal caso, actualiza la cota de desactualización predeterminada al valor “seguro” más bajo. Si ninguno de los valores de desactualización conocidos es seguro, utilizamos una prueba z de dos proporciones para ver si aumentar el valor predeterminado lo hará más seguro en una cantidad estadísticamente significativa. En ese caso, aumentamos el valor predeterminado con la esperanza de mejorar la latencia. Este mecanismo de desactualización predeterminada es puramente una optimización del rendimiento. No viola la semántica de consistencia, porque Zanzibar siempre respeta los zookies cuando se proporcionan.
Because changes to namespace configs can change the results of ACL evaluations, and therefore their correctness, Zanzibar chooses a single snapshot timestamp for config metadata when evaluating each client request. All aclservers in a cluster use that same timestamp for the same request, including for any subrequests that fan out from the original client request.
Dado que los cambios en las configuraciones de los espacios de nombres pueden cambiar los resultados de las evaluaciones de ACL y, por tanto, su corrección, Zanzibar elige una única marca de tiempo de instantánea para los metadatos de configuración al evaluar cada solicitud de cliente. Todos los aclservers de un clúster utilizan esa misma marca de tiempo para la misma solicitud, incluidas todas las subsolicitudes que se derivan de la solicitud original del cliente.
Each server independently loads namespace configs from storage continuously as they change (§3.1.3). Therefore, each server in a cluster may have access to a different range of config timestamps due to restarts or network latency. Zanzibar must pick a timestamp that is available across all of them. To facilitate this, a monitoring job tracks the timestamp range available to every server and aggregates them, reporting a globally available range to every other server. On each incoming request the server picks a time from this range, ensuring that all servers can continue serving even if they are no longer able to read from the config storage.
Cada servidor carga de forma independiente y continua las configuraciones de los espacios de nombres desde el almacenamiento a medida que cambian (§3.1.3). Por ello, cada servidor de un clúster puede tener acceso a un rango distinto de marcas de tiempo de configuración debido a reinicios o a la latencia de la red. Zanzibar debe elegir una marca de tiempo que esté disponible en todos ellos. Para facilitarlo, una tarea de monitorización registra el rango de marcas de tiempo disponible para cada servidor y los agrega, comunicando un rango disponible globalmente a todos los demás servidores. En cada solicitud entrante, el servidor elige un momento dentro de este rango, lo que garantiza que todos los servidores puedan seguir sirviendo incluso si ya no son capaces de leer del almacenamiento de configuraciones.
Zanzibar evaluates ACL checks by converting check requests to boolean expressions. In a simple case, when there are no userset rewrite rules, checking a user against a userset ⟨object#relation⟩ can be expressed as
Zanzibar evalúa las comprobaciones de ACL convirtiendo las solicitudes de comprobación en expresiones booleanas. En un caso sencillo, cuando no hay reglas de reescritura de usersets, la comprobación de un usuario contra un userset ⟨object#relation⟩ puede expresarse como
Finding a valid involves evaluating membership on all indirect ACLs or groups, recursively. This kind of “pointer chasing” works well for most types of ACLs and groups, but can be expensive when indirect ACLs or groups are deep or wide. §3.2.4 explains how we handle this problem. Userset rewrite rules are also translated to boolean expressions as part of check evaluation.
Encontrar un válido implica evaluar la pertenencia en todas las ACL o grupos indirectos, de forma recursiva. Este tipo de “persecución de punteros” funciona bien para la mayoría de los tipos de ACL y grupos, pero puede resultar costoso cuando las ACL o grupos indirectos son profundos o anchos. En §3.2.4 se explica cómo abordamos este problema. Las reglas de reescritura de usersets también se traducen a expresiones booleanas como parte de la evaluación de las comprobaciones.
To minimize check latency, we evaluate all leaf nodes of the boolean expression tree concurrently. When the outcome of one node determines the result of a subtree, evaluation of other nodes in the subtree is cancelled.
Para minimizar la latencia de las comprobaciones, evaluamos concurrentemente todos los nodos hoja del árbol de expresiones booleanas. Cuando el resultado de un nodo determina el resultado de un subárbol, se cancela la evaluación de los demás nodos del subárbol.
Evaluation of leaf nodes usually involves reading relation tuples from databases. We apply a pooling mechanism to group reads for the same ACL check to minimize the number of read RPCs to Spanner.
La evaluación de los nodos hoja suele implicar la lectura de tuplas de relación de las bases de datos. Aplicamos un mecanismo de agrupación para reunir las lecturas de una misma comprobación de ACL y minimizar así el número de RPC de lectura a Spanner.
Recursive pointer chasing during check evaluation has difficulty maintaining low latency with groups that are deeply nested or have a large number of child groups. For selected namespaces that exhibit such structure, Zanzibar handles checks using Leopard, a specialized index that supports efficient set computation.
La persecución recursiva de punteros durante la evaluación de las comprobaciones tiene dificultades para mantener una latencia baja con grupos profundamente anidados o con un gran número de grupos hijos. Para determinados espacios de nombres que presentan esa estructura, Zanzibar gestiona las comprobaciones mediante Leopard, un índice especializado que admite un cálculo eficiente de conjuntos.
A Leopard index represents a collection of named sets using tuples, where is an enum representing the set type and and are 64-bit integers representing the set ID and the element ID, respectively. A query evaluates an expression of union, intersection, or exclusion of named sets and returns the result set ordered by the element ID up to a specified number of results.
Un índice Leopard representa una colección de conjuntos con nombre mediante tuplas , donde es un enumerado que representa el tipo de conjunto, y y son enteros de 64 bits que representan el ID del conjunto y el ID del elemento, respectivamente. Una consulta evalúa una expresión de unión, intersección o exclusión de conjuntos con nombre y devuelve el conjunto resultado ordenado por el ID del elemento, hasta un número especificado de resultados.
To index and evaluate group membership, Zanzibar represents group membership with two set types, and , which we show here as functions mapping from a set ID to element IDs:
Para indexar y evaluar la pertenencia a grupos, Zanzibar representa la pertenencia a grupos con dos tipos de conjunto, y , que mostramos aquí como funciones que asignan un ID de conjunto a ID de elementos:
- , where represents an ancestor group and represents a descendent group that is directly or indirectly a sub-group of the ancestor group.
- , where represents an individual user and represents a parent group in which the user is a direct member.
- , donde representa un grupo ancestro y representa un grupo descendiente que es, directa o indirectamente, un subgrupo del grupo ancestro.
- , donde representa un usuario individual y representa un grupo padre del que el usuario es miembro directo.
To evaluate whether user is a member of group , we check whether
Para evaluar si el usuario es miembro del grupo , comprobamos si
Group membership can be considered as a reachability problem in a graph, where nodes represent groups and users and edges represent direct membership. Flattening group-to-group paths allows reachability to be efficently evaluated by Leopard, though other types of denormalization can also be applied as data patterns demand.
La pertenencia a grupos puede considerarse un problema de alcanzabilidad en un grafo, donde los nodos representan grupos y usuarios y las aristas representan la pertenencia directa. Aplanar los caminos de grupo a grupo permite que Leopard evalúe la alcanzabilidad de forma eficiente, aunque también pueden aplicarse otros tipos de desnormalización según lo exijan los patrones de los datos.
The Leopard system consists of three discrete parts: a serving system capable of consistent and low-latency operations across sets; an offline, periodic index building system; and an online real-time layer capable of continuously updating the serving system as tuple changes occur.
El sistema Leopard consta de tres partes diferenciadas: un sistema de servicio capaz de realizar operaciones consistentes y de baja latencia sobre conjuntos; un sistema periódico de construcción de índices fuera de línea; y una capa en línea en tiempo real capaz de actualizar continuamente el sistema de servicio a medida que se producen cambios en las tuplas.
Index tuples are stored as ordered lists of integers in a structure such as a skip list, thus allowing for efficient union and intersections among sets. For example, evaluating the intersection between two sets, and , requires only skip-list seeks. The index is sharded by element IDs and can be distributed across multiple servers. Shards are usually served entirely from memory, but they can also be served from a mix of hot and cold data spread between memory and remote solid-state devices.
Las tuplas del índice se almacenan como listas ordenadas de enteros en una estructura como una skip list, lo que permite uniones e intersecciones eficientes entre conjuntos. Por ejemplo, evaluar la intersección entre dos conjuntos, y , solo requiere búsquedas en la skip list. El índice se fragmenta por ID de elemento y puede distribuirse entre múltiples servidores. Los fragmentos suelen servirse íntegramente desde memoria, pero también pueden servirse a partir de una mezcla de datos calientes y fríos repartidos entre la memoria y dispositivos remotos de estado sólido.
The offline index builder generates index shards from a snapshot of Zanzibar relation tuples and configs, and replicates the shards globally. It respects userset rewrite rules and recursively expands edges in an ACL graph to form Leopard index tuples. The Leopard servers continously watch for new shards and swap old shards with new ones when they become available.
El constructor de índices fuera de línea genera fragmentos del índice a partir de una instantánea de las tuplas de relación y las configuraciones de Zanzibar, y replica los fragmentos globalmente. Respeta las reglas de reescritura de usersets y expande recursivamente las aristas de un grafo de ACL para formar las tuplas del índice Leopard. Los servidores de Leopard vigilan continuamente la aparición de nuevos fragmentos y sustituyen los fragmentos antiguos por los nuevos cuando estos están disponibles.
The Leopard system described thus far is able to efficiently evaluate deeply and widely nested group membership, but cannot do so at a fresh and consistent snapshot due to offline index generation and shard swapping. To support consistent ACL evaluation, Leopard servers maintain an incremental layer that indexes all updates since the offline snapshot, where each update is represented by a tuple, where is the timestamp of the update and is a deletion marker. Updates with timestamps less than or equal to the query timestamp are merged on top of the offline index during query processing.
El sistema Leopard descrito hasta ahora es capaz de evaluar de forma eficiente la pertenencia a grupos anidados en profundidad y en anchura, pero no puede hacerlo en una instantánea reciente y consistente debido a la generación fuera de línea del índice y a la sustitución de fragmentos. Para admitir una evaluación consistente de las ACL, los servidores de Leopard mantienen una capa incremental que indexa todas las actualizaciones desde la instantánea fuera de línea, donde cada actualización se representa mediante una tupla , en la que es la marca de tiempo de la actualización y es un marcador de eliminación. Las actualizaciones con marcas de tiempo menores o iguales que la marca de tiempo de la consulta se fusionan sobre el índice fuera de línea durante el procesamiento de la consulta.
To maintain the incremental layer, the Leopard incremental indexer calls Zanzibar’s Watch API to receive a temporally ordered stream of Zanzibar tuple modifications and transforms the updates into a temporally ordered stream of Leopard tuple additions, updates, and deletions. Generating updates for the tuples requires the incremental indexer to maintain group-to-group membership for denormalizing the effects of a relation tuple update to potentially multiple index updates.
Para mantener la capa incremental, el indexador incremental de Leopard llama a la API Watch de Zanzibar para recibir un flujo ordenado temporalmente de modificaciones de tuplas de Zanzibar y transforma las actualizaciones en un flujo ordenado temporalmente de adiciones, actualizaciones y eliminaciones de tuplas de Leopard. Generar actualizaciones para las tuplas requiere que el indexador incremental mantenga la pertenencia de grupo a grupo para desnormalizar los efectos de una actualización de una tupla de relación en potencialmente múltiples actualizaciones del índice.
In practice, a single Zanzibar tuple addition or deletion may yield potentially tens of thousands of discrete Leopard tuple events. Each Leopard serving instance receives the complete stream of these Zanzibar tuple changes through the Watch API. The Leopard serving system is designed to continuously ingest this stream and update its various posting lists with minimal impact to query serving.
En la práctica, una sola adición o eliminación de una tupla de Zanzibar puede dar lugar potencialmente a decenas de miles de eventos discretos de tuplas de Leopard. Cada instancia de servicio de Leopard recibe el flujo completo de estos cambios de tuplas de Zanzibar a través de la API Watch. El sistema de servicio de Leopard está diseñado para ingerir continuamente este flujo y actualizar sus diversas listas de publicación (posting lists) con un impacto mínimo en el servicio de las consultas.
The workload of ACL reads and checks is often bursty and subject to hot spots. For example, answering a search query requires conducting ACL checks for all candidate results, whose ACLs often share common groups or indirect ACLs. To facilitate consistency, Zanzibar avoids storage denormalization and relies only on normalized data (except for the cases described in §3.2.4). With normalized data, hot spots on common ACLs (e.g., popular groups) may overload the underlying database servers. We found the handling of hot spots to be the most critical frontier in our pursuit of low latency and high availability.
La carga de trabajo de lecturas y comprobaciones de ACL suele producirse en ráfagas y está sujeta a puntos calientes. Por ejemplo, responder a una consulta de búsqueda requiere realizar comprobaciones de ACL para todos los resultados candidatos, cuyas ACL comparten a menudo grupos comunes o ACL indirectas. Para facilitar la consistencia, Zanzibar evita la desnormalización del almacenamiento y se basa únicamente en datos normalizados (salvo en los casos descritos en §3.2.4). Con datos normalizados, los puntos calientes sobre ACL comunes (p. ej., grupos populares) pueden sobrecargar los servidores de bases de datos subyacentes. Descubrimos que la gestión de los puntos calientes era la frontera más crítica en nuestra búsqueda de baja latencia y alta disponibilidad.
Zanzibar servers in each cluster form a distributed cache for both reads and check evaluations, including intermediate check results evaluated during pointer chasing. Cache entries are distributed across Zanzibar servers with consistent hashing [20]. To process checks or reads, we fan out requests to the corresponding Zanzibar servers via an internal RPC interface. To minimize the number of internal RPCs, for most namespaces we compute the forwarding key from the object ID, since processing a check on ⟨object#relation⟩ often involves indirect ACL checks on other relations of the same object and reading relation tuples of the object. These checks and reads can be processed by the same server since they share the same forwarding key with the parent check request. To handle hot forwarding keys, we cache results at both the caller and the callee of internal RPCs, effectively forming cache trees. We also use Slicer [12] to help distribute hot keys to multiple servers.
Los servidores de Zanzibar de cada clúster forman una caché distribuida tanto para las lecturas como para las evaluaciones de comprobaciones, incluidos los resultados intermedios de las comprobaciones evaluados durante la persecución de punteros. Las entradas de la caché se distribuyen entre los servidores de Zanzibar mediante hashing consistente [20]. Para procesar comprobaciones o lecturas, repartimos las solicitudes entre los servidores de Zanzibar correspondientes mediante una interfaz RPC interna. Para minimizar el número de RPC internas, en la mayoría de los espacios de nombres calculamos la clave de reenvío a partir del ID de objeto, ya que procesar una comprobación sobre ⟨object#relation⟩ implica a menudo comprobaciones de ACL indirectas sobre otras relaciones del mismo objeto y la lectura de tuplas de relación del objeto. Estas comprobaciones y lecturas pueden procesarse en el mismo servidor, ya que comparten la misma clave de reenvío con la solicitud de comprobación padre. Para gestionar las claves de reenvío calientes, almacenamos en caché los resultados tanto en el llamador como en el llamado de las RPC internas, con lo que se forman en la práctica árboles de caché. También utilizamos Slicer [12] para ayudar a distribuir las claves calientes entre múltiples servidores.
We avoid reusing results evaluated from a different snapshot by encoding snapshot timestamps in cache keys. We choose evaluation timestamps rounded up to a coarse granularity, such as one or ten seconds, while respecting staleness constraints from request zookies. This timestamp quantization allows the vast majority of recent checks and reads to be evaluated at the same timestamps and to share cache results, despite having microsecond-resolution timestamps in cache keys. It is worth noting that rounding up timestamps does not affect Zanzibar’s consistency properties, since Spanner ensures that a snapshot read at timestamp will observe all writes up to —this holds even if is in the future, in which case the read will wait until TrueTime has moved past .
Evitamos reutilizar resultados evaluados en una instantánea distinta codificando las marcas de tiempo de las instantáneas en las claves de la caché. Elegimos marcas de tiempo de evaluación redondeadas al alza a una granularidad gruesa, como uno o diez segundos, respetando a la vez las restricciones de desactualización de los zookies de las solicitudes. Esta cuantización de las marcas de tiempo permite que la gran mayoría de las comprobaciones y lecturas recientes se evalúen en las mismas marcas de tiempo y compartan los resultados de la caché, a pesar de que las claves de la caché contienen marcas de tiempo con resolución de microsegundos. Cabe señalar que redondear al alza las marcas de tiempo no afecta a las propiedades de consistencia de Zanzibar, ya que Spanner garantiza que una lectura de instantánea en la marca de tiempo observará todas las escrituras hasta ; esto se cumple incluso si está en el futuro, en cuyo caso la lectura esperará hasta que TrueTime haya superado .
To handle the “cache stampede” problem [3], where concurrent requests create flash hot spots before the cache is populated with results, we maintain a lock table on each server to track outstanding reads and checks. Among requests sharing the same cache key only one request will begin processing; the rest block until the cache is populated.
Para gestionar el problema de la “estampida de caché” [3], en el que las solicitudes concurrentes crean puntos calientes repentinos antes de que la caché se rellene con los resultados, mantenemos una tabla de bloqueos en cada servidor para registrar las lecturas y comprobaciones pendientes. Entre las solicitudes que comparten la misma clave de caché, solo una comenzará a procesarse; el resto se bloquean hasta que la caché se rellena.
We can effectively handle the vast majority of hot spots with distributed caches and lock tables. Over time we made the following two improvements.
Podemos gestionar eficazmente la gran mayoría de los puntos calientes con cachés distribuidas y tablas de bloqueos. Con el tiempo, introdujimos las dos mejoras siguientes.
First, direct membership checks of a user for an object and relation (i.e. ⟨object#relation@user⟩) are usually handled by a single relation tuple lookup. However, occasionally a very popular object invites many concurrent checks for different users, causing a hot spot on the storage server hosting relation tuples for the object. To avoid these hot spots, we read and cache all relation tuples of ⟨object#relation⟩ for the hot object, trading read bandwidth for cacheability. We dynamically detect hot objects to apply this method to by tracking the number of outstanding reads on each object.
En primer lugar, las comprobaciones de pertenencia directa de un usuario para un objeto y una relación (es decir, ⟨object#relation@user⟩) suelen resolverse mediante una única búsqueda de una tupla de relación. Sin embargo, ocasionalmente un objeto muy popular atrae muchas comprobaciones concurrentes para distintos usuarios, lo que provoca un punto caliente en el servidor de almacenamiento que aloja las tuplas de relación del objeto. Para evitar estos puntos calientes, leemos y almacenamos en caché todas las tuplas de relación de ⟨object#relation⟩ del objeto caliente, sacrificando ancho de banda de lectura a cambio de capacidad de almacenamiento en caché. Detectamos dinámicamente los objetos calientes a los que aplicar este método registrando el número de lecturas pendientes sobre cada objeto.
Second, indirect ACL checks are frequently cancelled when the result of the parent ACL check is already determined. This leaves the cache key unpopulated. While eager cancellation reduces resource usage significantly, it negatively affects latency of concurrent requests that are blocked by the lock table entry. To prevent this latency impact, we delay eager cancellation when there are waiters on the corresponding lock table entry.
En segundo lugar, las comprobaciones de ACL indirectas se cancelan con frecuencia cuando el resultado de la comprobación de ACL padre ya está determinado. Esto deja sin rellenar la clave de caché. Aunque la cancelación anticipada reduce significativamente el uso de recursos, afecta negativamente a la latencia de las solicitudes concurrentes que están bloqueadas por la entrada de la tabla de bloqueos. Para evitar este impacto en la latencia, retrasamos la cancelación anticipada cuando hay solicitudes en espera sobre la entrada correspondiente de la tabla de bloqueos.
Performance isolation is indispensable for shared services targeting low latency and high availability. If Zanzibar or one of its clients occasionally fails to provision enough resources to handle an unexpected usage pattern, the following isolation mechanisms ensure that performance problems are isolated to the problematic use case and do not adversely affect other clients.
El aislamiento de rendimiento es indispensable para los servicios compartidos que aspiran a una baja latencia y una alta disponibilidad. Si Zanzibar o alguno de sus clientes no logra ocasionalmente aprovisionar recursos suficientes para gestionar un patrón de uso inesperado, los siguientes mecanismos de aislamiento garantizan que los problemas de rendimiento queden aislados en el caso de uso problemático y no afecten negativamente a otros clientes.
First, to ensure proper allocation of CPU capacity, Zanzibar measures the cost of each RPC in terms of generic cpu-seconds, a hardware-agnostic metric. Each client has a global limit on maximum CPU usage per second; its RPCs will be throttled if it exceeds the limit and there is no spare capacity in the overall system.
En primer lugar, para garantizar una asignación adecuada de la capacidad de CPU, Zanzibar mide el coste de cada RPC en términos de cpu-segundos genéricos, una métrica independiente del hardware. Cada cliente tiene un límite global de uso máximo de CPU por segundo; sus RPC se limitarán si supera el límite y no hay capacidad sobrante en el sistema en su conjunto.
Each Zanzibar server also limits the total number of outstanding RPCs to control its memory usage. Likewise it limits the number of oustanding RPCs per client.
Cada servidor de Zanzibar también limita el número total de RPC pendientes para controlar su uso de memoria. Del mismo modo, limita el número de RPC pendientes por cliente.
Zanzibar further limits the maximum number of concurrent reads per (object, client) and per client on each Spanner server. This ensures that no single object or client can monopolize a Spanner server.
Zanzibar limita además el número máximo de lecturas concurrentes por (objeto, cliente) y por cliente en cada servidor de Spanner. Esto garantiza que ningún objeto o cliente individual pueda monopolizar un servidor de Spanner.
Finally, we use different lock table keys for requests from different clients to prevent any throttling that Spanner applies to one client from affecting other clients.
Por último, utilizamos claves distintas de la tabla de bloqueos para las solicitudes de clientes distintos, con el fin de evitar que cualquier limitación que Spanner aplique a un cliente afecte a otros clientes.
Zanzibar’s distributed processing requires measures to accommodate slow tasks. For calls to Spanner and to the Leopard index we rely on request hedging [16] (i.e. we send the same request to multiple servers, use whichever response comes back first, and cancel the other requests). To reduce round-trip times, we try to place at least two replicas of these backend services in every geographical region where we have Zanzibar servers. To avoid unnecessarily multiplying load, we first send one request and defer sending hedged requests until the initial request is known to be slow.
El procesamiento distribuido de Zanzibar requiere medidas para hacer frente a las tareas lentas. Para las llamadas a Spanner y al índice Leopard recurrimos a las solicitudes de cobertura (hedging) [16] (es decir, enviamos la misma solicitud a varios servidores, utilizamos la respuesta que llegue primero y cancelamos las demás solicitudes). Para reducir los tiempos de ida y vuelta, intentamos colocar al menos dos réplicas de estos servicios de backend en cada región geográfica donde tenemos servidores de Zanzibar. Para evitar multiplicar innecesariamente la carga, primero enviamos una solicitud y aplazamos el envío de las solicitudes de cobertura hasta que se sabe que la solicitud inicial es lenta.
To determine the appropriate hedging delay threshold, each server maintains a delay estimator that dynamically computes an Nth percentile latency based on recent measurements. This mechanism allows us to limit the additional traffic incurred by hedging to a small fraction of total traffic.
Para determinar el umbral de retardo adecuado para las solicitudes de cobertura, cada servidor mantiene un estimador de retardo que calcula dinámicamente la latencia en el percentil N-ésimo a partir de mediciones recientes. Este mecanismo nos permite limitar el tráfico adicional generado por las solicitudes de cobertura a una pequeña fracción del tráfico total.
Effective hedging requires the requests to have similar costs. In the case of Zanzibar’s authorization checks, some checks are inherently more time-consuming than others because they require more work. Hedging check requests would result in duplicating the most expensive workloads and, ironically, worsening latency. Therefore we do not hedge requests between Zanzibar servers, but rely on the previously discussed sharding among multiple replicas and on monitoring mechanisms to detect and avoid slow servers.
Para que las solicitudes de cobertura sean eficaces, las solicitudes deben tener costes similares. En el caso de las comprobaciones de autorización de Zanzibar, algunas comprobaciones consumen inherentemente más tiempo que otras porque requieren más trabajo. Aplicar solicitudes de cobertura a las solicitudes de comprobación daría lugar a duplicar las cargas de trabajo más costosas y, paradójicamente, a empeorar la latencia. Por ello, no aplicamos solicitudes de cobertura entre servidores de Zanzibar, sino que recurrimos a la fragmentación entre múltiples réplicas, comentada anteriormente, y a mecanismos de monitorización para detectar y evitar los servidores lentos.
Zanzibar has been in production use for more than 5 years. Throughout that time, the number of clients using Zanzibar and the load they place on Zanzibar have grown steadily. This section discusses our experience operating Zanzibar as a globally distributed authorization system.
Zanzibar lleva más de 5 años en uso en producción. Durante todo ese tiempo, el número de clientes que utilizan Zanzibar y la carga que imponen sobre Zanzibar han crecido de forma constante. Esta sección expone nuestra experiencia operando Zanzibar como sistema de autorización distribuido globalmente.
Zanzibar manages more than 1,500 namespaces defined by hundreds of client applications. The size of a namespace configuration file serves as a rough measure of the complexity of the access control policy implemented by that namespace. These configuration files range from tens of lines to thousands of lines, with the median near 500 lines.
Zanzibar gestiona más de 1,500 espacios de nombres definidos por cientos de aplicaciones cliente. El tamaño del archivo de configuración de un espacio de nombres sirve como medida aproximada de la complejidad de la política de control de acceso implementada por ese espacio de nombres. Estos archivos de configuración van desde decenas de líneas hasta miles de líneas, con una mediana cercana a 500 líneas.
These namespaces contain more than 2 trillion relation tuples that occupy close to 100 terabytes. The number of tuples per namespace ranges over many orders of magnitude, from tens to a trillion, with the median near 15,000. This data is fully replicated in more than 30 locations around the world to maintain both proximity to users and high availability.
Estos espacios de nombres contienen más de 2 billones de tuplas de relación que ocupan cerca de 100 terabytes. El número de tuplas por espacio de nombres abarca muchos órdenes de magnitud, desde decenas hasta un billón, con una mediana cercana a 15,000. Estos datos se replican íntegramente en más de 30 ubicaciones de todo el mundo para mantener tanto la proximidad a los usuarios como una alta disponibilidad.
Zanzibar serves more than 10 million client queries per second (QPS). Over a sample 7-day period in December 2018, Check requests peak at roughly 4.2M QPS, Read at 8.2M, Expand at 760K, and Write at 25K. Queries that read data are thus two orders of magnitude more frequent than those that write data.
Zanzibar atiende más de 10 millones de consultas de clientes por segundo (QPS). A lo largo de un periodo de muestra de 7 días en diciembre de 2018, las solicitudes Check alcanzan un pico de aproximadamente 4.2M QPS, Read de 8.2M, Expand de 760K y Write de 25K. Las consultas que leen datos son, por tanto, dos órdenes de magnitud más frecuentes que las que escriben datos.
Zanzibar distributes this load across more than 10,000 servers organized in several dozen clusters around the world. The number of servers per cluster ranges from fewer than 100 to more than 1,000, with the median near 500. Clusters are sized in proportion to load in their geographic regions.
Zanzibar distribuye esta carga entre más de 10,000 servidores organizados en varias decenas de clústeres de todo el mundo. El número de servidores por clúster va desde menos de 100 hasta más de 1,000, con una mediana cercana a 500. Los clústeres se dimensionan en proporción a la carga de sus regiones geográficas.
We divide requests into two categories according to the required data freshness, which can have a large impact on latency and availability of the requests. Specifically, Check, Read, and Expand requests carry zookies to specify lower bounds on evaluation timestamps. When a zookie timestamp is higher than that of the most recent data replicated to the region, the storage reads require cross-region round trips to the leader replica to retrieve fresher data. As our storage is configured with replication heartbeats with 8-second intervals, we divide our requests into two categories: Safe requests have zookies more than 10 seconds old and can be served within the region most of time, while Recent requests have zookies less than 10 seconds old and often require inter-region round trips. We report separate statistics for each.
Dividimos las solicitudes en dos categorías según la frescura de datos requerida, que puede tener un gran impacto en la latencia y la disponibilidad de las solicitudes. En concreto, las solicitudes Check, Read y Expand llevan zookies para especificar cotas inferiores de las marcas de tiempo de evaluación. Cuando la marca de tiempo de un zookie es posterior a la de los datos más recientes replicados en la región, las lecturas del almacenamiento requieren viajes de ida y vuelta entre regiones hasta la réplica líder para obtener datos más recientes. Como nuestro almacenamiento está configurado con latidos de replicación a intervalos de 8 segundos, dividimos nuestras solicitudes en dos categorías: las solicitudes Safe tienen zookies con más de 10 segundos de antigüedad y la mayor parte del tiempo pueden servirse dentro de la región, mientras que las solicitudes Recent tienen zookies con menos de 10 segundos de antigüedad y a menudo requieren viajes de ida y vuelta entre regiones. Presentamos estadísticas separadas para cada una.
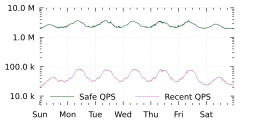
Figure 3: Rate of Check Safe and Check Recent requests over a 7-day period in December 2018.
Figura 3: Tasa de solicitudes Check Safe y Check Recent a lo largo de un periodo de 7 días en diciembre de 2018.
Figure 3 shows the rate of Check Safe and Check Recent requests over 7 days. Both exhibit a diurnal cycle. The rate of Safe requests is about two orders of magnitude larger than that of Recent requests, which allows Zanzibar to serve the vast majority of ACL checks locally.
La Figura 3 muestra la tasa de solicitudes Check Safe y Check Recent a lo largo de 7 días. Ambas presentan un ciclo diario. La tasa de solicitudes Safe es unos dos órdenes de magnitud mayor que la de las solicitudes Recent, lo que permite a Zanzibar servir localmente la gran mayoría de las comprobaciones de ACL.
Zanzibar’s latency budget is generally a small fraction of the few hundreds of milliseconds of total response time that its clients must provide to be viable interactive services. Consider for example a client that performs authorization checks on multiple documents before it can show the results of a search on those documents.
El presupuesto de latencia de Zanzibar suele ser una pequeña fracción de los pocos cientos de milisegundos de tiempo de respuesta total que sus clientes deben ofrecer para ser servicios interactivos viables. Considérese, por ejemplo, un cliente que realiza comprobaciones de autorización sobre múltiples documentos antes de poder mostrar los resultados de una búsqueda sobre esos documentos.
We measure latency on the server side using live traffic because (1) latency is heavily influenced by our caching and de-duplication mechanisms so that it is only realistically reflected by live traffic, and (2) accurately measuring latency from clients requires well-behaving clients. Provisioning of client jobs is outside of Zanzibar’s control and sometimes client jobs are overloaded.
Medimos la latencia en el lado del servidor utilizando tráfico real porque (1) la latencia está fuertemente influida por nuestros mecanismos de caché y de deduplicación, de modo que solo el tráfico real la refleja de manera realista, y (2) medir con precisión la latencia desde los clientes requiere clientes que se comporten correctamente. El aprovisionamiento de las tareas de los clientes queda fuera del control de Zanzibar y, en ocasiones, las tareas de los clientes están sobrecargadas.
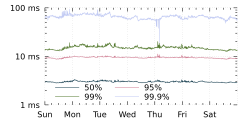
Figure 4: Latency of Check Safe responses at different percentiles over a 7-day period in December 2018.
Figura 4: Latencia de las respuestas Check Safe en distintos percentiles a lo largo de un periodo de 7 días en diciembre de 2018.
Figure 4 shows the latency of Check Safe responses over 7 days. At the 50th, 95th, 99th, and 99.9th percentiles it peaks at roughly 3, 11, 20, and 93 msec, respectively. This performance meets our latency goals for an operation that is frequently in the critical path of user interactions.
La Figura 4 muestra la latencia de las respuestas Check Safe a lo largo de 7 días. En los percentiles 50, 95, 99 y 99.9 alcanza picos de aproximadamente 3, 11, 20 y 93 ms, respectivamente. Este rendimiento cumple nuestros objetivos de latencia para una operación que se encuentra con frecuencia en la ruta crítica de las interacciones de los usuarios.
Table 2 summarizes the latency distributions of Check, Read, Expand, and Write responses over the same 7 days. As intended, the more frequently used Safe versions of Check, Read, and Expand are significantly faster than the less frequently used Recent versions. Writes are the least frequently used of all the APIs, and the slowest because they always require distributed coordination among Spanner servers.
La Tabla 2 resume las distribuciones de latencia de las respuestas Check, Read, Expand y Write a lo largo de los mismos 7 días. Como se pretendía, las versiones Safe de Check, Read y Expand, utilizadas con más frecuencia, son significativamente más rápidas que las versiones Recent, utilizadas con menos frecuencia. Las escrituras son las menos utilizadas de todas las API, y las más lentas, porque siempre requieren coordinación distribuida entre los servidores de Spanner.
Table 2: Mean and standard deviation of RPC response latency over a 7-day period in December 2018.
Tabla 2: Media y desviación estándar de la latencia de respuesta de las RPC a lo largo de un periodo de 7 días en diciembre de 2018.
We define availability as the fraction of “qualified” RPCs the service answers successfully within latency thresholds: 5 seconds for a Safe request, and 15 seconds for a Recent request as leader re-election in Spanner may take up to 10 seconds. For an RPC to be qualified, the request must be well-formed and have a deadline longer than the latency threshold. In addition, the client must stay within its resource quota.
Definimos la disponibilidad como la fracción de RPC “cualificadas” que el servicio responde con éxito dentro de unos umbrales de latencia: 5 segundos para una solicitud Safe y 15 segundos para una solicitud Recent, ya que la reelección del líder en Spanner puede tardar hasta 10 segundos. Para que una RPC esté cualificada, la solicitud debe estar bien formada y tener un plazo límite mayor que el umbral de latencia. Además, el cliente debe mantenerse dentro de su cuota de recursos.
For these reasons, we cannot measure availability directly with live traffic, as our clients sometimes send RPCs with short deadlines or cancel their in-progress RPCs. Instead, we sample a small fraction of valid requests from live traffic and replay them later with our own probers. When replaying the requests, we set the timeout to be longer than the availability threshold. We also adjust the request zookie, if one is specified, so that the relative age of the zookie remains the same as when the request was received in the live traffic. Finally, we run 3 probers per cluster and exclude outliers to eliminate false alarms caused by rare prober failures.
Por estas razones, no podemos medir la disponibilidad directamente con tráfico real, ya que nuestros clientes envían a veces RPC con plazos límite cortos o cancelan sus RPC en curso. En su lugar, muestreamos una pequeña fracción de las solicitudes válidas del tráfico real y las reproducimos más tarde con nuestros propios sondeadores. Al reproducir las solicitudes, fijamos un tiempo de espera mayor que el umbral de disponibilidad. También ajustamos el zookie de la solicitud, si se especifica alguno, de modo que la antigüedad relativa del zookie siga siendo la misma que cuando se recibió la solicitud en el tráfico real. Por último, ejecutamos 3 sondeadores por clúster y excluimos los valores atípicos para eliminar las falsas alarmas causadas por fallos poco frecuentes de los sondeadores.
To compute availability, we aggregate success ratios over 90-day windows averaged across clusters. Figure 5 shows Zanzibar’s availability as measured by these probers. Availability has remained above 99.999% over the past 3 years of operation at Google. In other words, for every quarter, Zanzibar has less than 2 minutes of global downtime and fewer than 13 minutes when the global error ratio exceeds 10%.
Para calcular la disponibilidad, agregamos las tasas de éxito en ventanas de 90 días promediadas entre clústeres. La Figura 5 muestra la disponibilidad de Zanzibar medida por estos sondeadores. La disponibilidad se ha mantenido por encima del 99.999% durante los últimos 3 años de funcionamiento en Google. En otras palabras, en cada trimestre, Zanzibar tiene menos de 2 minutos de inactividad global y menos de 13 minutos en los que la tasa global de errores supera el 10%.
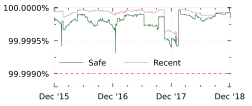
Figure 5: Zanzibar’s availability over the past three years has remained above 99.999%.
Figura 5: La disponibilidad de Zanzibar durante los últimos tres años se ha mantenido por encima del 99.999%.
Zanzibar servers delegate checks and reads to each other based on consistent hashing, and both the caller and the callee sides of the delegated operations cache the results to prevent hot spots (§3.2.5). At peak, Zanzibar handles 22 million internal “delegated” RPCs per second, split about evenly between reads and checks. In-memory caching handles approximately 200 million lookups per second at peak, 150 million from checks and 50 million from reads. Caching for checks has a 10% hit rate on the delegate’s side, with an additional 12% saved by the lock table. Meanwhile, caching on the delegator’s side has a 2% hit rate with an additional 3% from the lock table. While these hit rates appear low, they prevent 500K internal RPCs per second from creating hot spots.
Los servidores de Zanzibar se delegan entre sí comprobaciones y lecturas basándose en hashing consistente, y tanto el lado llamador como el lado llamado de las operaciones delegadas almacenan en caché los resultados para evitar puntos calientes (§3.2.5). En el pico, Zanzibar gestiona 22 millones de RPC internas “delegadas” por segundo, repartidas aproximadamente a partes iguales entre lecturas y comprobaciones. La caché en memoria gestiona aproximadamente 200 millones de búsquedas por segundo en el pico, 150 millones procedentes de comprobaciones y 50 millones procedentes de lecturas. La caché de las comprobaciones tiene una tasa de aciertos del 10% en el lado del delegado, con un 12% adicional ahorrado gracias a la tabla de bloqueos. Por su parte, la caché en el lado del delegante tiene una tasa de aciertos del 2%, con un 3% adicional procedente de la tabla de bloqueos. Aunque estas tasas de aciertos parecen bajas, evitan que 500K RPC internas por segundo creen puntos calientes.
Delegated reads see higher hit rates on the delegate’s side—24% on the cache and 9% on the lock table—but the delegator’s cache is hit less than 1% of the time. For super-hot groups, Zanzibar further optimizes by reading and caching the full set of members in advance—this happens for 0.1% of groups but further prevents hot spots.
Las lecturas delegadas presentan tasas de aciertos más altas en el lado del delegado (un 24% en la caché y un 9% en la tabla de bloqueos), pero la caché del delegante acierta menos del 1% de las veces. Para los grupos extremadamente calientes, Zanzibar optimiza aún más leyendo y almacenando en caché por adelantado el conjunto completo de miembros; esto ocurre con el 0.1% de los grupos, pero evita aún más puntos calientes.
This caching, along with aggressive pooling of read requests, allows Zanzibar to issue only 20 million read RPCs per second to Spanner. The median of these requests reads 1.5 rows per RPC, but at the 99th percentile they each read close to 1 thousand rows.
Esta caché, junto con una agrupación agresiva de las solicitudes de lectura, permite a Zanzibar emitir solo 20 millones de RPC de lectura por segundo a Spanner. La mediana de estas solicitudes lee 1.5 filas por RPC, pero en el percentil 99 cada una lee cerca de mil filas.
Zanzibar’s Spanner reads take 0.5 msec at the median, and 2 msec at the 95th percentile. We find that 1% of Spanner reads, or 200K reads per second, benefit from hedging. We note that Zanzibar uses an instance of Spanner that runs internally to Google, not an instance of Cloud Spanner [6].
Las lecturas de Zanzibar en Spanner tardan 0.5 ms en la mediana y 2 ms en el percentil 95. Observamos que el 1% de las lecturas de Spanner, es decir, 200K lecturas por segundo, se benefician de las solicitudes de cobertura. Señalamos que Zanzibar utiliza una instancia de Spanner que se ejecuta internamente en Google, no una instancia de Cloud Spanner [6].
The Leopard index is performing 1.56M QPS at the median, or 2.22M QPS at the 99th percentile, based on data aggregated over 7 days. Over the same 7 days, Leopard servers respond in fewer than 150 μsec at the median, or under 1 msec at the 99th percentile. Leopard’s incremental layer during those 7 days writes roughly 500 index updates per second at the median, and approximately 1.5K updates per second at the 99th percentile.
El índice Leopard realiza 1.56M QPS en la mediana, o 2.22M QPS en el percentil 99, según datos agregados a lo largo de 7 días. Durante esos mismos 7 días, los servidores de Leopard responden en menos de 150 μs en la mediana, o en menos de 1 ms en el percentil 99. La capa incremental de Leopard escribe durante esos 7 días aproximadamente 500 actualizaciones del índice por segundo en la mediana, y aproximadamente 1.5K actualizaciones por segundo en el percentil 99.
Zanzibar has evolved to meet the varied and heavy demands of a growing set of clients, including Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos, and YouTube. This section highlights lessons learned from this experience.
Zanzibar ha evolucionado para satisfacer las demandas variadas e intensas de un conjunto creciente de clientes, entre ellos Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos y YouTube. Esta sección destaca las lecciones aprendidas de esta experiencia.
One common theme has been the importance of flexibility to accommodate differences between clients. For example:
Un tema recurrente ha sido la importancia de la flexibilidad para adaptarse a las diferencias entre clientes. Por ejemplo:
- Access control patterns vary widely: Over time we have added features to support specific clients. For instance, we added
computed_usersetto allow inferring an object’s owner ID from the object ID prefix, which reduces space requirements for clients such as Drive and Photos that manage many private objects. Similarly, we addedtuple_to_usersetto represent object hierarchy with only one relation tuple per hop. The benefits are both space reduction and flexibility—it allows clients such as Cloud both to express ACL inheritance compactly and to change ACL inheritance rules without having to update large numbers of tuples. See §2.3.1. - Freshness requirements are often but not always loose: Clients often allow unspecified, moderate staleness during ACL evaluation, but sometimes require more precisely specified freshness. We designed our zookie protocol around this property so that we can serve most requests from a default, already replicated snapshot, while allowing clients to bound the staleness when needed. We also tuned the granularity of our snapshot timestamps to match clients’ freshness requirements. The resulting coarse timestamp quanta allow us to perform the majority of authorization checks on a small number of snapshots, thus greatly reducing the frequency of database reads. See §3.2.1.
- Los patrones de control de acceso varían ampliamente: con el tiempo hemos añadido características para dar soporte a clientes concretos. Por ejemplo, añadimos
computed_usersetpara permitir inferir el ID del propietario de un objeto a partir del prefijo del ID del objeto, lo que reduce los requisitos de espacio de clientes como Drive y Photos, que gestionan muchos objetos privados. Del mismo modo, añadimostuple_to_usersetpara representar la jerarquía de objetos con una sola tupla de relación por salto. Los beneficios son tanto la reducción de espacio como la flexibilidad: permite a clientes como Cloud tanto expresar la herencia de ACL de forma compacta como cambiar las reglas de herencia de ACL sin tener que actualizar grandes cantidades de tuplas. Véase §2.3.1. - Los requisitos de frescura suelen ser laxos, pero no siempre: los clientes a menudo admiten una desactualización moderada y no especificada durante la evaluación de las ACL, pero a veces requieren una frescura especificada con más precisión. Diseñamos nuestro protocolo de zookies en torno a esta propiedad, de modo que podamos servir la mayoría de las solicitudes a partir de una instantánea predeterminada ya replicada, permitiendo al mismo tiempo que los clientes acoten la desactualización cuando sea necesario. También ajustamos la granularidad de nuestras marcas de tiempo de instantánea para adecuarla a los requisitos de frescura de los clientes. Los cuantos gruesos de marca de tiempo resultantes nos permiten realizar la mayoría de las comprobaciones de autorización sobre un número reducido de instantáneas, lo que reduce en gran medida la frecuencia de las lecturas de la base de datos. Véase §3.2.1.
Another theme has been the need to add performance optimizations to support client behaviors observed in production. For example:
Otro tema ha sido la necesidad de añadir optimizaciones de rendimiento para dar soporte a los comportamientos de los clientes observados en producción. Por ejemplo:
- Request hedging is key to reducing tail latency: Clients that offer search capabilities to their users, such as Drive, often issue tens to hundreds of authorization checks to serve a single set of search results. We introduced hedging of Spanner and Leopard requests to prevent an occasional slow operation from slowing the overall user interaction. See §3.2.7.
- Hot-spot mitigation is critical for high availability: Some workloads create hot spots in ACL data that can overwhelm the underlying database servers. A common pattern is a burst of ACL checks for an object that is indirectly referenced by the ACLs for many different objects. Specific instances arise from the search use case mentioned above, where the documents in the search indirectly share ACLs for a large social or work group, and Cloud use cases where many objects indirectly share ACLs for the same object high in a hierarchy. Zanzibar handles most hot spots with general mechanisms such as its distributed cache and lock table, but we have found the need to optimize specific uses cases. For example, we added cache prefetching of all relation tuples for a hot object. We also delayed cancellation of secondary ACL checks when there are concurrent requests for the same ACL data. See §3.2.5.
- Performance isolation is indispensable to protect against misbehaving clients: Even with hot-spot mitigation measures, unexpected and sometimes unintended client behaviors could still overload our system or its underlying infrastructure. Examples include when clients launch new features that prove unexpectedly popular or exercise Zanzibar in unintended ways. Over time we have added isolation safeguards to ensure that there are no cascading failures between clients or between objects of the same client. These safeguards include fine-grained cost accounting, quotas, and throttling. See §3.2.6.
- Las solicitudes de cobertura son clave para reducir la latencia de cola: los clientes que ofrecen capacidades de búsqueda a sus usuarios, como Drive, emiten a menudo de decenas a cientos de comprobaciones de autorización para servir un único conjunto de resultados de búsqueda. Introdujimos las solicitudes de cobertura para las solicitudes a Spanner y a Leopard con el fin de evitar que una operación lenta ocasional ralentice la interacción global del usuario. Véase §3.2.7.
- La mitigación de los puntos calientes es crítica para la alta disponibilidad: algunas cargas de trabajo crean puntos calientes en los datos de las ACL que pueden desbordar los servidores de bases de datos subyacentes. Un patrón habitual es una ráfaga de comprobaciones de ACL para un objeto al que hacen referencia indirectamente las ACL de muchos objetos distintos. Surgen casos concretos del caso de uso de búsqueda mencionado anteriormente, donde los documentos de la búsqueda comparten indirectamente las ACL de un gran grupo social o de trabajo, y de los casos de uso de Cloud, donde muchos objetos comparten indirectamente las ACL de un mismo objeto situado en lo alto de una jerarquía. Zanzibar gestiona la mayoría de los puntos calientes con mecanismos generales como su caché distribuida y su tabla de bloqueos, pero hemos visto la necesidad de optimizar casos de uso concretos. Por ejemplo, añadimos la precarga en caché de todas las tuplas de relación de un objeto caliente. También retrasamos la cancelación de las comprobaciones de ACL secundarias cuando hay solicitudes concurrentes para los mismos datos de ACL. Véase §3.2.5.
- El aislamiento de rendimiento es indispensable para protegerse de los clientes que se comportan mal: incluso con medidas de mitigación de los puntos calientes, comportamientos inesperados, y a veces no intencionados, de los clientes podrían seguir sobrecargando nuestro sistema o su infraestructura subyacente. Algunos ejemplos son los casos en que los clientes lanzan nuevas funcionalidades que resultan inesperadamente populares o utilizan Zanzibar de formas no previstas. Con el tiempo, hemos añadido salvaguardas de aislamiento para garantizar que no se produzcan fallos en cascada entre clientes ni entre objetos de un mismo cliente. Estas salvaguardas incluyen una contabilidad de costes de grano fino, cuotas y limitación de la tasa de solicitudes. Véase §3.2.6.
Zanzibar is a planet-scale distributed ACL storage and evaluation system. Many of its authorization concepts have been explored previously within the domains of access control and social graphs, and its scaling challenges have been investigated within the field of distributed systems.
Zanzibar es un sistema distribuido de almacenamiento y evaluación de ACL a escala planetaria. Muchos de sus conceptos de autorización se han explorado previamente en los ámbitos del control de acceso y de los grafos sociales, y sus desafíos de escalabilidad se han investigado en el campo de los sistemas distribuidos.
Access control is a core part of multi-user operating systems. Multics [23] supports ACLs on segments and directories. ACL entries consist of a principal identifier and a set of permissions bits. In the first edition of UNIX [9], file flags indicate whether owner and non-owner can read or write the file. By the 4th edition, the permissions bits had been expanded to read/write/execute bits for owner, group, and others. POSIX ACLs [4] add an arbitrary list of users and groups, each with up to 32 permissions bits. VMS [7, 8] supports ACL inheritance for files created within a directory tree. Zanzibar’s data model supports permissions, users, groups, and inheritance as found in the above systems.
El control de acceso es una parte central de los sistemas operativos multiusuario. Multics [23] admite ACL sobre segmentos y directorios. Las entradas de las ACL constan de un identificador de principal y de un conjunto de bits de permisos. En la primera edición de UNIX [9], unos indicadores de archivo señalan si el propietario y quienes no son propietarios pueden leer o escribir el archivo. Para la 4.ª edición, los bits de permisos se habían ampliado a bits de lectura/escritura/ejecución para el propietario, el grupo y los demás. Las ACL de POSIX [4] añaden una lista arbitraria de usuarios y grupos, cada uno con hasta 32 bits de permisos. VMS [7, 8] admite la herencia de ACL para los archivos creados dentro de un árbol de directorios. El modelo de datos de Zanzibar admite permisos, usuarios, grupos y herencia tal como se encuentran en los sistemas anteriores.
Taos [24, 10] supports compound principals that incorporate how an identity has been transformed as it passes through a distributed system. For example, if user logged into workstation to access file server , would see requests authenticated as “ for ” rather than just . This would allow one to write an ACL on a user’s e-mail that would be accessible only to the user, and only if being accessed via the mail server. Abadi et al. discuss in [11] a model of group-based ACLs with support for compound identities. Their notion of “blessings” are similar to Zanzibar tuples. However, Zanzibar adopts a unified representation for ACLs and groups using usersets, while they are separate concepts in [11].
Taos [24, 10] admite principales compuestos que incorporan cómo se ha transformado una identidad a medida que atraviesa un sistema distribuido. Por ejemplo, si el usuario iniciara sesión en la estación de trabajo para acceder al servidor de archivos , vería solicitudes autenticadas como “ en nombre de ” en lugar de simplemente . Esto permitiría escribir una ACL sobre el correo electrónico de un usuario que solo fuera accesible para ese usuario, y solo si se accede a través del servidor de correo. Abadi et al. analizan en [11] un modelo de ACL basadas en grupos con soporte para identidades compuestas. Su noción de “blessings” es similar a las tuplas de Zanzibar. Sin embargo, Zanzibar adopta una representación unificada de las ACL y los grupos mediante usersets, mientras que en [11] son conceptos separados.
Role-based access control (RBAC), first proposed in [17], introduced the notion of roles, which are similar to Zanzibar relations. Roles can inherit from each other and imply permissions. A number of Zanzibar clients have implemented RBAC policies on top of Zanzibar’s namespace configuration language.
El control de acceso basado en roles (RBAC), propuesto por primera vez en [17], introdujo la noción de roles, que son similares a las relaciones de Zanzibar. Los roles pueden heredar unos de otros e implicar permisos. Varios clientes de Zanzibar han implementado políticas RBAC sobre el lenguaje de configuración de espacios de nombres de Zanzibar.
A discussion of ACL stores in 2019 would be remiss without mentioning the Identity and Access Management (IAM) systems offered commercially by Amazon [1], Google [5], Microsoft [2], and others. These systems allow customers of those companies’ cloud products to configure flexible access controls based on various features such as: assigning users to roles or groups; domain-specific policy languages; and APIs that allow the creation and modification of ACLs. What all of these systems have in common is unified ACL storage and an RPC-based API, a philosophy also core to Zanzibar’s design. Google’s Cloud IAM system [5] is built as a layer on top of Zanzibar’s ACL storage and evaluation system.
Un análisis de los almacenes de ACL en 2019 sería incompleto sin mencionar los sistemas de gestión de identidades y accesos (IAM) ofrecidos comercialmente por Amazon [1], Google [5], Microsoft [2] y otros. Estos sistemas permiten a los clientes de los productos en la nube de esas empresas configurar controles de acceso flexibles basados en diversas características, como: la asignación de usuarios a roles o grupos; lenguajes de políticas específicos del dominio; y API que permiten la creación y modificación de ACL. Lo que todos estos sistemas tienen en común es un almacenamiento unificado de ACL y una API basada en RPC, una filosofía también central en el diseño de Zanzibar. El sistema Cloud IAM de Google [5] está construido como una capa sobre el sistema de almacenamiento y evaluación de ACL de Zanzibar.
TAO [13] is a distributed datastore for Facebook’s social graph. Several Zanzibar clients also use Zanzibar to store their social graphs. Both Zanzibar and TAO provide authorization checks to clients. Both are deployed as single-instance services, both operate at a large scale, and both are optimized for read-only operations. TAO offers eventual global consistency with asynchronous replication and best-effort read-after-write consistency with synchronous cache updates. In contrast, Zanzibar provides external consistency and snapshot reads with bounded staleness, so that it respects causal ordering between ACL and content updates and thus protects against the “new enemy” problem.
TAO [13] es un almacén de datos distribuido para el grafo social de Facebook. Varios clientes de Zanzibar también utilizan Zanzibar para almacenar sus grafos sociales. Tanto Zanzibar como TAO proporcionan comprobaciones de autorización a los clientes. Ambos se despliegan como servicios de instancia única, ambos operan a gran escala y ambos están optimizados para operaciones de solo lectura. TAO ofrece consistencia global eventual con replicación asíncrona y consistencia de lectura tras escritura en la medida de lo posible (best-effort) con actualizaciones síncronas de la caché. En cambio, Zanzibar proporciona consistencia externa y lecturas de instantánea con desactualización acotada, de modo que respeta el orden causal entre las actualizaciones de ACL y de contenido y, por tanto, protege frente al problema del “nuevo enemigo”.
Lamport clocks [22] provide partially ordered vector timestamps that can be used to determine the order of events. However, Lamport clocks require explicit participation of all “processes”, where in Zanzibar’s use cases some of the “processes” can be external clients or even human users. In contrast, Zanzibar relies on its underlying database system, Spanner [15], to offer both external consistency and snapshot reads with bounded staleness. In particular, Zanzibar builds on Spanner’s TrueTime abstraction [15] to provide linearizable commit timestamps encoded as zookies.
Los relojes de Lamport [22] proporcionan marcas de tiempo vectoriales parcialmente ordenadas que pueden utilizarse para determinar el orden de los eventos. Sin embargo, los relojes de Lamport requieren la participación explícita de todos los “procesos”, mientras que en los casos de uso de Zanzibar algunos de los “procesos” pueden ser clientes externos o incluso usuarios humanos. En cambio, Zanzibar se apoya en su sistema de base de datos subyacente, Spanner [15], para ofrecer tanto consistencia externa como lecturas de instantánea con desactualización acotada. En particular, Zanzibar se basa en la abstracción TrueTime de Spanner [15] para proporcionar marcas de tiempo de confirmación linealizables codificadas como zookies.
At the same time, Zanzibar adds a number of features on top of those provided by Spanner. For one, the zookie protocol does not let clients read or evaluate ACLs at an arbitrary snapshot. This restriction allows Zanzibar to choose a snapshot that facilitates fast ACL evaluation. In addition, Zanzibar provides resilience to database hotspots (e.g. authorization checks on a suddenly popular video) and safe pointer chasing despite potentially deep recursion (e.g. membership checks on hierarchical groups).
Al mismo tiempo, Zanzibar añade varias características a las que proporciona Spanner. Por un lado, el protocolo de zookies no permite a los clientes leer o evaluar ACL en una instantánea arbitraria. Esta restricción permite a Zanzibar elegir una instantánea que facilite una evaluación rápida de las ACL. Además, Zanzibar proporciona resiliencia frente a los puntos calientes de la base de datos (p. ej., comprobaciones de autorización sobre un vídeo que se vuelve popular de repente) y una persecución de punteros segura a pesar de una recursión potencialmente profunda (p. ej., comprobaciones de pertenencia en grupos jerárquicos).
The Chubby distributed lock service [14] offers reliable storage, linearizes writes, and provides access control, but it lacks features needed to support Zanzibar’s use cases. In particular, it does not support high volumes of data, efficient range reads, or reads at a client-specified snapshot with bounded staleness. Its cache invalidation mechanism also limits its write throughput.
El servicio de bloqueo distribuido Chubby [14] ofrece almacenamiento fiable, linealiza las escrituras y proporciona control de acceso, pero carece de características necesarias para dar soporte a los casos de uso de Zanzibar. En particular, no admite grandes volúmenes de datos, lecturas de rangos eficientes ni lecturas en una instantánea especificada por el cliente con desactualización acotada. Su mecanismo de invalidación de la caché también limita su rendimiento de escritura.
Finally, ZooKeeper offers a high-performance coordination service [19] but also lacks features required by Zanzibar. Relative to Chubby, it can handle higher read and write rates with more relaxed cache consistency. However, it does not provide external consistency for updates across different nodes since its linearizability is on a per-node basis. It also does not provide snapshot reads with bounded staleness.
Por último, ZooKeeper ofrece un servicio de coordinación de alto rendimiento [19], pero también carece de características requeridas por Zanzibar. En comparación con Chubby, puede gestionar tasas de lectura y escritura más altas con una consistencia de caché más relajada. Sin embargo, no proporciona consistencia externa para las actualizaciones entre nodos distintos, ya que su linealizabilidad se da nodo por nodo. Tampoco proporciona lecturas de instantánea con desactualización acotada.
The Zanzibar authorization system unifies access control data and logic for Google. Its simple yet flexible data model and configuration language support a variety of access control policies from both consumer and enterprise applications.
El sistema de autorización Zanzibar unifica los datos y la lógica de control de acceso de Google. Su modelo de datos y su lenguaje de configuración, sencillos pero flexibles, admiten una variedad de políticas de control de acceso tanto de aplicaciones de consumo como empresariales.
Zanzibar’s external consistency model is one of its most salient features. It respects the ordering of user actions, yet at the same time allows authorization checks to be evaluated at distributed locations without global synchronization.
El modelo de consistencia externa de Zanzibar es una de sus características más destacadas. Respeta el orden de las acciones de los usuarios y, al mismo tiempo, permite evaluar las comprobaciones de autorización en ubicaciones distribuidas sin sincronización global.
Zanzibar employs other key techniques to provide scalability, low latency, and high availability. For example, it evaluates deeply or widely nested group membership with Leopard, a specialized index for efficient computation of set operations with snapshot consistency. As another example, it combines a distributed cache with a mechanism to deduplicate in-flight requests. It thus mitigates hot spots, a critical production issue when serving data on top of normalized, consistent storage. These measures together result in a system that scales to trillions of access control rules and millions of authorization requests per second.
Zanzibar emplea otras técnicas clave para proporcionar escalabilidad, baja latencia y alta disponibilidad. Por ejemplo, evalúa la pertenencia a grupos anidados en profundidad o en anchura con Leopard, un índice especializado para el cálculo eficiente de operaciones de conjuntos con consistencia de instantánea. Como otro ejemplo, combina una caché distribuida con un mecanismo para deduplicar las solicitudes en curso. De este modo mitiga los puntos calientes, un problema crítico en producción cuando se sirven datos sobre un almacenamiento normalizado y consistente. En conjunto, estas medidas dan como resultado un sistema que escala a billones de reglas de control de acceso y millones de solicitudes de autorización por segundo.
Many people have made technical contributions to Zanzibar. We thank previous and recent members of the development team, including Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp, and Yuliya Zabiyaka. We also thank previous and current members of the Site Reliability Engineering team, including Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson, and Andrea Yu.
Muchas personas han realizado contribuciones técnicas a Zanzibar. Damos las gracias a los miembros anteriores y recientes del equipo de desarrollo, entre ellos Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp y Yuliya Zabiyaka. También damos las gracias a los miembros anteriores y actuales del equipo de Site Reliability Engineering, entre ellos Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson y Andrea Yu.
In addition, a number of people have helped to improve this paper. We received insightful comments from David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen, and Lawrence You. We are also grateful to Nadav Eiron and Royal Hansen for their support. Finally, we thank the anonymous reviewers and our shepherd, Eric Eide, for their constructive feedback.
Además, varias personas han ayudado a mejorar este artículo. Recibimos comentarios perspicaces de David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen y Lawrence You. También estamos agradecidos a Nadav Eiron y Royal Hansen por su apoyo. Por último, damos las gracias a los revisores anónimos y a nuestro revisor guía (shepherd), Eric Eide, por sus comentarios constructivos.