Determining whether online users are authorized to access digital objects is central to preserving privacy. This paper presents the design, implementation, and deployment of Zanzibar, a global system for storing and evaluating access control lists. Zanzibar provides a uniform data model and configuration language for expressing a wide range of access control policies from hundreds of client services at Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Its authorization decisions respect causal ordering of user actions and thus provide external consistency amid changes to access control lists and object contents. Zanzibar scales to trillions of access control lists and millions of authorization requests per second to support services used by billions of people. It has maintained 95th-percentile latency of less than 10 milliseconds and availability of greater than 99.999% over 3 years of production use.
Déterminer si des utilisateurs en ligne sont autorisés à accéder à des objets numériques est essentiel à la préservation de la vie privée. Cet article présente la conception, l’implémentation et le déploiement de Zanzibar, un système global de stockage et d’évaluation de listes de contrôle d’accès. Zanzibar fournit un modèle de données et un langage de configuration uniformes permettant d’exprimer un large éventail de politiques de contrôle d’accès provenant de centaines de services clients de Google, dont Calendar, Cloud, Drive, Maps, Photos et YouTube. Ses décisions d’autorisation respectent l’ordre causal des actions des utilisateurs et assurent ainsi la cohérence externe en dépit des modifications apportées aux listes de contrôle d’accès et au contenu des objets. Zanzibar passe à l’échelle de milliers de milliards de listes de contrôle d’accès et de millions de requêtes d’autorisation par seconde afin de prendre en charge des services utilisés par des milliards de personnes. Il a maintenu une latence au 95e centile inférieure à 10 millisecondes et une disponibilité supérieure à 99.999% sur 3 années d’utilisation en production.
Many online interactions require authorization checks to confirm that a user has permission to carry out an operation on a digital object. For example, web-based photo storage services typically allow photo owners to share some photos with friends while keeping other photos private. Such a service must check whether a photo has been shared with a user before allowing that user to view the photo. Robust authorization checks are central to preserving online privacy.
De nombreuses interactions en ligne nécessitent des vérifications d’autorisation pour confirmer qu’un utilisateur a la permission d’effectuer une opération sur un objet numérique. Par exemple, les services web de stockage de photos permettent généralement aux propriétaires de photos de partager certaines photos avec des amis tout en gardant d’autres photos privées. Un tel service doit vérifier si une photo a été partagée avec un utilisateur avant de permettre à cet utilisateur de la voir. Des vérifications d’autorisation robustes sont essentielles à la préservation de la vie privée en ligne.
This paper presents Zanzibar, a system for storing permissions and performing authorization checks based on the stored permissions. It is used by a wide array of services offered by Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Several of these services manage billions of objects on behalf of more than a billion users.
Cet article présente Zanzibar, un système de stockage des permissions et de vérification des autorisations fondée sur les permissions stockées. Il est utilisé par un large éventail de services proposés par Google, dont Calendar, Cloud, Drive, Maps, Photos et YouTube. Plusieurs de ces services gèrent des milliards d’objets pour le compte de plus d’un milliard d’utilisateurs.
A unified authorization system offers important advantages over maintaining separate access control mechanisms for individual applications. First, it helps establish consistent semantics and user experience across applications. Second, it makes it easier for applications to interoperate, for example, to coordinate access control when an object from one application embeds an object from another application. Third, useful common infrastructure can be built on top of a unified access control system, in particular, a search index that respects access control and works across applications. Finally, as we show below, authorization poses unique challenges involving data consistency and scalability. It saves engineering resources to tackle them once across applications.
Un système d’autorisation unifié offre d’importants avantages par rapport au maintien de mécanismes de contrôle d’accès distincts pour chaque application. Premièrement, il aide à établir une sémantique et une expérience utilisateur cohérentes entre les applications. Deuxièmement, il facilite l’interopérabilité des applications, par exemple pour coordonner le contrôle d’accès lorsqu’un objet d’une application intègre un objet d’une autre application. Troisièmement, une infrastructure commune utile peut être construite au-dessus d’un système de contrôle d’accès unifié, en particulier un index de recherche qui respecte le contrôle d’accès et fonctionne d’une application à l’autre. Enfin, comme nous le montrons ci-dessous, l’autorisation pose des défis uniques en matière de cohérence des données et de passage à l’échelle. Les relever une seule fois pour l’ensemble des applications permet d’économiser des ressources d’ingénierie.
We have the following goals for the Zanzibar system:
Nous avons fixé les objectifs suivants pour le système Zanzibar :
- Correctness: It must ensure consistency of access control decisions to respect user intentions.
- Flexibility: It must support a rich set of access control policies as required by both consumer and enterprise applications.
- Low latency: It must respond quickly because authorization checks are often in the critical path of user interactions. Low latency at the tail is particularly important for serving search results, which often require tens to hundreds of checks.
- High availability: It must reliably respond to requests because, in the absence of explicit authorizations, client services would be forced to deny their users access.
- Large scale: It needs to protect billions of objects shared by billions of users. It must be deployed around the globe to be near its clients and their end users.
- Exactitude : il doit garantir la cohérence des décisions de contrôle d’accès afin de respecter les intentions des utilisateurs.
- Flexibilité : il doit prendre en charge un ensemble riche de politiques de contrôle d’accès, comme l’exigent à la fois les applications grand public et les applications d’entreprise.
- Faible latence : il doit répondre rapidement, car les vérifications d’autorisation se trouvent souvent sur le chemin critique des interactions des utilisateurs. Une faible latence de queue est particulièrement importante pour servir des résultats de recherche, qui nécessitent souvent des dizaines à des centaines de vérifications.
- Haute disponibilité : il doit répondre de manière fiable aux requêtes car, en l’absence d’autorisations explicites, les services clients seraient contraints de refuser l’accès à leurs utilisateurs.
- Grande échelle : il doit protéger des milliards d’objets partagés par des milliards d’utilisateurs. Il doit être déployé sur l’ensemble du globe afin d’être proche de ses clients et de leurs utilisateurs finaux.
Zanzibar achieves these goals through a combination of notable features. To provide flexibility, Zanzibar pairs a simple data model with a powerful configuration language. The language allows clients to define arbitrary relations between users and objects, such as owner, editor, commenter, and viewer. It includes set-algebraic operators such as intersection and union for specifying potentially complex access control policies in terms of those user-object relations. For example, an application can specify that users granted editing rights on a document are also allowed to comment on the document, but not all commenters are given editing rights.
Zanzibar atteint ces objectifs grâce à une combinaison de caractéristiques notables. Pour offrir de la flexibilité, Zanzibar associe un modèle de données simple à un langage de configuration puissant. Ce langage permet aux clients de définir des relations arbitraires entre utilisateurs et objets, telles que owner, editor, commenter et viewer. Il comprend des opérateurs ensemblistes, tels que l’intersection et l’union, pour spécifier des politiques de contrôle d’accès potentiellement complexes en fonction de ces relations utilisateur-objet. Par exemple, une application peut spécifier que les utilisateurs disposant de droits de modification sur un document sont également autorisés à commenter ce document, mais que tous les commentateurs ne reçoivent pas de droits de modification.
At runtime, Zanzibar allows clients to create, modify, and evaluate access control lists (ACLs) through a remote procedure call (RPC) interface. A simple ACL takes the form of “user U has relation R to object O”. More complex ACLs take the form of “set of users S has relation R to object O”, where S is itself specified in terms of another object-relation pair. ACLs can thus refer to other ACLs, for example to specify that the set of users who can comment on a video consists of the users who have been granted viewing rights on that specific video along with those with viewing permissions on the video channel.
À l’exécution, Zanzibar permet aux clients de créer, de modifier et d’évaluer des listes de contrôle d’accès (ACL) au moyen d’une interface d’appel de procédure à distance (RPC). Une ACL simple prend la forme « l’utilisateur U a la relation R avec l’objet O ». Des ACL plus complexes prennent la forme « l’ensemble d’utilisateurs S a la relation R avec l’objet O », où S est lui-même spécifié au moyen d’une autre paire objet-relation. Les ACL peuvent ainsi faire référence à d’autres ACL, par exemple pour spécifier que l’ensemble des utilisateurs pouvant commenter une vidéo se compose des utilisateurs qui ont reçu des droits de visionnage sur cette vidéo précise ainsi que de ceux qui disposent de permissions de visionnage sur la chaîne de la vidéo.
Group memberships are an important class of ACL where the object is a group and the relation is semantically equivalent to member. Groups can contain other groups, which illustrates one of the challenges facing Zanzibar, namely that evaluating whether a user belongs to a group can entail following a long chain of nested group memberships.
Les appartenances à des groupes constituent une catégorie importante d’ACL, dans laquelle l’objet est un groupe et la relation est sémantiquement équivalente à member. Les groupes peuvent contenir d’autres groupes, ce qui illustre l’un des défis auxquels Zanzibar est confronté, à savoir qu’évaluer si un utilisateur appartient à un groupe peut impliquer de suivre une longue chaîne d’appartenances à des groupes imbriqués.
Authorization checks take the form of “does user U have relation R to object O?” and are evaluated by a collection of distributed servers. When a check request arrives to Zanzibar, the work to evaluate the check may fan out to multiple servers, for example when a group contains both individual members and other groups. Each of those servers may in turn contact other servers, for example to recursively traverse a hierarchy of group memberships.
Les vérifications d’autorisation prennent la forme « l’utilisateur U a-t-il la relation R avec l’objet O ? » et sont évaluées par un ensemble de serveurs distribués. Lorsqu’une requête de vérification parvient à Zanzibar, le travail d’évaluation de la vérification peut être réparti sur plusieurs serveurs, par exemple lorsqu’un groupe contient à la fois des membres individuels et d’autres groupes. Chacun de ces serveurs peut à son tour contacter d’autres serveurs, par exemple pour parcourir récursivement une hiérarchie d’appartenances à des groupes.
Zanzibar operates at a global scale along multiple dimensions. It stores more than two trillion ACLs and performs millions of authorization checks per second. The ACL data does not lend itself to geographic partitioning because authorization checks for any object can come from anywhere in the world. Therefore, Zanzibar replicates all ACL data in tens of geographically distributed data centers and distributes load across thousands of servers around the world.
Zanzibar fonctionne à l’échelle mondiale selon plusieurs dimensions. Il stocke plus de deux mille milliards d’ACL et effectue des millions de vérifications d’autorisation par seconde. Les données d’ACL ne se prêtent pas à un partitionnement géographique, car les vérifications d’autorisation portant sur n’importe quel objet peuvent provenir de n’importe où dans le monde. Par conséquent, Zanzibar réplique toutes les données d’ACL dans des dizaines de centres de données géographiquement distribués et répartit la charge sur des milliers de serveurs dans le monde entier.
Zanzibar supports global consistency of access control decisions through two interrelated features. One, it respects the order in which ACL changes are committed to the underlying data store. Two, it can ensure that authorization checks are based on ACL data no older than a client-specified change. Thus, for example, a client can remove a user from a group and be assured that subsequent membership checks reflect that removal. Zanzibar provides these ordering properties by storing ACLs in a globally distributed database system with external consistency guarantees [15, 18].
Zanzibar assure la cohérence globale des décisions de contrôle d’accès grâce à deux caractéristiques interdépendantes. D’une part, il respecte l’ordre dans lequel les modifications d’ACL sont validées dans le stockage de données sous-jacent. D’autre part, il peut garantir que les vérifications d’autorisation reposent sur des données d’ACL qui ne sont pas plus anciennes qu’une modification spécifiée par le client. Ainsi, par exemple, un client peut retirer un utilisateur d’un groupe et avoir l’assurance que les vérifications d’appartenance ultérieures refléteront ce retrait. Zanzibar fournit ces propriétés d’ordonnancement en stockant les ACL dans un système de base de données distribué à l’échelle mondiale qui offre des garanties de cohérence externe [15, 18].
Zanzibar employs an array of techniques to achieve low latency and high availability in this globally distributed environment. Its consistency protocol allows the vast majority of requests to be served with locally replicated data, without requiring cross-region round trips. Zanzibar stores its data in normalized forms for consistency. It handles hot spots on normalized data by caching final and intermediate results, and by deduplicating simultaneous requests. It also applies techniques such as hedging requests and optimizing computations on deeply nested sets with limited denormalization. Zanzibar responds to more than 95% of authorization checks within 10 milliseconds and has maintained more than 99.999% availability for the last 3 years.
Zanzibar emploie un ensemble de techniques pour atteindre une faible latence et une haute disponibilité dans cet environnement distribué à l’échelle mondiale. Son protocole de cohérence permet de servir la grande majorité des requêtes avec des données répliquées localement, sans nécessiter d’allers-retours entre régions. Zanzibar stocke ses données sous des formes normalisées par souci de cohérence. Il gère les points chauds sur les données normalisées en mettant en cache les résultats finaux et intermédiaires, et en dédupliquant les requêtes simultanées. Il applique également des techniques telles que les requêtes de couverture (hedging) et l’optimisation des calculs sur des ensembles profondément imbriqués au moyen d’une dénormalisation limitée. Zanzibar répond à plus de 95% des vérifications d’autorisation en moins de 10 millisecondes et a maintenu une disponibilité supérieure à 99.999% au cours des 3 dernières années.
The main contributions of this paper lie in conveying the engineering challenges in building and deploying a consistent, world-scale authorization system. While most elements of Zanzibar’s design have their roots in previous research, this paper provides a record of the features and techniques Zanzibar brings together to satisfy its stringent requirements for correctness, flexibility, latency, availability, and scalability. The paper also highlights lessons learned from operating Zanzibar in service of a diverse set of demanding clients.
Les principales contributions de cet article consistent à exposer les défis d’ingénierie que posent la construction et le déploiement d’un système d’autorisation cohérent à l’échelle mondiale. Bien que la plupart des éléments de la conception de Zanzibar trouvent leurs racines dans des travaux de recherche antérieurs, cet article consigne les fonctionnalités et les techniques que Zanzibar réunit pour satisfaire ses exigences strictes en matière d’exactitude, de flexibilité, de latence, de disponibilité et de passage à l’échelle. L’article met également en lumière les enseignements tirés de l’exploitation de Zanzibar au service d’un ensemble varié de clients exigeants.
This section describes Zanzibar’s data model, configuration language, and application programming interface (API).
Cette section décrit le modèle de données, le langage de configuration et l’interface de programmation d’applications (API) de Zanzibar.
In Zanzibar, ACLs are collections of object-user or object-object relations represented as relation tuples. Groups are simply ACLs with membership semantics. Relation tuples have efficient binary encodings, but in this paper we represent them using a convenient text notation:
Dans Zanzibar, les ACL sont des collections de relations objet-utilisateur ou objet-objet représentées sous forme de tuples de relation. Les groupes sont simplement des ACL dotées d’une sémantique d’appartenance. Les tuples de relation disposent d’encodages binaires efficaces, mais dans cet article nous les représentons à l’aide d’une notation textuelle pratique :
where ⟨namespace⟩ and ⟨relation⟩ are predefined in client configurations (§2.3), ⟨object_id⟩ is a string, and ⟨user_id⟩ is an integer. The primary keys required to identify a relation tuple are ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩, and ⟨user⟩. One feature worth noting is that a ⟨userset⟩ allows ACLs to refer to groups and thus supports representing nested group membership.
où ⟨namespace⟩ et ⟨relation⟩ sont prédéfinis dans les configurations des clients (§2.3), ⟨object_id⟩ est une chaîne de caractères et ⟨user_id⟩ est un entier. Les clés primaires nécessaires pour identifier un tuple de relation sont ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩ et ⟨user⟩. Une caractéristique notable est qu’un ⟨userset⟩ permet aux ACL de faire référence à des groupes et permet ainsi de représenter l’appartenance à des groupes imbriqués.
Table 1 shows some example tuples and corresponding semantics. While some relations (e.g. viewer) define access control directly, others (e.g. parent, pointing to a folder) only define abstract relations between objects. These abstract relations may indirectly affect access control given userset rewrite rules specified in namespace configs (§2.3.1).
Le tableau 1 présente quelques exemples de tuples et la sémantique correspondante. Alors que certaines relations (p. ex. viewer) définissent directement le contrôle d’accès, d’autres (p. ex. parent, qui pointe vers un dossier) ne définissent que des relations abstraites entre objets. Ces relations abstraites peuvent affecter indirectement le contrôle d’accès, compte tenu des règles de réécriture de userset (ensemble d’utilisateurs) spécifiées dans les configurations d’espaces de noms (§2.3.1).
Table 1: Example relation tuples. “#...” represents a relation that does not affect the semantics of the tuple.
Tableau 1 : Exemples de tuples de relation. « #... » représente une relation qui n’affecte pas la sémantique du tuple.
Defining our data model around tuples, instead of per-object ACLs, allows us to unify the concepts of ACLs and groups and to support efficient reads and incremental updates, as we will see in §2.4.
Le fait de définir notre modèle de données autour de tuples, plutôt que d’ACL par objet, nous permet d’unifier les concepts d’ACL et de groupe, et de prendre en charge des lectures efficaces et des mises à jour incrémentales, comme nous le verrons au §2.4.
ACL checks must respect the order in which users modify ACLs and object contents to avoid unexpected sharing behaviors. Specifically, our clients care about preventing the “new enemy” problem, which can arise when we fail to respect the ordering between ACL updates or when we apply old ACLs to new content. Consider these two examples:
Les vérifications d’ACL doivent respecter l’ordre dans lequel les utilisateurs modifient les ACL et le contenu des objets afin d’éviter des comportements de partage inattendus. Plus précisément, nos clients tiennent à prévenir le problème du « nouvel ennemi », qui peut survenir lorsque nous ne respectons pas l’ordre entre les mises à jour d’ACL ou lorsque nous appliquons d’anciennes ACL à un nouveau contenu. Considérons ces deux exemples :
Example A: Neglecting ACL update order
- Alice removes Bob from the ACL of a folder;
- Alice then asks Charlie to move new documents to the folder, where document ACLs inherit from folder ACLs;
- Bob should not be able to see the new documents, but may do so if the ACL check neglects the ordering between the two ACL changes.
Exemple A : négligence de l’ordre des mises à jour d’ACL
- Alice retire Bob de l’ACL d’un dossier ;
- Alice demande ensuite à Charlie de déplacer de nouveaux documents dans le dossier, les ACL des documents héritant des ACL du dossier ;
- Bob ne devrait pas pouvoir voir les nouveaux documents, mais pourrait le faire si la vérification d’ACL néglige l’ordre entre les deux modifications d’ACL.
Example B: Misapplying old ACL to new content
- Alice removes Bob from the ACL of a document;
- Alice then asks Charlie to add new contents to the document;
- Bob should not be able to see the new contents, but may do so if the ACL check is evaluated with a stale ACL from before Bob’s removal.
Exemple B : application erronée d’une ancienne ACL à un nouveau contenu
- Alice retire Bob de l’ACL d’un document ;
- Alice demande ensuite à Charlie d’ajouter du nouveau contenu au document ;
- Bob ne devrait pas pouvoir voir le nouveau contenu, mais pourrait le faire si la vérification d’ACL est évaluée avec une ACL obsolète datant d’avant le retrait de Bob.
Preventing the “new enemy” problem requires Zanzibar to understand and respect the causal ordering between ACL or content updates, including updates on different ACLs or objects and those coordinated via channels invisible to Zanzibar. Hence Zanzibar must provide two key consistency properties: external consistency [18] and snapshot reads with bounded staleness.
Prévenir le problème du « nouvel ennemi » exige que Zanzibar comprenne et respecte l’ordre causal entre les mises à jour d’ACL ou de contenu, y compris les mises à jour portant sur des ACL ou des objets différents et celles coordonnées par des canaux invisibles pour Zanzibar. Zanzibar doit donc fournir deux propriétés de cohérence essentielles : la cohérence externe [18] et les lectures d’instantané à obsolescence bornée.
External consistency allows Zanzibar to assign a timestamp to each ACL or content update, such that two causally related updates will be assigned timestamps that reflect the causal order: . With causally meaningful timestamps, a snapshot read of the ACL database at timestamp , which observes all updates with timestamps , will respect ordering between ACL updates. That is, if the read observes an update , it will observe all updates that happen causally before .
La cohérence externe permet à Zanzibar d’attribuer un horodatage à chaque mise à jour d’ACL ou de contenu, de sorte que deux mises à jour causalement liées se voient attribuer des horodatages qui reflètent l’ordre causal : . Avec des horodatages porteurs de sens causal, une lecture d’instantané de la base de données d’ACL à l’horodatage , qui observe toutes les mises à jour dont l’horodatage est , respectera l’ordre entre les mises à jour d’ACL. Autrement dit, si la lecture observe une mise à jour , elle observera toutes les mises à jour qui se produisent causalement avant .
Furthermore, to avoid applying old ACLs to new contents, the ACL check evaluation snapshot must not be staler than the causal timestamp assigned to the content update. Given a content update at timestamp , a snapshot read at timestamp ensures that all ACL updates that happen causally before the content update will be observed by the ACL check.
En outre, pour éviter d’appliquer d’anciennes ACL à un nouveau contenu, l’instantané d’évaluation de la vérification d’ACL ne doit pas être plus obsolète que l’horodatage causal attribué à la mise à jour du contenu. Étant donné une mise à jour du contenu à l’horodatage , une lecture d’instantané à un horodatage garantit que toutes les mises à jour d’ACL qui se produisent causalement avant la mise à jour du contenu seront observées par la vérification d’ACL.
To provide external consistency and snapshot reads with bounded staleness, we store ACLs in the Spanner global database system [15]. Spanner’s TrueTime mechanism assigns each ACL write a microsecond-resolution timestamp, such that the timestamps of writes reflect the causal ordering between writes, and thereby provide external consistency. We evaluate each ACL check at a single snapshot timestamp across multiple database reads, so that all writes with timestamps up to the check snapshot, and only those writes, are visible to the ACL check.
Pour assurer la cohérence externe et des lectures d’instantané à obsolescence bornée, nous stockons les ACL dans le système de base de données global Spanner [15]. Le mécanisme TrueTime de Spanner attribue à chaque écriture d’ACL un horodatage à la résolution de la microseconde, de sorte que les horodatages des écritures reflètent l’ordre causal entre les écritures et assurent ainsi la cohérence externe. Nous évaluons chaque vérification d’ACL à un unique horodatage d’instantané sur l’ensemble des multiples lectures de la base de données, de sorte que toutes les écritures dont l’horodatage va jusqu’à celui de l’instantané de la vérification, et seulement ces écritures, soient visibles par la vérification d’ACL.
To avoid evaluating checks for new contents using stale ACLs, one could try to always evaluate at the latest snapshot such that the check result reflects all ACL writes up to the check call. However, such evaluation would require global data synchronization with high-latency round trips and limited availability. Instead, we design the following protocol to allow most checks to be evaluated on already replicated data with cooperation from Zanzibar clients:
Pour éviter d’évaluer des vérifications portant sur un nouveau contenu à l’aide d’ACL obsolètes, on pourrait tenter de toujours évaluer au dernier instantané, de sorte que le résultat de la vérification reflète toutes les écritures d’ACL jusqu’à l’appel de vérification. Cependant, une telle évaluation nécessiterait une synchronisation globale des données, avec des allers-retours à forte latence et une disponibilité limitée. Nous concevons plutôt le protocole suivant, qui permet d’évaluer la plupart des vérifications sur des données déjà répliquées, avec la coopération des clients de Zanzibar :
- A Zanzibar client requests an opaque consistency token called a zookie for each content version, via a content-change ACL check (§2.4.4) when the content modification is about to be saved. Zanzibar encodes a current global timestamp in the zookie and ensures that all prior ACL writes have lower timestamps. The client stores the zookie with the content change in an atomic write to the client storage. Note that the content-change check does not need to be evaluated in the same transaction as the application content modification, but only has to be triggered when the user modifies the contents.
- The client sends this zookie in subsequent ACL check requests to ensure that the check snapshot is at least as fresh as the timestamp for the content version.
- Un client de Zanzibar demande un jeton de cohérence opaque appelé zookie pour chaque version de contenu, au moyen d’une vérification d’ACL de modification de contenu (§2.4.4) lorsque la modification du contenu est sur le point d’être enregistrée. Zanzibar encode un horodatage global courant dans le zookie et garantit que toutes les écritures d’ACL antérieures ont des horodatages inférieurs. Le client stocke le zookie avec la modification du contenu, au moyen d’une écriture atomique dans le stockage du client. Notons que la vérification de modification de contenu n’a pas besoin d’être évaluée dans la même transaction que la modification du contenu de l’application, mais doit seulement être déclenchée lorsque l’utilisateur modifie le contenu.
- Le client envoie ce zookie dans les requêtes de vérification d’ACL ultérieures afin de garantir que l’instantané de la vérification est au moins aussi frais que l’horodatage de la version du contenu.
External consistency and snapshot reads with staleness bounded by zookie prevent the “new enemy” problem. In Example A, ACL updates A1 and A2 will be assigned timestamps , respectively. Bob will not be able to see the new documents added by Charlie: if a check is evaluated at , the document ACLs will not include the folder ACL; if a check is evaluated at , the check will observe update A1, which removed Bob from the folder ACL. In Example B, Bob will not see the new contents added to the document. For Bob to see the new contents, the check must be evaluated with a zookie , the timestamp assigned to the content update. Because , such a check will also observe the ACL update B1, which removed Bob from the ACL.
La cohérence externe et les lectures d’instantané dont l’obsolescence est bornée par le zookie préviennent le problème du « nouvel ennemi ». Dans l’exemple A, les mises à jour d’ACL A1 et A2 se verront attribuer respectivement les horodatages . Bob ne pourra pas voir les nouveaux documents ajoutés par Charlie : si une vérification est évaluée à , les ACL des documents n’incluront pas l’ACL du dossier ; si une vérification est évaluée à , la vérification observera la mise à jour A1, qui a retiré Bob de l’ACL du dossier. Dans l’exemple B, Bob ne verra pas le nouveau contenu ajouté au document. Pour que Bob voie le nouveau contenu, la vérification doit être évaluée avec un zookie , l’horodatage attribué à la mise à jour du contenu. Comme , une telle vérification observera également la mise à jour d’ACL B1, qui a retiré Bob de l’ACL.
The zookie protocol is a key feature of Zanzibar’s consistency model. It ensures that Zanzibar respects causal ordering between ACL and content updates, but otherwise grants Zanzibar freedom to choose evaluation timestamps so as to meet its latency and availability goals. The freedom arises from the protocol’s at-least-as-fresh semantics, which allow Zanzibar to choose any timestamp fresher than the one encoded in a zookie. Such freedom in turn allows Zanzibar to serve most checks at a default staleness with already replicated data (§3.2.1) and to quantize evaluation timestamps to avoid hot spots (§3.2.5).
Le protocole zookie est une caractéristique clé du modèle de cohérence de Zanzibar. Il garantit que Zanzibar respecte l’ordre causal entre les mises à jour d’ACL et de contenu, mais laisse par ailleurs à Zanzibar la liberté de choisir les horodatages d’évaluation de manière à atteindre ses objectifs de latence et de disponibilité. Cette liberté découle de la sémantique « au moins aussi frais » du protocole, qui permet à Zanzibar de choisir n’importe quel horodatage plus frais que celui encodé dans un zookie. Cette liberté permet à son tour à Zanzibar de servir la plupart des vérifications avec une obsolescence par défaut sur des données déjà répliquées (§3.2.1) et de quantifier les horodatages d’évaluation pour éviter les points chauds (§3.2.5).
Before clients can store relation tuples in Zanzibar, they must configure their namespaces. A namespace configuration specifies its relations as well as its storage parameters. Each relation has a name, which is a client-defined string such as viewer or editor, and a relation config. Storage parameters include sharding settings and an encoding for object IDs that helps Zanzibar optimize storage of integer, string, and other object ID formats.
Avant que les clients puissent stocker des tuples de relation dans Zanzibar, ils doivent configurer leurs espaces de noms. Une configuration d’espace de noms spécifie ses relations ainsi que ses paramètres de stockage. Chaque relation possède un nom, qui est une chaîne définie par le client, telle que viewer ou editor, et une configuration de relation. Les paramètres de stockage comprennent les réglages de fragmentation (sharding) et un encodage des identifiants d’objets qui aide Zanzibar à optimiser le stockage des identifiants d’objets aux formats entier, chaîne et autres.
2.3.1Relation Configs and Userset Rewrites
2.3.1Configurations de relations et réécritures de userset
While relation tuples reflect relationships between objects and users, they do not completely define the effective ACLs. For example, some clients specify that users with editor permissions on each object should have viewer permission on the same object. While such relationships between relations can be represented by a relation tuple per object, storing a tuple for each object in a namespace would be wasteful and make it hard to make modifications across all objects. Instead, we let clients define object-agnostic relationships via userset rewrite rules in relation configs. Figure 1 demonstrates a simple namespace configuration with concentric relations, where viewer contains editor, and editor contains owner.
Bien que les tuples de relation reflètent les relations entre objets et utilisateurs, ils ne définissent pas complètement les ACL effectives. Par exemple, certains clients spécifient que les utilisateurs disposant de permissions editor sur chaque objet doivent avoir la permission viewer sur ce même objet. Bien que de telles relations entre relations puissent être représentées par un tuple de relation par objet, stocker un tuple pour chaque objet d’un espace de noms serait source de gaspillage et rendrait difficiles les modifications portant sur l’ensemble des objets. À la place, nous permettons aux clients de définir des relations indépendantes des objets au moyen de règles de réécriture de userset dans les configurations de relations. La figure 1 présente une configuration d’espace de noms simple avec des relations concentriques, où viewer contient editor, et editor contient owner.
Figure 1: Simple namespace configuration with concentric relations on documents. All owners are editors, and all editors are viewers. Further, viewers of the parent folder are also viewers of the document.
Figure 1 : Configuration d’espace de noms simple avec des relations concentriques sur des documents. Tous les propriétaires sont des éditeurs, et tous les éditeurs sont des lecteurs. En outre, les lecteurs du dossier parent sont également lecteurs du document.
Userset rewrite rules are defined per relation in a namespace. Each rule specifies a function that takes an object ID as input and outputs a userset expression tree. Each leaf node of the tree can be any of the following:
Les règles de réécriture de userset sont définies par relation dans un espace de noms. Chaque règle spécifie une fonction qui prend en entrée un identifiant d’objet et produit en sortie un arbre d’expression de userset. Chaque nœud feuille de l’arbre peut être l’un des éléments suivants :
_this: Returns all users from stored relation tuples for the ⟨object#relation⟩ pair, including indirect ACLs referenced by usersets from the tuples. This is the default behavior when no rewrite rule is specified.computed_userset: Computes, for the input object, a new userset. For example, this allows the userset expression for aviewerrelation to refer to theeditoruserset on the same object, thus offering an ACL inheritance capability between relations.tuple_to_userset: Computes a tupleset (§2.4.1) from the input object, fetches relation tuples matching the tupleset, and computes a userset from every fetched relation tuple. This flexible primitive allows our clients to express complex policies such as “look up the parent folder of the document and inherit its viewers”.
_this: renvoie tous les utilisateurs issus des tuples de relation stockés pour la paire ⟨object#relation⟩, y compris les ACL indirectes référencées par des usersets issus de ces tuples. C’est le comportement par défaut lorsqu’aucune règle de réécriture n’est spécifiée.computed_userset: calcule, pour l’objet en entrée, un nouveau userset. Par exemple, cela permet à l’expression de userset d’une relationviewerde faire référence au userseteditordu même objet, offrant ainsi une capacité d’héritage d’ACL entre relations.tuple_to_userset: calcule un ensemble de tuples (§2.4.1) à partir de l’objet en entrée, récupère les tuples de relation correspondant à cet ensemble de tuples et calcule un userset à partir de chaque tuple de relation récupéré. Cette primitive flexible permet à nos clients d’exprimer des politiques complexes telles que « rechercher le dossier parent du document et hériter de ses lecteurs ».
A userset expression can also be composed of multiple sub-expressions, combined by operations such as union, intersection, and exclusion.
Une expression de userset peut également être composée de plusieurs sous-expressions, combinées par des opérations telles que l’union, l’intersection et l’exclusion.
In addition to supporting ACL checks, Zanzibar also provides APIs for clients to read and write relation tuples, watch tuple updates, and inspect the effective ACLs.
En plus de prendre en charge les vérifications d’ACL, Zanzibar fournit également des API permettant aux clients de lire et d’écrire des tuples de relation, de surveiller les mises à jour de tuples et d’inspecter les ACL effectives.
A concept used throughout these API methods is that of a zookie. A zookie is an opaque byte sequence encoding a globally meaningful timestamp that reflects an ACL write, a client content version, or a read snapshot. Zookies in ACL read and check requests specify staleness bounds for snapshot reads, thus providing one of Zanzibar’s core consistency properties. We choose to use an opaque cookie instead of the actual timestamp to discourage our clients from choosing arbitrary timestamps and to allow future extensions.
Un concept utilisé dans l’ensemble de ces méthodes d’API est celui de zookie. Un zookie est une séquence d’octets opaque encodant un horodatage ayant un sens global, qui reflète une écriture d’ACL, une version de contenu d’un client ou un instantané de lecture. Les zookies présents dans les requêtes de lecture et de vérification d’ACL spécifient des bornes d’obsolescence pour les lectures d’instantané, fournissant ainsi l’une des propriétés de cohérence fondamentales de Zanzibar. Nous choisissons d’utiliser un cookie opaque plutôt que l’horodatage réel afin de dissuader nos clients de choisir des horodatages arbitraires et de permettre des extensions futures.
Our clients read relation tuples to display ACLs or group membership to users, or to prepare for a subsequent write. A read request specifies one or multiple tuplesets and an optional zookie.
Nos clients lisent les tuples de relation pour afficher aux utilisateurs des ACL ou des appartenances à des groupes, ou pour préparer une écriture ultérieure. Une requête de lecture spécifie un ou plusieurs ensembles de tuples (tuplesets) et un zookie facultatif.
Each tupleset specifies keys of a set of relation tuples. The set can include a single tuple key, or all tuples with a given object ID or userset in a namespace, optionally constrained by a relation name. With the tuplesets, clients can look up a specific membership entry, read all entries in an ACL or group, or look up all groups with a given user as a direct member. All tuplesets in a read request are processed at a single snapshot.
Chaque ensemble de tuples spécifie les clés d’un ensemble de tuples de relation. L’ensemble peut comprendre une seule clé de tuple, ou tous les tuples ayant un identifiant d’objet ou un userset donné dans un espace de noms, éventuellement restreints par un nom de relation. Grâce aux ensembles de tuples, les clients peuvent rechercher une entrée d’appartenance précise, lire toutes les entrées d’une ACL ou d’un groupe, ou rechercher tous les groupes dont un utilisateur donné est membre direct. Tous les ensembles de tuples d’une requête de lecture sont traités sur un seul instantané.
With the zookie, clients can request a read snapshot no earlier than a previous write if the zookie from the write response is given in the read request, or at the same snapshot as a previous read if the zookie from the earlier read response is given in the subsequent request. If the request doesn’t contain a zookie, Zanzibar will choose a reasonably recent snapshot, possibly offering a lower-latency response than if a zookie were provided.
Grâce au zookie, les clients peuvent demander un instantané de lecture qui n’est pas antérieur à une écriture précédente, si le zookie de la réponse d’écriture est fourni dans la requête de lecture, ou le même instantané qu’une lecture précédente, si le zookie de la réponse de lecture antérieure est fourni dans la requête suivante. Si la requête ne contient pas de zookie, Zanzibar choisit un instantané raisonnablement récent, offrant éventuellement une réponse de plus faible latence que si un zookie avait été fourni.
Read results only depend on contents of relation tuples and do not reflect userset rewrite rules. For example, even if the viewer userset always includes the owner userset, reading tuples with the viewer relation will not return tuples with the owner relation. Clients that need to understand the effective userset can use the Expand API (§2.4.5).
Les résultats de lecture dépendent uniquement du contenu des tuples de relation et ne reflètent pas les règles de réécriture de userset. Par exemple, même si le userset viewer inclut toujours le userset owner, la lecture des tuples ayant la relation viewer ne renverra pas les tuples ayant la relation owner. Les clients qui ont besoin de connaître le userset effectif peuvent utiliser l’API Expand (§2.4.5).
Clients may modify a single relation tuple to add or remove an ACL. They may also modify all tuples related to an object via a read-modify-write process with optimistic concurrency control [21] that uses a read RPC followed by a write RPC:
Les clients peuvent modifier un seul tuple de relation pour ajouter ou supprimer une ACL. Ils peuvent aussi modifier tous les tuples liés à un objet au moyen d’un processus lecture-modification-écriture avec contrôle de concurrence optimiste [21], qui utilise un RPC de lecture suivi d’un RPC d’écriture :
- Read all relation tuples of an object, including a per-object “lock” tuple.
- Generate the tuples to write or delete. Send the writes, along with a touch on the lock tuple, to Zanzibar, with the condition that the writes will be committed only if the lock tuple has not been modified since the read.
- If the write condition is not met, go back to step 1.
- Lire tous les tuples de relation d’un objet, y compris un tuple « verrou » propre à l’objet.
- Générer les tuples à écrire ou à supprimer. Envoyer les écritures à Zanzibar, accompagnées d’une mise à jour (touch) du tuple verrou, à la condition que les écritures ne soient validées que si le tuple verrou n’a pas été modifié depuis la lecture.
- Si la condition d’écriture n’est pas remplie, revenir à l’étape 1.
The lock tuple is just a regular relation tuple used by clients to detect write races.
Le tuple verrou est simplement un tuple de relation ordinaire utilisé par les clients pour détecter les situations de concurrence en écriture.
Some clients maintain secondary indices of relation tuples in Zanzibar. They can do so with our Watch API. A watch request specifies one or more namespaces and a zookie representing the time to start watching. A watch response contains all tuple modification events in ascending timestamp order, from the requested start timestamp to a timestamp encoded in a heartbeat zookie included in the watch response. The client can use the heartbeat zookie to resume watching where the previous watch response left off.
Certains clients maintiennent des index secondaires des tuples de relation de Zanzibar. Ils peuvent le faire grâce à notre API Watch. Une requête Watch spécifie un ou plusieurs espaces de noms et un zookie représentant l’instant à partir duquel commencer la surveillance. Une réponse Watch contient tous les événements de modification de tuples, par ordre croissant d’horodatage, depuis l’horodatage de début demandé jusqu’à un horodatage encodé dans un zookie de pulsation (heartbeat zookie) inclus dans la réponse Watch. Le client peut utiliser le zookie de pulsation pour reprendre la surveillance là où la réponse Watch précédente s’était arrêtée.
A check request specifies a userset, represented by ⟨object#relation⟩, a putative user, often represented by an authentication token, and a zookie corresponding to the desired object version. Like reads, a check is always evaluated at a consistent snapshot no earlier than the given zookie.
Une requête de vérification spécifie un userset, représenté par ⟨object#relation⟩, un utilisateur présumé, souvent représenté par un jeton d’authentification, et un zookie correspondant à la version souhaitée de l’objet. Comme les lectures, une vérification est toujours évaluée sur un instantané cohérent qui n’est pas antérieur au zookie fourni.
To authorize application content modifications, our clients send a special type of check request, a content-change check. A content-change check request does not carry a zookie and is evaluated at the latest snapshot. If a content change is authorized, the check response includes a zookie for clients to store along with object contents and use for subsequent checks of the content version. The zookie encodes the evaluation snapshot and captures any possible causality from ACL changes to content changes, because the zookie’s timestamp will be greater than that of the ACL updates that protect the new content (§2.2).
Pour autoriser les modifications du contenu des applications, nos clients envoient un type particulier de requête de vérification, une vérification de modification de contenu. Une requête de vérification de modification de contenu ne contient pas de zookie et est évaluée sur le dernier instantané. Si une modification de contenu est autorisée, la réponse à la vérification comprend un zookie que les clients stockent avec le contenu de l’objet et utilisent pour les vérifications ultérieures de cette version du contenu. Le zookie encode l’instantané d’évaluation et capture toute causalité possible des modifications d’ACL vers les modifications de contenu, car l’horodatage du zookie sera supérieur à celui des mises à jour d’ACL qui protègent le nouveau contenu (§2.2).
The Expand API returns the effective userset given an ⟨object#relation⟩ pair and an optional zookie. Unlike the Read API, Expand follows indirect references expressed through userset rewrite rules. The result is represented by a userset tree whose leaf nodes are user IDs or usersets pointing to other ⟨object#relation⟩ pairs, and intermediate nodes represent union, intersection, or exclusion operators. Expand is crucial for our clients to reason about the complete set of users and groups that have access to their objects, which allows them to build efficient search indices for access-controlled content.
L’API Expand renvoie le userset effectif pour une paire ⟨object#relation⟩ et un zookie facultatif donnés. Contrairement à l’API Read, Expand suit les références indirectes exprimées par les règles de réécriture de userset. Le résultat est représenté par un arbre de userset dont les nœuds feuilles sont des identifiants d’utilisateurs ou des usersets pointant vers d’autres paires ⟨object#relation⟩, et dont les nœuds intermédiaires représentent des opérateurs d’union, d’intersection ou d’exclusion. Expand est essentiel pour permettre à nos clients de raisonner sur l’ensemble complet des utilisateurs et des groupes qui ont accès à leurs objets, ce qui leur permet de construire des index de recherche efficaces pour du contenu soumis au contrôle d’accès.
Figure 2 shows the architecture of the Zanzibar system. aclservers are the main server type. They are organized in clusters and respond to Check, Read, Expand, and Write requests. Requests arrive at any server in a cluster and that server fans out the work to other servers in the cluster as necessary. Those servers may in turn contact other servers to compute intermediate results. The initial server gathers the final result and returns it to the client.
La figure 2 présente l’architecture du système Zanzibar. Les aclservers constituent le principal type de serveur. Ils sont organisés en clusters et répondent aux requêtes Check, Read, Expand et Write. Les requêtes arrivent sur n’importe quel serveur d’un cluster, et ce serveur répartit le travail sur d’autres serveurs du cluster si nécessaire. Ces serveurs peuvent à leur tour contacter d’autres serveurs pour calculer des résultats intermédiaires. Le serveur initial rassemble le résultat final et le renvoie au client.
Zanzibar stores ACLs and their metadata in Spanner databases. There is one database to store relation tuples for each client namespace, one database to hold all namespace configurations, and one changelog database shared across all namespaces. aclservers read and write those databases in the course of responding to client requests.
Zanzibar stocke les ACL et leurs métadonnées dans des bases de données Spanner. Il existe une base de données stockant les tuples de relation pour chaque espace de noms client, une base de données contenant toutes les configurations d’espaces de noms, et une base de données de journal des modifications partagée par tous les espaces de noms. Les aclservers lisent et écrivent dans ces bases de données lorsqu’ils répondent aux requêtes des clients.
watchservers are a specialized server type that respond to Watch requests. They tail the changelog and serve a stream of namespace changes to clients in near real time.
Les watchservers sont un type de serveur spécialisé qui répond aux requêtes Watch. Ils suivent en continu le journal des modifications et fournissent aux clients un flux des modifications des espaces de noms en quasi-temps réel.
Zanzibar periodically runs a data processing pipeline to perform a variety of offline functions across all Zanzibar data in Spanner. One such function is to produce dumps of the relation tuples in each namespace at a known snapshot timestamp. Another is to garbage-collect tuple versions older than a threshold configured per namespace.
Zanzibar exécute périodiquement un pipeline de traitement de données pour réaliser diverses fonctions hors ligne sur l’ensemble des données de Zanzibar dans Spanner. L’une de ces fonctions consiste à produire des vidages (dumps) des tuples de relation de chaque espace de noms à un horodatage d’instantané connu. Une autre consiste à éliminer par ramasse-miettes les versions de tuples plus anciennes qu’un seuil configuré par espace de noms.
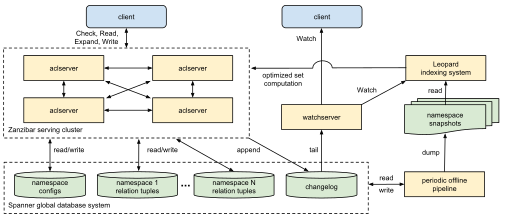
Figure 2: Zanzibar architecture. Arrows indicate the direction of data flow.
Figure 2 : Architecture de Zanzibar. Les flèches indiquent le sens du flux de données.
Leopard is an indexing system used to optimize operations on large and deeply nested sets. It reads periodic snapshots of ACL data and watches for changes between snapshots. It performs transformations on that data, such as denormalization, and responds to requests from aclservers.
Leopard est un système d’indexation utilisé pour optimiser les opérations sur des ensembles volumineux et profondément imbriqués. Il lit des instantanés périodiques des données d’ACL et surveille les modifications entre les instantanés. Il effectue des transformations sur ces données, telles que la dénormalisation, et répond aux requêtes des aclservers.
The rest of this section presents the implementation of these architectural elements in more detail.
Le reste de cette section présente plus en détail l’implémentation de ces éléments architecturaux.
We store relation tuples of each namespace in a separate database, where each row is identified by primary key (shard ID, object ID, relation, user, commit timestamp). Multiple tuple versions are stored on different rows, so that we can evaluate checks and reads at any timestamp within the garbage collection window. The ordering of primary keys allows us to look up all relation tuples for a given object ID or (object ID, relation) pair.
Nous stockons les tuples de relation de chaque espace de noms dans une base de données distincte, où chaque ligne est identifiée par la clé primaire (identifiant de fragment, identifiant d’objet, relation, utilisateur, horodatage de validation). Plusieurs versions d’un tuple sont stockées sur des lignes différentes, de sorte que nous pouvons évaluer les vérifications et les lectures à n’importe quel horodatage compris dans la fenêtre de ramasse-miettes. L’ordre des clés primaires nous permet de rechercher tous les tuples de relation pour un identifiant d’objet ou une paire (identifiant d’objet, relation) donnés.
Our clients configure sharding of a namespace according to its data pattern. Usually the shard ID is determined solely by the object ID. In some cases, for example, when a namespace stores groups with very large numbers of members, the shard ID is computed from both object ID and user.
Nos clients configurent la fragmentation (sharding) d’un espace de noms en fonction de la structure de ses données. Habituellement, l’identifiant de fragment est déterminé uniquement par l’identifiant d’objet. Dans certains cas, par exemple lorsqu’un espace de noms stocke des groupes ayant un très grand nombre de membres, l’identifiant de fragment est calculé à partir de l’identifiant d’objet et de l’utilisateur.
Zanzibar also maintains a changelog database that stores a history of tuple updates for the Watch API. The primary keys are (changelog shard ID, timestamp, unique update ID), where a changelog shard is randomly selected for each write.
Zanzibar maintient également une base de données de journal des modifications qui stocke un historique des mises à jour de tuples pour l’API Watch. Les clés primaires sont (identifiant de fragment du journal des modifications, horodatage, identifiant unique de mise à jour), où un fragment du journal des modifications est sélectionné aléatoirement pour chaque écriture.
Every Zanzibar write is committed to both the tuple storage and the changelog shard in a single transaction. We designate the Spanner server hosting the changelog shard as the transaction coordinator to minimize blocking of changelog reads on pending transactions.
Chaque écriture Zanzibar est validée à la fois dans le stockage des tuples et dans le fragment du journal des modifications, au sein d’une seule transaction. Nous désignons le serveur Spanner hébergeant le fragment du journal des modifications comme coordinateur de la transaction, afin de minimiser le blocage des lectures du journal des modifications par les transactions en attente.
Namespace configs are stored in a database with two tables. One table contains the configs and is keyed by namespace IDs. The other is a changelog of config updates and is keyed by commit timestamps. This structure allows a Zanzibar server to load all configs upon startup and monitor the changelog to refresh configs continuously.
Les configurations d’espaces de noms sont stockées dans une base de données comportant deux tables. L’une contient les configurations et a pour clé les identifiants d’espaces de noms. L’autre est un journal des modifications des configurations et a pour clé les horodatages de validation. Cette structure permet à un serveur Zanzibar de charger toutes les configurations au démarrage et de surveiller le journal des modifications pour actualiser les configurations en continu.
To reduce latency, Zanzibar data is replicated to be close to our clients. Replicas exist in dozens of locations around the world, with multiple replicas per region. The 5 voting replicas are in eastern and central United States, in 3 different metropolitan areas to isolate failures but within 25 milliseconds of each other so that Paxos transactions commit quickly.
Pour réduire la latence, les données de Zanzibar sont répliquées afin d’être proches de nos clients. Des répliques existent dans des dizaines d’emplacements à travers le monde, avec plusieurs répliques par région. Les 5 répliques votantes se trouvent dans l’est et le centre des États-Unis, dans 3 zones métropolitaines différentes afin d’isoler les pannes, mais à moins de 25 millisecondes les unes des autres afin que les transactions Paxos soient validées rapidement.
As noted in §2.4, clients can provide zookies to ensure a minimum snapshot timestamp for request evaluation. When a zookie is not provided, the server uses a default staleness chosen to ensure that all transactions are evaluated at a timestamp that is as recent as possible without impacting latency.
Comme indiqué au §2.4, les clients peuvent fournir des zookies pour garantir un horodatage d’instantané minimal pour l’évaluation des requêtes. Lorsqu’aucun zookie n’est fourni, le serveur utilise une obsolescence par défaut choisie pour garantir que toutes les transactions sont évaluées à un horodatage aussi récent que possible sans affecter la latence.
On each read request it makes to Spanner, Zanzibar receives a hint about whether or not the data at that timestamp required an out-of-zone read and thus incurred additional latency. Each server tracks the frequency of such out-of-zone reads for data at a default staleness as well as for fresher and staler data, and uses these frequencies to compute a binomial proportion confidence interval of the probability that any given piece of data is available locally at each staleness.
Pour chaque requête de lecture qu’il adresse à Spanner, Zanzibar reçoit une indication précisant si les données à cet horodatage ont nécessité ou non une lecture hors zone et ont donc entraîné une latence supplémentaire. Chaque serveur suit la fréquence de ces lectures hors zone pour des données à l’obsolescence par défaut ainsi que pour des données plus fraîches et plus obsolètes, et utilise ces fréquences pour calculer un intervalle de confiance de proportion binomiale de la probabilité qu’une donnée quelconque soit disponible localement pour chaque niveau d’obsolescence.
Upon collecting enough data, the server checks to see if each staleness value has a sufficiently low probability of incurring an out-of-zone read, and thus will be low-latency. If so, it updates the default staleness bound to the lowest “safe” value. If no known staleness values are safe, we use a two-proportion z-test to see if increasing the default will be a statistically significant amount safer. In that case, we increase the default value in the hopes of improving latency. This default staleness mechanism is purely a performance optimization. It does not violate consistency semantics because Zanzibar always respects zookies when provided.
Après avoir collecté suffisamment de données, le serveur vérifie si chaque valeur d’obsolescence présente une probabilité suffisamment faible d’entraîner une lecture hors zone, et donc de garantir une faible latence. Si c’est le cas, il met à jour la borne d’obsolescence par défaut avec la plus petite valeur « sûre ». Si aucune valeur d’obsolescence connue n’est sûre, nous utilisons un test z de comparaison de deux proportions pour déterminer si l’augmentation de la valeur par défaut serait plus sûre de manière statistiquement significative. Dans ce cas, nous augmentons la valeur par défaut dans l’espoir d’améliorer la latence. Ce mécanisme d’obsolescence par défaut est purement une optimisation des performances. Il ne viole pas la sémantique de cohérence, car Zanzibar respecte toujours les zookies lorsqu’ils sont fournis.
Because changes to namespace configs can change the results of ACL evaluations, and therefore their correctness, Zanzibar chooses a single snapshot timestamp for config metadata when evaluating each client request. All aclservers in a cluster use that same timestamp for the same request, including for any subrequests that fan out from the original client request.
Comme les modifications des configurations d’espaces de noms peuvent changer les résultats des évaluations d’ACL, et donc leur exactitude, Zanzibar choisit un unique horodatage d’instantané pour les métadonnées de configuration lors de l’évaluation de chaque requête client. Tous les aclservers d’un cluster utilisent ce même horodatage pour une même requête, y compris pour toutes les sous-requêtes issues de la requête client d’origine.
Each server independently loads namespace configs from storage continuously as they change (§3.1.3). Therefore, each server in a cluster may have access to a different range of config timestamps due to restarts or network latency. Zanzibar must pick a timestamp that is available across all of them. To facilitate this, a monitoring job tracks the timestamp range available to every server and aggregates them, reporting a globally available range to every other server. On each incoming request the server picks a time from this range, ensuring that all servers can continue serving even if they are no longer able to read from the config storage.
Chaque serveur charge indépendamment et en continu les configurations d’espaces de noms depuis le stockage, au fur et à mesure de leurs modifications (§3.1.3). Par conséquent, chaque serveur d’un cluster peut avoir accès à une plage différente d’horodatages de configuration, en raison de redémarrages ou de la latence du réseau. Zanzibar doit choisir un horodatage disponible sur l’ensemble d’entre eux. Pour faciliter cela, une tâche de surveillance suit la plage d’horodatages disponible sur chaque serveur et les agrège, en communiquant à chacun des autres serveurs une plage disponible globalement. Pour chaque requête entrante, le serveur choisit un instant dans cette plage, garantissant ainsi que tous les serveurs peuvent continuer à servir même s’ils ne sont plus en mesure de lire le stockage des configurations.
Zanzibar evaluates ACL checks by converting check requests to boolean expressions. In a simple case, when there are no userset rewrite rules, checking a user against a userset ⟨object#relation⟩ can be expressed as
Zanzibar évalue les vérifications d’ACL en convertissant les requêtes de vérification en expressions booléennes. Dans un cas simple, lorsqu’il n’y a pas de règles de réécriture de userset, la vérification d’un utilisateur par rapport à un userset ⟨object#relation⟩ peut s’exprimer comme suit
Finding a valid involves evaluating membership on all indirect ACLs or groups, recursively. This kind of “pointer chasing” works well for most types of ACLs and groups, but can be expensive when indirect ACLs or groups are deep or wide. §3.2.4 explains how we handle this problem. Userset rewrite rules are also translated to boolean expressions as part of check evaluation.
Trouver un valide implique d’évaluer récursivement l’appartenance sur l’ensemble des ACL ou groupes indirects. Ce type de « poursuite de pointeurs » fonctionne bien pour la plupart des types d’ACL et de groupes, mais peut s’avérer coûteux lorsque les ACL ou groupes indirects sont profonds ou larges. Le §3.2.4 explique comment nous traitons ce problème. Les règles de réécriture de userset sont également traduites en expressions booléennes dans le cadre de l’évaluation des vérifications.
To minimize check latency, we evaluate all leaf nodes of the boolean expression tree concurrently. When the outcome of one node determines the result of a subtree, evaluation of other nodes in the subtree is cancelled.
Pour minimiser la latence des vérifications, nous évaluons simultanément tous les nœuds feuilles de l’arbre d’expression booléenne. Lorsque le résultat d’un nœud détermine le résultat d’un sous-arbre, l’évaluation des autres nœuds de ce sous-arbre est annulée.
Evaluation of leaf nodes usually involves reading relation tuples from databases. We apply a pooling mechanism to group reads for the same ACL check to minimize the number of read RPCs to Spanner.
L’évaluation des nœuds feuilles implique généralement la lecture de tuples de relation dans des bases de données. Nous appliquons un mécanisme de regroupement (pooling) des lectures d’une même vérification d’ACL afin de minimiser le nombre de RPC de lecture adressés à Spanner.
Recursive pointer chasing during check evaluation has difficulty maintaining low latency with groups that are deeply nested or have a large number of child groups. For selected namespaces that exhibit such structure, Zanzibar handles checks using Leopard, a specialized index that supports efficient set computation.
La poursuite récursive de pointeurs lors de l’évaluation des vérifications peine à maintenir une faible latence avec des groupes profondément imbriqués ou comportant un grand nombre de groupes enfants. Pour certains espaces de noms présentant une telle structure, Zanzibar traite les vérifications à l’aide de Leopard, un index spécialisé qui prend en charge un calcul ensembliste efficace.
A Leopard index represents a collection of named sets using tuples, where is an enum representing the set type and and are 64-bit integers representing the set ID and the element ID, respectively. A query evaluates an expression of union, intersection, or exclusion of named sets and returns the result set ordered by the element ID up to a specified number of results.
Un index Leopard représente une collection d’ensembles nommés à l’aide de tuples , où est une énumération représentant le type d’ensemble, et et sont des entiers de 64 bits représentant respectivement l’identifiant de l’ensemble et l’identifiant de l’élément. Une requête évalue une expression d’union, d’intersection ou d’exclusion d’ensembles nommés et renvoie l’ensemble résultat, trié par identifiant d’élément, dans la limite d’un nombre de résultats spécifié.
To index and evaluate group membership, Zanzibar represents group membership with two set types, and , which we show here as functions mapping from a set ID to element IDs:
Pour indexer et évaluer l’appartenance aux groupes, Zanzibar représente l’appartenance aux groupes au moyen de deux types d’ensembles, et , que nous présentons ici comme des fonctions associant un identifiant d’ensemble à des identifiants d’éléments :
- , where represents an ancestor group and represents a descendent group that is directly or indirectly a sub-group of the ancestor group.
- , where represents an individual user and represents a parent group in which the user is a direct member.
- , où représente un groupe ancêtre et représente un groupe descendant qui est, directement ou indirectement, un sous-groupe du groupe ancêtre.
- , où représente un utilisateur individuel et représente un groupe parent dont l’utilisateur est membre direct.
To evaluate whether user is a member of group , we check whether
Pour évaluer si l’utilisateur est membre du groupe , nous vérifions si
Group membership can be considered as a reachability problem in a graph, where nodes represent groups and users and edges represent direct membership. Flattening group-to-group paths allows reachability to be efficently evaluated by Leopard, though other types of denormalization can also be applied as data patterns demand.
L’appartenance aux groupes peut être considérée comme un problème d’accessibilité dans un graphe, où les nœuds représentent des groupes et des utilisateurs, et les arêtes représentent l’appartenance directe. L’aplatissement des chemins de groupe à groupe permet à Leopard d’évaluer efficacement l’accessibilité, bien que d’autres types de dénormalisation puissent également être appliqués selon ce qu’exigent les profils de données.
The Leopard system consists of three discrete parts: a serving system capable of consistent and low-latency operations across sets; an offline, periodic index building system; and an online real-time layer capable of continuously updating the serving system as tuple changes occur.
Le système Leopard se compose de trois parties distinctes : un système de service capable d’effectuer des opérations cohérentes et à faible latence sur des ensembles ; un système de construction d’index périodique et hors ligne ; et une couche en ligne en temps réel capable de mettre à jour en continu le système de service au fur et à mesure que des modifications de tuples se produisent.
Index tuples are stored as ordered lists of integers in a structure such as a skip list, thus allowing for efficient union and intersections among sets. For example, evaluating the intersection between two sets, and , requires only skip-list seeks. The index is sharded by element IDs and can be distributed across multiple servers. Shards are usually served entirely from memory, but they can also be served from a mix of hot and cold data spread between memory and remote solid-state devices.
Les tuples d’index sont stockés sous forme de listes ordonnées d’entiers dans une structure telle qu’une liste à enjambements (skip list), ce qui permet des unions et des intersections efficaces entre ensembles. Par exemple, l’évaluation de l’intersection de deux ensembles et ne nécessite que positionnements dans la liste à enjambements. L’index est fragmenté par identifiant d’élément et peut être distribué sur plusieurs serveurs. Les fragments sont généralement servis entièrement depuis la mémoire, mais ils peuvent également être servis à partir d’un mélange de données chaudes et froides réparties entre la mémoire et des dispositifs de stockage à semi-conducteurs distants.
The offline index builder generates index shards from a snapshot of Zanzibar relation tuples and configs, and replicates the shards globally. It respects userset rewrite rules and recursively expands edges in an ACL graph to form Leopard index tuples. The Leopard servers continously watch for new shards and swap old shards with new ones when they become available.
Le constructeur d’index hors ligne génère des fragments d’index à partir d’un instantané des tuples de relation et des configurations de Zanzibar, et réplique ces fragments à l’échelle mondiale. Il respecte les règles de réécriture de userset et développe récursivement les arêtes d’un graphe d’ACL pour former les tuples d’index Leopard. Les serveurs Leopard surveillent en continu l’apparition de nouveaux fragments et remplacent les anciens fragments par les nouveaux lorsqu’ils deviennent disponibles.
The Leopard system described thus far is able to efficiently evaluate deeply and widely nested group membership, but cannot do so at a fresh and consistent snapshot due to offline index generation and shard swapping. To support consistent ACL evaluation, Leopard servers maintain an incremental layer that indexes all updates since the offline snapshot, where each update is represented by a tuple, where is the timestamp of the update and is a deletion marker. Updates with timestamps less than or equal to the query timestamp are merged on top of the offline index during query processing.
Le système Leopard décrit jusqu’ici est capable d’évaluer efficacement des appartenances à des groupes imbriqués en profondeur et en largeur, mais ne peut pas le faire sur un instantané frais et cohérent, en raison de la génération hors ligne des index et du remplacement des fragments. Pour permettre une évaluation cohérente des ACL, les serveurs Leopard maintiennent une couche incrémentale qui indexe toutes les mises à jour depuis l’instantané hors ligne, chaque mise à jour étant représentée par un tuple , où est l’horodatage de la mise à jour et un marqueur de suppression. Les mises à jour dont l’horodatage est inférieur ou égal à l’horodatage de la requête sont fusionnées par-dessus l’index hors ligne lors du traitement de la requête.
To maintain the incremental layer, the Leopard incremental indexer calls Zanzibar’s Watch API to receive a temporally ordered stream of Zanzibar tuple modifications and transforms the updates into a temporally ordered stream of Leopard tuple additions, updates, and deletions. Generating updates for the tuples requires the incremental indexer to maintain group-to-group membership for denormalizing the effects of a relation tuple update to potentially multiple index updates.
Pour maintenir la couche incrémentale, l’indexeur incrémental de Leopard appelle l’API Watch de Zanzibar afin de recevoir un flux temporellement ordonné des modifications de tuples de Zanzibar, et transforme ces mises à jour en un flux temporellement ordonné d’ajouts, de mises à jour et de suppressions de tuples Leopard. La génération des mises à jour pour les tuples exige que l’indexeur incrémental maintienne l’appartenance de groupe à groupe afin de dénormaliser les effets d’une mise à jour d’un tuple de relation en potentiellement plusieurs mises à jour d’index.
In practice, a single Zanzibar tuple addition or deletion may yield potentially tens of thousands of discrete Leopard tuple events. Each Leopard serving instance receives the complete stream of these Zanzibar tuple changes through the Watch API. The Leopard serving system is designed to continuously ingest this stream and update its various posting lists with minimal impact to query serving.
En pratique, un seul ajout ou une seule suppression de tuple Zanzibar peut potentiellement produire des dizaines de milliers d’événements de tuples Leopard distincts. Chaque instance de service Leopard reçoit le flux complet de ces modifications de tuples Zanzibar via l’API Watch. Le système de service Leopard est conçu pour ingérer ce flux en continu et mettre à jour ses différentes listes d’occurrences (posting lists) avec un impact minimal sur le service des requêtes.
The workload of ACL reads and checks is often bursty and subject to hot spots. For example, answering a search query requires conducting ACL checks for all candidate results, whose ACLs often share common groups or indirect ACLs. To facilitate consistency, Zanzibar avoids storage denormalization and relies only on normalized data (except for the cases described in §3.2.4). With normalized data, hot spots on common ACLs (e.g., popular groups) may overload the underlying database servers. We found the handling of hot spots to be the most critical frontier in our pursuit of low latency and high availability.
La charge de travail des lectures et vérifications d’ACL survient souvent par rafales et est sujette aux points chauds. Par exemple, répondre à une requête de recherche nécessite d’effectuer des vérifications d’ACL pour tous les résultats candidats, dont les ACL partagent souvent des groupes communs ou des ACL indirectes. Pour faciliter la cohérence, Zanzibar évite la dénormalisation du stockage et s’appuie uniquement sur des données normalisées (à l’exception des cas décrits au §3.2.4). Avec des données normalisées, les points chauds sur des ACL communes (p. ex. des groupes populaires) peuvent surcharger les serveurs de bases de données sous-jacents. Nous avons constaté que la gestion des points chauds constituait la frontière la plus critique dans notre recherche d’une faible latence et d’une haute disponibilité.
Zanzibar servers in each cluster form a distributed cache for both reads and check evaluations, including intermediate check results evaluated during pointer chasing. Cache entries are distributed across Zanzibar servers with consistent hashing [20]. To process checks or reads, we fan out requests to the corresponding Zanzibar servers via an internal RPC interface. To minimize the number of internal RPCs, for most namespaces we compute the forwarding key from the object ID, since processing a check on ⟨object#relation⟩ often involves indirect ACL checks on other relations of the same object and reading relation tuples of the object. These checks and reads can be processed by the same server since they share the same forwarding key with the parent check request. To handle hot forwarding keys, we cache results at both the caller and the callee of internal RPCs, effectively forming cache trees. We also use Slicer [12] to help distribute hot keys to multiple servers.
Les serveurs Zanzibar de chaque cluster forment un cache distribué pour les lectures comme pour les évaluations de vérifications, y compris les résultats de vérification intermédiaires évalués lors de la poursuite de pointeurs. Les entrées du cache sont réparties entre les serveurs Zanzibar par hachage cohérent [20]. Pour traiter les vérifications ou les lectures, nous répartissons les requêtes vers les serveurs Zanzibar correspondants via une interface RPC interne. Pour minimiser le nombre de RPC internes, nous calculons, pour la plupart des espaces de noms, la clé de transfert à partir de l’identifiant d’objet, car le traitement d’une vérification sur ⟨object#relation⟩ implique souvent des vérifications d’ACL indirectes sur d’autres relations du même objet et la lecture des tuples de relation de cet objet. Ces vérifications et lectures peuvent être traitées par le même serveur, puisqu’elles partagent la même clé de transfert que la requête de vérification parente. Pour gérer les clés de transfert chaudes, nous mettons en cache les résultats à la fois chez l’appelant et chez l’appelé des RPC internes, formant ainsi de fait des arbres de cache. Nous utilisons également Slicer [12] pour aider à répartir les clés chaudes sur plusieurs serveurs.
We avoid reusing results evaluated from a different snapshot by encoding snapshot timestamps in cache keys. We choose evaluation timestamps rounded up to a coarse granularity, such as one or ten seconds, while respecting staleness constraints from request zookies. This timestamp quantization allows the vast majority of recent checks and reads to be evaluated at the same timestamps and to share cache results, despite having microsecond-resolution timestamps in cache keys. It is worth noting that rounding up timestamps does not affect Zanzibar’s consistency properties, since Spanner ensures that a snapshot read at timestamp will observe all writes up to —this holds even if is in the future, in which case the read will wait until TrueTime has moved past .
Nous évitons de réutiliser des résultats évalués sur un instantané différent en encodant les horodatages d’instantané dans les clés de cache. Nous choisissons des horodatages d’évaluation arrondis vers le haut à une granularité grossière, par exemple une ou dix secondes, tout en respectant les contraintes d’obsolescence imposées par les zookies des requêtes. Cette quantification des horodatages permet à la grande majorité des vérifications et lectures récentes d’être évaluées aux mêmes horodatages et de partager les résultats du cache, bien que les clés de cache contiennent des horodatages à la résolution de la microseconde. Il convient de noter que l’arrondi vers le haut des horodatages n’affecte pas les propriétés de cohérence de Zanzibar, puisque Spanner garantit qu’une lecture d’instantané à l’horodatage observera toutes les écritures jusqu’à — cela reste vrai même si se situe dans le futur, auquel cas la lecture attendra que TrueTime ait dépassé .
To handle the “cache stampede” problem [3], where concurrent requests create flash hot spots before the cache is populated with results, we maintain a lock table on each server to track outstanding reads and checks. Among requests sharing the same cache key only one request will begin processing; the rest block until the cache is populated.
Pour traiter le problème de la ruée sur le cache (cache stampede) [3], dans lequel des requêtes concurrentes créent des points chauds soudains avant que le cache ne soit rempli de résultats, nous maintenons sur chaque serveur une table de verrous afin de suivre les lectures et vérifications en cours. Parmi les requêtes partageant la même clé de cache, une seule commence à être traitée ; les autres restent bloquées jusqu’à ce que le cache soit rempli.
We can effectively handle the vast majority of hot spots with distributed caches and lock tables. Over time we made the following two improvements.
Nous pouvons gérer efficacement la grande majorité des points chauds grâce aux caches distribués et aux tables de verrous. Au fil du temps, nous avons apporté les deux améliorations suivantes.
First, direct membership checks of a user for an object and relation (i.e. ⟨object#relation@user⟩) are usually handled by a single relation tuple lookup. However, occasionally a very popular object invites many concurrent checks for different users, causing a hot spot on the storage server hosting relation tuples for the object. To avoid these hot spots, we read and cache all relation tuples of ⟨object#relation⟩ for the hot object, trading read bandwidth for cacheability. We dynamically detect hot objects to apply this method to by tracking the number of outstanding reads on each object.
Premièrement, les vérifications d’appartenance directe d’un utilisateur pour un objet et une relation (c.-à-d. ⟨object#relation@user⟩) sont généralement traitées par une seule recherche de tuple de relation. Cependant, il arrive qu’un objet très populaire suscite de nombreuses vérifications concurrentes pour différents utilisateurs, provoquant un point chaud sur le serveur de stockage qui héberge les tuples de relation de cet objet. Pour éviter ces points chauds, nous lisons et mettons en cache tous les tuples de relation de ⟨object#relation⟩ pour l’objet chaud, en échangeant de la bande passante de lecture contre une meilleure aptitude à la mise en cache. Nous détectons dynamiquement les objets chauds auxquels appliquer cette méthode en suivant le nombre de lectures en cours sur chaque objet.
Second, indirect ACL checks are frequently cancelled when the result of the parent ACL check is already determined. This leaves the cache key unpopulated. While eager cancellation reduces resource usage significantly, it negatively affects latency of concurrent requests that are blocked by the lock table entry. To prevent this latency impact, we delay eager cancellation when there are waiters on the corresponding lock table entry.
Deuxièmement, les vérifications d’ACL indirectes sont fréquemment annulées lorsque le résultat de la vérification d’ACL parente est déjà déterminé. La clé de cache reste alors non remplie. Si l’annulation anticipée réduit considérablement l’utilisation des ressources, elle nuit à la latence des requêtes concurrentes qui sont bloquées par l’entrée de la table de verrous. Pour éviter cet impact sur la latence, nous retardons l’annulation anticipée lorsque des requêtes sont en attente sur l’entrée correspondante de la table de verrous.
Performance isolation is indispensable for shared services targeting low latency and high availability. If Zanzibar or one of its clients occasionally fails to provision enough resources to handle an unexpected usage pattern, the following isolation mechanisms ensure that performance problems are isolated to the problematic use case and do not adversely affect other clients.
L’isolation des performances est indispensable pour des services partagés visant une faible latence et une haute disponibilité. Si Zanzibar ou l’un de ses clients ne parvient occasionnellement pas à provisionner suffisamment de ressources pour faire face à un profil d’utilisation inattendu, les mécanismes d’isolation suivants garantissent que les problèmes de performance restent circonscrits au cas d’usage problématique et n’affectent pas négativement les autres clients.
First, to ensure proper allocation of CPU capacity, Zanzibar measures the cost of each RPC in terms of generic cpu-seconds, a hardware-agnostic metric. Each client has a global limit on maximum CPU usage per second; its RPCs will be throttled if it exceeds the limit and there is no spare capacity in the overall system.
Premièrement, pour garantir une allocation appropriée de la capacité CPU, Zanzibar mesure le coût de chaque RPC en secondes CPU génériques, une métrique indépendante du matériel. Chaque client dispose d’une limite globale d’utilisation maximale du CPU par seconde ; ses RPC sont bridés s’il dépasse la limite et qu’il n’existe aucune capacité disponible dans l’ensemble du système.
Each Zanzibar server also limits the total number of outstanding RPCs to control its memory usage. Likewise it limits the number of oustanding RPCs per client.
Chaque serveur Zanzibar limite également le nombre total de RPC en cours afin de contrôler son utilisation de la mémoire. De même, il limite le nombre de RPC en cours par client.
Zanzibar further limits the maximum number of concurrent reads per (object, client) and per client on each Spanner server. This ensures that no single object or client can monopolize a Spanner server.
Zanzibar limite en outre le nombre maximal de lectures concurrentes par (objet, client) et par client sur chaque serveur Spanner. Cela garantit qu’aucun objet ni aucun client ne peut monopoliser un serveur Spanner.
Finally, we use different lock table keys for requests from different clients to prevent any throttling that Spanner applies to one client from affecting other clients.
Enfin, nous utilisons des clés de table de verrous différentes pour les requêtes provenant de clients différents, afin d’éviter que le bridage appliqué par Spanner à un client n’affecte les autres clients.
Zanzibar’s distributed processing requires measures to accommodate slow tasks. For calls to Spanner and to the Leopard index we rely on request hedging [16] (i.e. we send the same request to multiple servers, use whichever response comes back first, and cancel the other requests). To reduce round-trip times, we try to place at least two replicas of these backend services in every geographical region where we have Zanzibar servers. To avoid unnecessarily multiplying load, we first send one request and defer sending hedged requests until the initial request is known to be slow.
Le traitement distribué de Zanzibar nécessite des mesures pour s’accommoder des tâches lentes. Pour les appels à Spanner et à l’index Leopard, nous nous appuyons sur les requêtes de couverture (hedging) [16] (c.-à-d. que nous envoyons la même requête à plusieurs serveurs, utilisons la première réponse reçue et annulons les autres requêtes). Pour réduire les temps d’aller-retour, nous essayons de placer au moins deux répliques de ces services backend dans chaque région géographique où nous disposons de serveurs Zanzibar. Pour éviter de multiplier inutilement la charge, nous envoyons d’abord une seule requête et différons l’envoi des requêtes de couverture jusqu’à ce que la requête initiale se révèle lente.
To determine the appropriate hedging delay threshold, each server maintains a delay estimator that dynamically computes an Nth percentile latency based on recent measurements. This mechanism allows us to limit the additional traffic incurred by hedging to a small fraction of total traffic.
Pour déterminer le seuil de délai de couverture approprié, chaque serveur maintient un estimateur de délai qui calcule dynamiquement une latence au N-ième centile à partir de mesures récentes. Ce mécanisme nous permet de limiter le trafic supplémentaire induit par la couverture à une petite fraction du trafic total.
Effective hedging requires the requests to have similar costs. In the case of Zanzibar’s authorization checks, some checks are inherently more time-consuming than others because they require more work. Hedging check requests would result in duplicating the most expensive workloads and, ironically, worsening latency. Therefore we do not hedge requests between Zanzibar servers, but rely on the previously discussed sharding among multiple replicas and on monitoring mechanisms to detect and avoid slow servers.
Une couverture efficace exige que les requêtes aient des coûts similaires. Dans le cas des vérifications d’autorisation de Zanzibar, certaines vérifications prennent intrinsèquement plus de temps que d’autres, car elles nécessitent davantage de travail. Appliquer la couverture aux requêtes de vérification aurait pour effet de dupliquer les charges de travail les plus coûteuses et, paradoxalement, d’aggraver la latence. Par conséquent, nous n’appliquons pas la couverture aux requêtes entre serveurs Zanzibar, mais nous appuyons sur la fragmentation entre plusieurs répliques évoquée précédemment et sur des mécanismes de surveillance pour détecter et éviter les serveurs lents.
Zanzibar has been in production use for more than 5 years. Throughout that time, the number of clients using Zanzibar and the load they place on Zanzibar have grown steadily. This section discusses our experience operating Zanzibar as a globally distributed authorization system.
Zanzibar est utilisé en production depuis plus de 5 ans. Pendant toute cette période, le nombre de clients utilisant Zanzibar et la charge qu’ils font peser sur Zanzibar n’ont cessé de croître. Cette section présente notre expérience de l’exploitation de Zanzibar en tant que système d’autorisation distribué à l’échelle mondiale.
Zanzibar manages more than 1,500 namespaces defined by hundreds of client applications. The size of a namespace configuration file serves as a rough measure of the complexity of the access control policy implemented by that namespace. These configuration files range from tens of lines to thousands of lines, with the median near 500 lines.
Zanzibar gère plus de 1,500 espaces de noms définis par des centaines d’applications clientes. La taille d’un fichier de configuration d’espace de noms constitue une mesure approximative de la complexité de la politique de contrôle d’accès mise en œuvre par cet espace de noms. Ces fichiers de configuration comptent de quelques dizaines à plusieurs milliers de lignes, avec une médiane proche de 500 lignes.
These namespaces contain more than 2 trillion relation tuples that occupy close to 100 terabytes. The number of tuples per namespace ranges over many orders of magnitude, from tens to a trillion, with the median near 15,000. This data is fully replicated in more than 30 locations around the world to maintain both proximity to users and high availability.
Ces espaces de noms contiennent plus de 2 mille milliards de tuples de relation, qui occupent près de 100 téraoctets. Le nombre de tuples par espace de noms s’étend sur de nombreux ordres de grandeur, de quelques dizaines à mille milliards, avec une médiane proche de 15,000. Ces données sont entièrement répliquées dans plus de 30 emplacements à travers le monde afin d’assurer à la fois la proximité avec les utilisateurs et une haute disponibilité.
Zanzibar serves more than 10 million client queries per second (QPS). Over a sample 7-day period in December 2018, Check requests peak at roughly 4.2M QPS, Read at 8.2M, Expand at 760K, and Write at 25K. Queries that read data are thus two orders of magnitude more frequent than those that write data.
Zanzibar sert plus de 10 millions de requêtes clientes par seconde (QPS). Sur une période échantillon de 7 jours en décembre 2018, les requêtes Check culminent à environ 4.2M QPS, Read à 8.2M, Expand à 760K et Write à 25K. Les requêtes qui lisent des données sont donc deux ordres de grandeur plus fréquentes que celles qui écrivent des données.
Zanzibar distributes this load across more than 10,000 servers organized in several dozen clusters around the world. The number of servers per cluster ranges from fewer than 100 to more than 1,000, with the median near 500. Clusters are sized in proportion to load in their geographic regions.
Zanzibar répartit cette charge sur plus de 10,000 serveurs organisés en plusieurs dizaines de clusters à travers le monde. Le nombre de serveurs par cluster va de moins de 100 à plus de 1,000, avec une médiane proche de 500. Les clusters sont dimensionnés proportionnellement à la charge de leurs régions géographiques.
We divide requests into two categories according to the required data freshness, which can have a large impact on latency and availability of the requests. Specifically, Check, Read, and Expand requests carry zookies to specify lower bounds on evaluation timestamps. When a zookie timestamp is higher than that of the most recent data replicated to the region, the storage reads require cross-region round trips to the leader replica to retrieve fresher data. As our storage is configured with replication heartbeats with 8-second intervals, we divide our requests into two categories: Safe requests have zookies more than 10 seconds old and can be served within the region most of time, while Recent requests have zookies less than 10 seconds old and often require inter-region round trips. We report separate statistics for each.
Nous répartissons les requêtes en deux catégories selon la fraîcheur des données requise, qui peut avoir un impact important sur la latence et la disponibilité des requêtes. Plus précisément, les requêtes Check, Read et Expand transportent des zookies afin de spécifier des bornes inférieures pour les horodatages d’évaluation. Lorsque l’horodatage d’un zookie est postérieur à celui des données les plus récentes répliquées dans la région, les lectures dans le stockage nécessitent des allers-retours entre régions vers la réplique leader afin de récupérer des données plus fraîches. Comme notre stockage est configuré avec des pulsations de réplication à intervalles de 8 secondes, nous répartissons nos requêtes en deux catégories : les requêtes Safe ont des zookies datant de plus de 10 secondes et peuvent la plupart du temps être servies au sein de la région, tandis que les requêtes Recent ont des zookies datant de moins de 10 secondes et nécessitent souvent des allers-retours entre régions. Nous présentons des statistiques distinctes pour chacune.
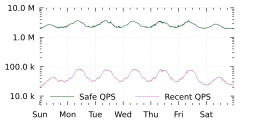
Figure 3: Rate of Check Safe and Check Recent requests over a 7-day period in December 2018.
Figure 3 : Débit des requêtes Check Safe et Check Recent sur une période de 7 jours en décembre 2018.
Figure 3 shows the rate of Check Safe and Check Recent requests over 7 days. Both exhibit a diurnal cycle. The rate of Safe requests is about two orders of magnitude larger than that of Recent requests, which allows Zanzibar to serve the vast majority of ACL checks locally.
La figure 3 présente le débit des requêtes Check Safe et Check Recent sur 7 jours. Les deux présentent un cycle journalier. Le débit des requêtes Safe est supérieur d’environ deux ordres de grandeur à celui des requêtes Recent, ce qui permet à Zanzibar de servir localement la grande majorité des vérifications d’ACL.
Zanzibar’s latency budget is generally a small fraction of the few hundreds of milliseconds of total response time that its clients must provide to be viable interactive services. Consider for example a client that performs authorization checks on multiple documents before it can show the results of a search on those documents.
Le budget de latence de Zanzibar représente généralement une petite fraction des quelques centaines de millisecondes de temps de réponse total que ses clients doivent offrir pour être des services interactifs viables. Considérons par exemple un client qui effectue des vérifications d’autorisation sur plusieurs documents avant de pouvoir afficher les résultats d’une recherche portant sur ces documents.
We measure latency on the server side using live traffic because (1) latency is heavily influenced by our caching and de-duplication mechanisms so that it is only realistically reflected by live traffic, and (2) accurately measuring latency from clients requires well-behaving clients. Provisioning of client jobs is outside of Zanzibar’s control and sometimes client jobs are overloaded.
Nous mesurons la latence côté serveur à partir du trafic réel, car (1) la latence est fortement influencée par nos mécanismes de mise en cache et de déduplication, de sorte qu’elle n’est reflétée de manière réaliste que par le trafic réel, et (2) mesurer précisément la latence depuis les clients nécessite des clients au comportement correct. Le provisionnement des tâches clientes échappe au contrôle de Zanzibar, et ces tâches sont parfois surchargées.
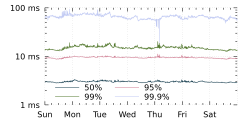
Figure 4: Latency of Check Safe responses at different percentiles over a 7-day period in December 2018.
Figure 4 : Latence des réponses Check Safe à différents centiles sur une période de 7 jours en décembre 2018.
Figure 4 shows the latency of Check Safe responses over 7 days. At the 50th, 95th, 99th, and 99.9th percentiles it peaks at roughly 3, 11, 20, and 93 msec, respectively. This performance meets our latency goals for an operation that is frequently in the critical path of user interactions.
La figure 4 présente la latence des réponses Check Safe sur 7 jours. Aux 50e, 95e, 99e et 99.9e centiles, elle culmine respectivement à environ 3, 11, 20 et 93 msec. Ces performances répondent à nos objectifs de latence pour une opération qui se trouve fréquemment sur le chemin critique des interactions des utilisateurs.
Table 2 summarizes the latency distributions of Check, Read, Expand, and Write responses over the same 7 days. As intended, the more frequently used Safe versions of Check, Read, and Expand are significantly faster than the less frequently used Recent versions. Writes are the least frequently used of all the APIs, and the slowest because they always require distributed coordination among Spanner servers.
Le tableau 2 résume les distributions de latence des réponses Check, Read, Expand et Write sur les mêmes 7 jours. Comme prévu, les versions Safe de Check, Read et Expand, plus fréquemment utilisées, sont nettement plus rapides que les versions Recent, moins fréquemment utilisées. Les écritures sont les moins fréquemment utilisées de toutes les API, et les plus lentes, car elles nécessitent toujours une coordination distribuée entre serveurs Spanner.
Table 2: Mean and standard deviation of RPC response latency over a 7-day period in December 2018.
Tableau 2 : Moyenne et écart type de la latence de réponse des RPC sur une période de 7 jours en décembre 2018.
We define availability as the fraction of “qualified” RPCs the service answers successfully within latency thresholds: 5 seconds for a Safe request, and 15 seconds for a Recent request as leader re-election in Spanner may take up to 10 seconds. For an RPC to be qualified, the request must be well-formed and have a deadline longer than the latency threshold. In addition, the client must stay within its resource quota.
Nous définissons la disponibilité comme la fraction des RPC « qualifiés » auxquels le service répond avec succès dans les seuils de latence : 5 secondes pour une requête Safe et 15 secondes pour une requête Recent, car la réélection du leader dans Spanner peut prendre jusqu’à 10 secondes. Pour qu’un RPC soit qualifié, la requête doit être bien formée et avoir une échéance plus longue que le seuil de latence. En outre, le client doit rester dans les limites de son quota de ressources.
For these reasons, we cannot measure availability directly with live traffic, as our clients sometimes send RPCs with short deadlines or cancel their in-progress RPCs. Instead, we sample a small fraction of valid requests from live traffic and replay them later with our own probers. When replaying the requests, we set the timeout to be longer than the availability threshold. We also adjust the request zookie, if one is specified, so that the relative age of the zookie remains the same as when the request was received in the live traffic. Finally, we run 3 probers per cluster and exclude outliers to eliminate false alarms caused by rare prober failures.
Pour ces raisons, nous ne pouvons pas mesurer la disponibilité directement sur le trafic réel, car nos clients envoient parfois des RPC avec des échéances courtes ou annulent leurs RPC en cours. Nous échantillonnons plutôt une petite fraction des requêtes valides du trafic réel et les rejouons ultérieurement avec nos propres sondes. Lorsque nous rejouons les requêtes, nous fixons un délai d’expiration plus long que le seuil de disponibilité. Nous ajustons également le zookie de la requête, s’il est spécifié, afin que l’âge relatif du zookie reste le même qu’au moment où la requête a été reçue dans le trafic réel. Enfin, nous exécutons 3 sondes par cluster et excluons les valeurs aberrantes afin d’éliminer les fausses alertes causées par de rares défaillances des sondes.
To compute availability, we aggregate success ratios over 90-day windows averaged across clusters. Figure 5 shows Zanzibar’s availability as measured by these probers. Availability has remained above 99.999% over the past 3 years of operation at Google. In other words, for every quarter, Zanzibar has less than 2 minutes of global downtime and fewer than 13 minutes when the global error ratio exceeds 10%.
Pour calculer la disponibilité, nous agrégeons les taux de succès sur des fenêtres de 90 jours, moyennés sur l’ensemble des clusters. La figure 5 présente la disponibilité de Zanzibar telle que mesurée par ces sondes. La disponibilité est restée supérieure à 99.999% au cours des 3 dernières années d’exploitation chez Google. Autrement dit, pour chaque trimestre, Zanzibar connaît moins de 2 minutes d’indisponibilité globale et moins de 13 minutes pendant lesquelles le taux d’erreur global dépasse 10%.
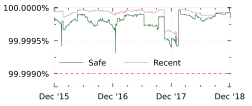
Figure 5: Zanzibar’s availability over the past three years has remained above 99.999%.
Figure 5 : La disponibilité de Zanzibar est restée supérieure à 99.999% au cours des trois dernières années.
Zanzibar servers delegate checks and reads to each other based on consistent hashing, and both the caller and the callee sides of the delegated operations cache the results to prevent hot spots (§3.2.5). At peak, Zanzibar handles 22 million internal “delegated” RPCs per second, split about evenly between reads and checks. In-memory caching handles approximately 200 million lookups per second at peak, 150 million from checks and 50 million from reads. Caching for checks has a 10% hit rate on the delegate’s side, with an additional 12% saved by the lock table. Meanwhile, caching on the delegator’s side has a 2% hit rate with an additional 3% from the lock table. While these hit rates appear low, they prevent 500K internal RPCs per second from creating hot spots.
Les serveurs Zanzibar se délèguent mutuellement des vérifications et des lectures selon un hachage cohérent, et les côtés appelant et appelé des opérations déléguées mettent tous deux en cache les résultats afin d’éviter les points chauds (§3.2.5). En pic, Zanzibar traite 22 millions de RPC internes « délégués » par seconde, répartis à peu près également entre lectures et vérifications. Le cache en mémoire traite environ 200 millions de recherches par seconde en pic, dont 150 millions issues des vérifications et 50 millions issues des lectures. La mise en cache des vérifications présente un taux de succès de 10% du côté du délégué, auquel s’ajoutent 12% épargnés grâce à la table de verrous. Par ailleurs, la mise en cache du côté du délégant présente un taux de succès de 2%, auquel s’ajoutent 3% grâce à la table de verrous. Bien que ces taux de succès paraissent faibles, ils empêchent 500K RPC internes par seconde de créer des points chauds.
Delegated reads see higher hit rates on the delegate’s side—24% on the cache and 9% on the lock table—but the delegator’s cache is hit less than 1% of the time. For super-hot groups, Zanzibar further optimizes by reading and caching the full set of members in advance—this happens for 0.1% of groups but further prevents hot spots.
Les lectures déléguées bénéficient de taux de succès plus élevés du côté du délégué — 24% sur le cache et 9% sur la table de verrous —, mais le cache du délégant est atteint moins de 1% du temps. Pour les groupes extrêmement chauds, Zanzibar optimise davantage en lisant et en mettant en cache à l’avance l’ensemble complet des membres — cela concerne 0.1% des groupes, mais permet d’éviter davantage de points chauds.
This caching, along with aggressive pooling of read requests, allows Zanzibar to issue only 20 million read RPCs per second to Spanner. The median of these requests reads 1.5 rows per RPC, but at the 99th percentile they each read close to 1 thousand rows.
Cette mise en cache, conjuguée à un regroupement agressif des requêtes de lecture, permet à Zanzibar de n’émettre que 20 millions de RPC de lecture par seconde vers Spanner. La médiane de ces requêtes lit 1.5 ligne par RPC, mais au 99e centile, chacune lit près de 1 millier de lignes.
Zanzibar’s Spanner reads take 0.5 msec at the median, and 2 msec at the 95th percentile. We find that 1% of Spanner reads, or 200K reads per second, benefit from hedging. We note that Zanzibar uses an instance of Spanner that runs internally to Google, not an instance of Cloud Spanner [6].
Les lectures Spanner de Zanzibar prennent 0.5 msec en médiane et 2 msec au 95e centile. Nous constatons que 1% des lectures Spanner, soit 200K lectures par seconde, bénéficient de la couverture (hedging). Notons que Zanzibar utilise une instance de Spanner exécutée en interne chez Google, et non une instance de Cloud Spanner [6].
The Leopard index is performing 1.56M QPS at the median, or 2.22M QPS at the 99th percentile, based on data aggregated over 7 days. Over the same 7 days, Leopard servers respond in fewer than 150 μsec at the median, or under 1 msec at the 99th percentile. Leopard’s incremental layer during those 7 days writes roughly 500 index updates per second at the median, and approximately 1.5K updates per second at the 99th percentile.
L’index Leopard traite 1.56M QPS en médiane, ou 2.22M QPS au 99e centile, d’après des données agrégées sur 7 jours. Sur ces mêmes 7 jours, les serveurs Leopard répondent en moins de 150 μsec en médiane, ou en moins de 1 msec au 99e centile. Au cours de ces 7 jours, la couche incrémentale de Leopard écrit environ 500 mises à jour d’index par seconde en médiane, et environ 1.5K mises à jour par seconde au 99e centile.
Zanzibar has evolved to meet the varied and heavy demands of a growing set of clients, including Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos, and YouTube. This section highlights lessons learned from this experience.
Zanzibar a évolué pour répondre aux demandes variées et importantes d’un ensemble croissant de clients, dont Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos et YouTube. Cette section met en lumière les enseignements tirés de cette expérience.
One common theme has been the importance of flexibility to accommodate differences between clients. For example:
Un thème récurrent a été l’importance de la flexibilité pour s’adapter aux différences entre clients. Par exemple :
- Access control patterns vary widely: Over time we have added features to support specific clients. For instance, we added
computed_usersetto allow inferring an object’s owner ID from the object ID prefix, which reduces space requirements for clients such as Drive and Photos that manage many private objects. Similarly, we addedtuple_to_usersetto represent object hierarchy with only one relation tuple per hop. The benefits are both space reduction and flexibility—it allows clients such as Cloud both to express ACL inheritance compactly and to change ACL inheritance rules without having to update large numbers of tuples. See §2.3.1. - Freshness requirements are often but not always loose: Clients often allow unspecified, moderate staleness during ACL evaluation, but sometimes require more precisely specified freshness. We designed our zookie protocol around this property so that we can serve most requests from a default, already replicated snapshot, while allowing clients to bound the staleness when needed. We also tuned the granularity of our snapshot timestamps to match clients’ freshness requirements. The resulting coarse timestamp quanta allow us to perform the majority of authorization checks on a small number of snapshots, thus greatly reducing the frequency of database reads. See §3.2.1.
- Les modèles de contrôle d’accès varient considérablement : au fil du temps, nous avons ajouté des fonctionnalités pour répondre aux besoins de clients spécifiques. Par exemple, nous avons ajouté
computed_usersetpour permettre de déduire l’identifiant du propriétaire d’un objet à partir du préfixe de l’identifiant de l’objet, ce qui réduit les besoins en espace pour des clients tels que Drive et Photos, qui gèrent de nombreux objets privés. De même, nous avons ajoutétuple_to_usersetpour représenter la hiérarchie des objets avec un seul tuple de relation par saut. Les avantages sont à la fois la réduction de l’espace et la flexibilité — cela permet à des clients tels que Cloud à la fois d’exprimer l’héritage d’ACL de manière compacte et de modifier les règles d’héritage d’ACL sans avoir à mettre à jour un grand nombre de tuples. Voir §2.3.1. - Les exigences de fraîcheur sont souvent, mais pas toujours, souples : les clients tolèrent souvent une obsolescence modérée et non spécifiée lors de l’évaluation des ACL, mais exigent parfois une fraîcheur spécifiée plus précisément. Nous avons conçu notre protocole zookie autour de cette propriété, afin de pouvoir servir la plupart des requêtes à partir d’un instantané par défaut déjà répliqué, tout en permettant aux clients de borner l’obsolescence si nécessaire. Nous avons également ajusté la granularité de nos horodatages d’instantané pour correspondre aux exigences de fraîcheur des clients. Les quanta d’horodatage grossiers qui en résultent nous permettent d’effectuer la majorité des vérifications d’autorisation sur un petit nombre d’instantanés, réduisant ainsi considérablement la fréquence des lectures dans la base de données. Voir §3.2.1.
Another theme has been the need to add performance optimizations to support client behaviors observed in production. For example:
Un autre thème a été la nécessité d’ajouter des optimisations de performance pour prendre en charge les comportements des clients observés en production. Par exemple :
- Request hedging is key to reducing tail latency: Clients that offer search capabilities to their users, such as Drive, often issue tens to hundreds of authorization checks to serve a single set of search results. We introduced hedging of Spanner and Leopard requests to prevent an occasional slow operation from slowing the overall user interaction. See §3.2.7.
- Hot-spot mitigation is critical for high availability: Some workloads create hot spots in ACL data that can overwhelm the underlying database servers. A common pattern is a burst of ACL checks for an object that is indirectly referenced by the ACLs for many different objects. Specific instances arise from the search use case mentioned above, where the documents in the search indirectly share ACLs for a large social or work group, and Cloud use cases where many objects indirectly share ACLs for the same object high in a hierarchy. Zanzibar handles most hot spots with general mechanisms such as its distributed cache and lock table, but we have found the need to optimize specific uses cases. For example, we added cache prefetching of all relation tuples for a hot object. We also delayed cancellation of secondary ACL checks when there are concurrent requests for the same ACL data. See §3.2.5.
- Performance isolation is indispensable to protect against misbehaving clients: Even with hot-spot mitigation measures, unexpected and sometimes unintended client behaviors could still overload our system or its underlying infrastructure. Examples include when clients launch new features that prove unexpectedly popular or exercise Zanzibar in unintended ways. Over time we have added isolation safeguards to ensure that there are no cascading failures between clients or between objects of the same client. These safeguards include fine-grained cost accounting, quotas, and throttling. See §3.2.6.
- Les requêtes de couverture sont essentielles pour réduire la latence de queue : les clients qui offrent des capacités de recherche à leurs utilisateurs, comme Drive, émettent souvent des dizaines à des centaines de vérifications d’autorisation pour servir un seul ensemble de résultats de recherche. Nous avons introduit la couverture (hedging) des requêtes Spanner et Leopard pour éviter qu’une opération lente occasionnelle ne ralentisse l’ensemble de l’interaction de l’utilisateur. Voir §3.2.7.
- L’atténuation des points chauds est cruciale pour la haute disponibilité : certaines charges de travail créent dans les données d’ACL des points chauds susceptibles de submerger les serveurs de bases de données sous-jacents. Un schéma courant est une rafale de vérifications d’ACL portant sur un objet référencé indirectement par les ACL de nombreux objets différents. Des cas concrets proviennent du cas d’usage de recherche mentionné ci-dessus, où les documents de la recherche partagent indirectement les ACL d’un grand groupe social ou professionnel, et des cas d’usage de Cloud, où de nombreux objets partagent indirectement les ACL d’un même objet situé haut dans une hiérarchie. Zanzibar gère la plupart des points chauds avec des mécanismes généraux tels que son cache distribué et sa table de verrous, mais nous avons constaté la nécessité d’optimiser certains cas d’usage spécifiques. Par exemple, nous avons ajouté le préchargement en cache de tous les tuples de relation d’un objet chaud. Nous avons également retardé l’annulation des vérifications d’ACL secondaires lorsqu’il existe des requêtes concurrentes portant sur les mêmes données d’ACL. Voir §3.2.5.
- L’isolation des performances est indispensable pour se protéger des clients au comportement anormal : même avec des mesures d’atténuation des points chauds, des comportements de clients inattendus, et parfois involontaires, pourraient encore surcharger notre système ou son infrastructure sous-jacente. Citons par exemple le cas de clients qui lancent de nouvelles fonctionnalités dont la popularité s’avère inattendue, ou qui sollicitent Zanzibar de manière imprévue. Au fil du temps, nous avons ajouté des garde-fous d’isolation pour garantir l’absence de défaillances en cascade entre clients ou entre objets d’un même client. Ces garde-fous comprennent une comptabilisation fine des coûts, des quotas et du bridage (throttling). Voir §3.2.6.
Zanzibar is a planet-scale distributed ACL storage and evaluation system. Many of its authorization concepts have been explored previously within the domains of access control and social graphs, and its scaling challenges have been investigated within the field of distributed systems.
Zanzibar est un système distribué de stockage et d’évaluation d’ACL à l’échelle planétaire. Nombre de ses concepts d’autorisation ont déjà été explorés dans les domaines du contrôle d’accès et des graphes sociaux, et ses défis de passage à l’échelle ont été étudiés dans le domaine des systèmes distribués.
Access control is a core part of multi-user operating systems. Multics [23] supports ACLs on segments and directories. ACL entries consist of a principal identifier and a set of permissions bits. In the first edition of UNIX [9], file flags indicate whether owner and non-owner can read or write the file. By the 4th edition, the permissions bits had been expanded to read/write/execute bits for owner, group, and others. POSIX ACLs [4] add an arbitrary list of users and groups, each with up to 32 permissions bits. VMS [7, 8] supports ACL inheritance for files created within a directory tree. Zanzibar’s data model supports permissions, users, groups, and inheritance as found in the above systems.
Le contrôle d’accès est un élément central des systèmes d’exploitation multi-utilisateurs. Multics [23] prend en charge les ACL sur les segments et les répertoires. Les entrées d’ACL se composent d’un identifiant de principal et d’un ensemble de bits de permission. Dans la première édition d’UNIX [9], des indicateurs de fichier précisent si le propriétaire et les non-propriétaires peuvent lire ou écrire le fichier. Dès la 4e édition, les bits de permission avaient été étendus à des bits de lecture/écriture/exécution pour le propriétaire, le groupe et les autres. Les ACL POSIX [4] ajoutent une liste arbitraire d’utilisateurs et de groupes, chacun disposant d’au plus 32 bits de permission. VMS [7, 8] prend en charge l’héritage d’ACL pour les fichiers créés dans une arborescence de répertoires. Le modèle de données de Zanzibar prend en charge les permissions, les utilisateurs, les groupes et l’héritage tels qu’on les trouve dans les systèmes ci-dessus.
Taos [24, 10] supports compound principals that incorporate how an identity has been transformed as it passes through a distributed system. For example, if user logged into workstation to access file server , would see requests authenticated as “ for ” rather than just . This would allow one to write an ACL on a user’s e-mail that would be accessible only to the user, and only if being accessed via the mail server. Abadi et al. discuss in [11] a model of group-based ACLs with support for compound identities. Their notion of “blessings” are similar to Zanzibar tuples. However, Zanzibar adopts a unified representation for ACLs and groups using usersets, while they are separate concepts in [11].
Taos [24, 10] prend en charge des principaux composés qui intègrent la manière dont une identité a été transformée lors de son passage à travers un système distribué. Par exemple, si l’utilisateur s’est connecté à la station de travail pour accéder au serveur de fichiers , verrait des requêtes authentifiées comme « pour » plutôt que simplement . Cela permettrait d’écrire, sur le courrier électronique d’un utilisateur, une ACL qui le rendrait accessible uniquement à cet utilisateur, et seulement s’il y est accédé via le serveur de messagerie. Abadi et al. examinent dans [11] un modèle d’ACL fondées sur les groupes, prenant en charge les identités composées. Leur notion de « bénédictions » (blessings) est similaire aux tuples de Zanzibar. Cependant, Zanzibar adopte une représentation unifiée des ACL et des groupes à l’aide des usersets, alors qu’il s’agit de concepts distincts dans [11].
Role-based access control (RBAC), first proposed in [17], introduced the notion of roles, which are similar to Zanzibar relations. Roles can inherit from each other and imply permissions. A number of Zanzibar clients have implemented RBAC policies on top of Zanzibar’s namespace configuration language.
Le contrôle d’accès à base de rôles (RBAC), proposé pour la première fois dans [17], a introduit la notion de rôles, qui sont similaires aux relations de Zanzibar. Les rôles peuvent hériter les uns des autres et impliquer des permissions. Un certain nombre de clients de Zanzibar ont mis en œuvre des politiques RBAC au-dessus du langage de configuration des espaces de noms de Zanzibar.
A discussion of ACL stores in 2019 would be remiss without mentioning the Identity and Access Management (IAM) systems offered commercially by Amazon [1], Google [5], Microsoft [2], and others. These systems allow customers of those companies’ cloud products to configure flexible access controls based on various features such as: assigning users to roles or groups; domain-specific policy languages; and APIs that allow the creation and modification of ACLs. What all of these systems have in common is unified ACL storage and an RPC-based API, a philosophy also core to Zanzibar’s design. Google’s Cloud IAM system [5] is built as a layer on top of Zanzibar’s ACL storage and evaluation system.
Une discussion des systèmes de stockage d’ACL en 2019 serait incomplète sans mentionner les systèmes de gestion des identités et des accès (IAM) proposés commercialement par Amazon [1], Google [5], Microsoft [2] et d’autres. Ces systèmes permettent aux clients des produits cloud de ces entreprises de configurer des contrôles d’accès flexibles reposant sur diverses fonctionnalités telles que : l’affectation d’utilisateurs à des rôles ou à des groupes ; des langages de politiques propres à un domaine ; et des API permettant la création et la modification d’ACL. Ce que tous ces systèmes ont en commun, c’est un stockage unifié des ACL et une API fondée sur des RPC, une philosophie également au cœur de la conception de Zanzibar. Le système Cloud IAM de Google [5] est construit comme une couche au-dessus du système de stockage et d’évaluation d’ACL de Zanzibar.
TAO [13] is a distributed datastore for Facebook’s social graph. Several Zanzibar clients also use Zanzibar to store their social graphs. Both Zanzibar and TAO provide authorization checks to clients. Both are deployed as single-instance services, both operate at a large scale, and both are optimized for read-only operations. TAO offers eventual global consistency with asynchronous replication and best-effort read-after-write consistency with synchronous cache updates. In contrast, Zanzibar provides external consistency and snapshot reads with bounded staleness, so that it respects causal ordering between ACL and content updates and thus protects against the “new enemy” problem.
TAO [13] est un magasin de données distribué pour le graphe social de Facebook. Plusieurs clients de Zanzibar utilisent également Zanzibar pour stocker leurs graphes sociaux. Zanzibar et TAO fournissent tous deux des vérifications d’autorisation à leurs clients. Tous deux sont déployés en tant que services à instance unique, tous deux fonctionnent à grande échelle et tous deux sont optimisés pour les opérations en lecture seule. TAO offre une cohérence globale à terme avec une réplication asynchrone, ainsi qu’une cohérence lecture-après-écriture au mieux (best-effort) avec des mises à jour synchrones du cache. En revanche, Zanzibar fournit la cohérence externe et des lectures d’instantané à obsolescence bornée, de sorte qu’il respecte l’ordre causal entre les mises à jour d’ACL et de contenu et protège ainsi contre le problème du « nouvel ennemi ».
Lamport clocks [22] provide partially ordered vector timestamps that can be used to determine the order of events. However, Lamport clocks require explicit participation of all “processes”, where in Zanzibar’s use cases some of the “processes” can be external clients or even human users. In contrast, Zanzibar relies on its underlying database system, Spanner [15], to offer both external consistency and snapshot reads with bounded staleness. In particular, Zanzibar builds on Spanner’s TrueTime abstraction [15] to provide linearizable commit timestamps encoded as zookies.
Les horloges de Lamport [22] fournissent des horodatages vectoriels partiellement ordonnés qui peuvent servir à déterminer l’ordre des événements. Cependant, les horloges de Lamport exigent la participation explicite de tous les « processus », alors que, dans les cas d’usage de Zanzibar, certains de ces « processus » peuvent être des clients externes, voire des utilisateurs humains. En revanche, Zanzibar s’appuie sur son système de base de données sous-jacent, Spanner [15], pour offrir à la fois la cohérence externe et des lectures d’instantané à obsolescence bornée. En particulier, Zanzibar s’appuie sur l’abstraction TrueTime de Spanner [15] pour fournir des horodatages de validation linéarisables encodés sous forme de zookies.
At the same time, Zanzibar adds a number of features on top of those provided by Spanner. For one, the zookie protocol does not let clients read or evaluate ACLs at an arbitrary snapshot. This restriction allows Zanzibar to choose a snapshot that facilitates fast ACL evaluation. In addition, Zanzibar provides resilience to database hotspots (e.g. authorization checks on a suddenly popular video) and safe pointer chasing despite potentially deep recursion (e.g. membership checks on hierarchical groups).
Dans le même temps, Zanzibar ajoute un certain nombre de fonctionnalités à celles fournies par Spanner. Tout d’abord, le protocole zookie ne permet pas aux clients de lire ou d’évaluer des ACL sur un instantané arbitraire. Cette restriction permet à Zanzibar de choisir un instantané qui facilite une évaluation rapide des ACL. En outre, Zanzibar offre une résilience aux points chauds de la base de données (p. ex. des vérifications d’autorisation sur une vidéo soudainement populaire) et une poursuite de pointeurs sûre malgré une récursion potentiellement profonde (p. ex. des vérifications d’appartenance à des groupes hiérarchiques).
The Chubby distributed lock service [14] offers reliable storage, linearizes writes, and provides access control, but it lacks features needed to support Zanzibar’s use cases. In particular, it does not support high volumes of data, efficient range reads, or reads at a client-specified snapshot with bounded staleness. Its cache invalidation mechanism also limits its write throughput.
Le service de verrous distribué Chubby [14] offre un stockage fiable, linéarise les écritures et fournit un contrôle d’accès, mais il ne dispose pas des fonctionnalités nécessaires pour prendre en charge les cas d’usage de Zanzibar. En particulier, il ne prend en charge ni de grands volumes de données, ni des lectures efficaces par plages, ni des lectures sur un instantané spécifié par le client avec une obsolescence bornée. Son mécanisme d’invalidation du cache limite également son débit d’écriture.
Finally, ZooKeeper offers a high-performance coordination service [19] but also lacks features required by Zanzibar. Relative to Chubby, it can handle higher read and write rates with more relaxed cache consistency. However, it does not provide external consistency for updates across different nodes since its linearizability is on a per-node basis. It also does not provide snapshot reads with bounded staleness.
Enfin, ZooKeeper offre un service de coordination à hautes performances [19], mais ne dispose pas non plus des fonctionnalités requises par Zanzibar. Par rapport à Chubby, il peut gérer des débits de lecture et d’écriture plus élevés avec une cohérence de cache plus relâchée. Cependant, il ne fournit pas de cohérence externe pour les mises à jour portant sur différents nœuds, car sa linéarisabilité s’applique nœud par nœud. Il ne fournit pas non plus de lectures d’instantané à obsolescence bornée.
The Zanzibar authorization system unifies access control data and logic for Google. Its simple yet flexible data model and configuration language support a variety of access control policies from both consumer and enterprise applications.
Le système d’autorisation Zanzibar unifie les données et la logique de contrôle d’accès pour Google. Son modèle de données et son langage de configuration, simples mais flexibles, prennent en charge une diversité de politiques de contrôle d’accès issues d’applications aussi bien grand public que d’entreprise.
Zanzibar’s external consistency model is one of its most salient features. It respects the ordering of user actions, yet at the same time allows authorization checks to be evaluated at distributed locations without global synchronization.
Le modèle de cohérence externe de Zanzibar est l’une de ses caractéristiques les plus marquantes. Il respecte l’ordre des actions des utilisateurs tout en permettant d’évaluer les vérifications d’autorisation en des emplacements distribués, sans synchronisation globale.
Zanzibar employs other key techniques to provide scalability, low latency, and high availability. For example, it evaluates deeply or widely nested group membership with Leopard, a specialized index for efficient computation of set operations with snapshot consistency. As another example, it combines a distributed cache with a mechanism to deduplicate in-flight requests. It thus mitigates hot spots, a critical production issue when serving data on top of normalized, consistent storage. These measures together result in a system that scales to trillions of access control rules and millions of authorization requests per second.
Zanzibar emploie d’autres techniques clés pour assurer le passage à l’échelle, une faible latence et une haute disponibilité. Par exemple, il évalue les appartenances à des groupes imbriqués en profondeur ou en largeur avec Leopard, un index spécialisé permettant le calcul efficace d’opérations ensemblistes avec une cohérence d’instantané. Autre exemple, il combine un cache distribué avec un mécanisme de déduplication des requêtes en cours. Il atténue ainsi les points chauds, un problème critique en production lorsque l’on sert des données reposant sur un stockage normalisé et cohérent. Ensemble, ces mesures donnent un système qui passe à l’échelle de milliers de milliards de règles de contrôle d’accès et de millions de requêtes d’autorisation par seconde.
Many people have made technical contributions to Zanzibar. We thank previous and recent members of the development team, including Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp, and Yuliya Zabiyaka. We also thank previous and current members of the Site Reliability Engineering team, including Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson, and Andrea Yu.
De nombreuses personnes ont apporté des contributions techniques à Zanzibar. Nous remercions les membres anciens et récents de l’équipe de développement, notamment Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp et Yuliya Zabiyaka. Nous remercions également les membres anciens et actuels de l’équipe Site Reliability Engineering, notamment Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson et Andrea Yu.
In addition, a number of people have helped to improve this paper. We received insightful comments from David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen, and Lawrence You. We are also grateful to Nadav Eiron and Royal Hansen for their support. Finally, we thank the anonymous reviewers and our shepherd, Eric Eide, for their constructive feedback.
En outre, un certain nombre de personnes ont contribué à améliorer cet article. Nous avons reçu des commentaires éclairants de David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen et Lawrence You. Nous sommes également reconnaissants à Nadav Eiron et Royal Hansen pour leur soutien. Enfin, nous remercions les relecteurs anonymes et notre rapporteur référent (shepherd), Eric Eide, pour leurs retours constructifs.