Determining whether online users are authorized to access digital objects is central to preserving privacy. This paper presents the design, implementation, and deployment of Zanzibar, a global system for storing and evaluating access control lists. Zanzibar provides a uniform data model and configuration language for expressing a wide range of access control policies from hundreds of client services at Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Its authorization decisions respect causal ordering of user actions and thus provide external consistency amid changes to access control lists and object contents. Zanzibar scales to trillions of access control lists and millions of authorization requests per second to support services used by billions of people. It has maintained 95th-percentile latency of less than 10 milliseconds and availability of greater than 99.999% over 3 years of production use.
Festzustellen, ob Online-Benutzer zum Zugriff auf digitale Objekte autorisiert sind, ist zentral für den Schutz der Privatsphäre. Dieses Paper stellt Entwurf, Implementierung und Einsatz von Zanzibar vor, einem globalen System zum Speichern und Auswerten von Zugriffskontrolllisten. Zanzibar bietet ein einheitliches Datenmodell und eine einheitliche Konfigurationssprache, um ein breites Spektrum von Zugriffskontrollrichtlinien von Hunderten von Client-Diensten bei Google auszudrücken, darunter Calendar, Cloud, Drive, Maps, Photos und YouTube. Seine Autorisierungsentscheidungen respektieren die kausale Reihenfolge von Benutzeraktionen und gewährleisten so externe Konsistenz trotz Änderungen an Zugriffskontrolllisten und Objektinhalten. Zanzibar skaliert auf Billionen von Zugriffskontrolllisten und Millionen von Autorisierungsanfragen pro Sekunde, um Dienste zu unterstützen, die von Milliarden von Menschen genutzt werden. Über 3 Jahre Produktiveinsatz hinweg hat es eine Latenz im 95. Perzentil von weniger als 10 Millisekunden und eine Verfügbarkeit von mehr als 99,999% aufrechterhalten.
Many online interactions require authorization checks to confirm that a user has permission to carry out an operation on a digital object. For example, web-based photo storage services typically allow photo owners to share some photos with friends while keeping other photos private. Such a service must check whether a photo has been shared with a user before allowing that user to view the photo. Robust authorization checks are central to preserving online privacy.
Viele Online-Interaktionen erfordern Autorisierungsprüfungen, um zu bestätigen, dass ein Benutzer die Berechtigung hat, eine Operation auf einem digitalen Objekt auszuführen. Beispielsweise erlauben webbasierte Fotospeicherdienste es Fotobesitzern typischerweise, einige Fotos mit Freunden zu teilen, während andere Fotos privat bleiben. Ein solcher Dienst muss prüfen, ob ein Foto mit einem Benutzer geteilt wurde, bevor er diesem Benutzer erlaubt, das Foto anzusehen. Robuste Autorisierungsprüfungen sind zentral für den Schutz der Privatsphäre im Internet.
This paper presents Zanzibar, a system for storing permissions and performing authorization checks based on the stored permissions. It is used by a wide array of services offered by Google, including Calendar, Cloud, Drive, Maps, Photos, and YouTube. Several of these services manage billions of objects on behalf of more than a billion users.
Dieses Paper stellt Zanzibar vor, ein System zum Speichern von Berechtigungen und zum Durchführen von Autorisierungsprüfungen auf Grundlage der gespeicherten Berechtigungen. Es wird von einer breiten Palette von Diensten genutzt, die Google anbietet, darunter Calendar, Cloud, Drive, Maps, Photos und YouTube. Mehrere dieser Dienste verwalten Milliarden von Objekten im Auftrag von mehr als einer Milliarde Benutzern.
A unified authorization system offers important advantages over maintaining separate access control mechanisms for individual applications. First, it helps establish consistent semantics and user experience across applications. Second, it makes it easier for applications to interoperate, for example, to coordinate access control when an object from one application embeds an object from another application. Third, useful common infrastructure can be built on top of a unified access control system, in particular, a search index that respects access control and works across applications. Finally, as we show below, authorization poses unique challenges involving data consistency and scalability. It saves engineering resources to tackle them once across applications.
Ein einheitliches Autorisierungssystem bietet wichtige Vorteile gegenüber dem Betrieb separater Zugriffskontrollmechanismen für einzelne Anwendungen. Erstens hilft es, über Anwendungen hinweg eine konsistente Semantik und Benutzererfahrung zu etablieren. Zweitens erleichtert es die Interoperabilität von Anwendungen, beispielsweise die Koordination der Zugriffskontrolle, wenn ein Objekt einer Anwendung ein Objekt einer anderen Anwendung einbettet. Drittens lässt sich auf einem einheitlichen Zugriffskontrollsystem nützliche gemeinsame Infrastruktur aufbauen, insbesondere ein Suchindex, der die Zugriffskontrolle respektiert und anwendungsübergreifend funktioniert. Schließlich bringt Autorisierung, wie wir weiter unten zeigen, besondere Herausforderungen in Bezug auf Datenkonsistenz und Skalierbarkeit mit sich. Es spart Engineering-Ressourcen, diese einmal für alle Anwendungen zu bewältigen.
We have the following goals for the Zanzibar system:
Wir verfolgen mit dem Zanzibar-System die folgenden Ziele:
- Correctness: It must ensure consistency of access control decisions to respect user intentions.
- Flexibility: It must support a rich set of access control policies as required by both consumer and enterprise applications.
- Low latency: It must respond quickly because authorization checks are often in the critical path of user interactions. Low latency at the tail is particularly important for serving search results, which often require tens to hundreds of checks.
- High availability: It must reliably respond to requests because, in the absence of explicit authorizations, client services would be forced to deny their users access.
- Large scale: It needs to protect billions of objects shared by billions of users. It must be deployed around the globe to be near its clients and their end users.
- Korrektheit: Es muss die Konsistenz von Zugriffskontrollentscheidungen sicherstellen, um die Absichten der Benutzer zu respektieren.
- Flexibilität: Es muss eine reichhaltige Menge von Zugriffskontrollrichtlinien unterstützen, wie sie sowohl Verbraucher- als auch Unternehmensanwendungen benötigen.
- Niedrige Latenz: Es muss schnell antworten, da Autorisierungsprüfungen oft im kritischen Pfad von Benutzerinteraktionen liegen. Niedrige Latenz im Tail ist besonders wichtig für die Auslieferung von Suchergebnissen, die oft Dutzende bis Hunderte von Prüfungen erfordern.
- Hohe Verfügbarkeit: Es muss zuverlässig auf Anfragen antworten, da Client-Dienste ihren Benutzern ohne explizite Autorisierungen den Zugriff verweigern müssten.
- Großer Maßstab: Es muss Milliarden von Objekten schützen, die von Milliarden von Benutzern geteilt werden. Es muss weltweit bereitgestellt werden, um nahe bei seinen Clients und deren Endbenutzern zu sein.
Zanzibar achieves these goals through a combination of notable features. To provide flexibility, Zanzibar pairs a simple data model with a powerful configuration language. The language allows clients to define arbitrary relations between users and objects, such as owner, editor, commenter, and viewer. It includes set-algebraic operators such as intersection and union for specifying potentially complex access control policies in terms of those user-object relations. For example, an application can specify that users granted editing rights on a document are also allowed to comment on the document, but not all commenters are given editing rights.
Zanzibar erreicht diese Ziele durch eine Kombination bemerkenswerter Eigenschaften. Um Flexibilität zu bieten, kombiniert Zanzibar ein einfaches Datenmodell mit einer mächtigen Konfigurationssprache. Die Sprache erlaubt es Clients, beliebige Relationen zwischen Benutzern und Objekten zu definieren, etwa owner, editor, commenter und viewer. Sie enthält mengenalgebraische Operatoren wie Schnittmenge und Vereinigung, um potenziell komplexe Zugriffskontrollrichtlinien anhand dieser Benutzer-Objekt-Relationen zu spezifizieren. Beispielsweise kann eine Anwendung festlegen, dass Benutzer, denen Bearbeitungsrechte für ein Dokument gewährt wurden, das Dokument auch kommentieren dürfen, aber nicht alle Kommentierenden Bearbeitungsrechte erhalten.
At runtime, Zanzibar allows clients to create, modify, and evaluate access control lists (ACLs) through a remote procedure call (RPC) interface. A simple ACL takes the form of “user U has relation R to object O”. More complex ACLs take the form of “set of users S has relation R to object O”, where S is itself specified in terms of another object-relation pair. ACLs can thus refer to other ACLs, for example to specify that the set of users who can comment on a video consists of the users who have been granted viewing rights on that specific video along with those with viewing permissions on the video channel.
Zur Laufzeit erlaubt Zanzibar es Clients, Zugriffskontrolllisten (ACLs) über eine Remote-Procedure-Call-Schnittstelle (RPC) zu erstellen, zu ändern und auszuwerten. Eine einfache ACL hat die Form „Benutzer U hat Relation R zu Objekt O“. Komplexere ACLs haben die Form „Menge von Benutzern S hat Relation R zu Objekt O“, wobei S selbst über ein anderes Objekt-Relation-Paar spezifiziert wird. ACLs können somit auf andere ACLs verweisen, beispielsweise um festzulegen, dass die Menge der Benutzer, die ein Video kommentieren dürfen, aus den Benutzern besteht, denen Ansichtsrechte für genau dieses Video gewährt wurden, zusammen mit denjenigen, die Ansichtsberechtigungen für den Videokanal haben.
Group memberships are an important class of ACL where the object is a group and the relation is semantically equivalent to member. Groups can contain other groups, which illustrates one of the challenges facing Zanzibar, namely that evaluating whether a user belongs to a group can entail following a long chain of nested group memberships.
Gruppenmitgliedschaften sind eine wichtige Klasse von ACLs, bei denen das Objekt eine Gruppe ist und die Relation semantisch member entspricht. Gruppen können andere Gruppen enthalten, was eine der Herausforderungen für Zanzibar verdeutlicht: Die Auswertung, ob ein Benutzer zu einer Gruppe gehört, kann es erfordern, einer langen Kette verschachtelter Gruppenmitgliedschaften zu folgen.
Authorization checks take the form of “does user U have relation R to object O?” and are evaluated by a collection of distributed servers. When a check request arrives to Zanzibar, the work to evaluate the check may fan out to multiple servers, for example when a group contains both individual members and other groups. Each of those servers may in turn contact other servers, for example to recursively traverse a hierarchy of group memberships.
Autorisierungsprüfungen haben die Form „hat Benutzer U die Relation R zu Objekt O?“ und werden von einer Menge verteilter Server ausgewertet. Wenn eine Check-Anfrage bei Zanzibar eintrifft, kann sich die Arbeit zur Auswertung der Prüfung auf mehrere Server auffächern, etwa wenn eine Gruppe sowohl einzelne Mitglieder als auch andere Gruppen enthält. Jeder dieser Server kann seinerseits andere Server kontaktieren, beispielsweise um eine Hierarchie von Gruppenmitgliedschaften rekursiv zu durchlaufen.
Zanzibar operates at a global scale along multiple dimensions. It stores more than two trillion ACLs and performs millions of authorization checks per second. The ACL data does not lend itself to geographic partitioning because authorization checks for any object can come from anywhere in the world. Therefore, Zanzibar replicates all ACL data in tens of geographically distributed data centers and distributes load across thousands of servers around the world.
Zanzibar operiert in mehreren Dimensionen in globalem Maßstab. Es speichert mehr als zwei Billionen ACLs und führt Millionen von Autorisierungsprüfungen pro Sekunde durch. Die ACL-Daten eignen sich nicht für eine geografische Partitionierung, da Autorisierungsprüfungen für ein beliebiges Objekt von überall auf der Welt kommen können. Daher repliziert Zanzibar alle ACL-Daten in Dutzenden geografisch verteilter Rechenzentren und verteilt die Last auf Tausende von Servern weltweit.
Zanzibar supports global consistency of access control decisions through two interrelated features. One, it respects the order in which ACL changes are committed to the underlying data store. Two, it can ensure that authorization checks are based on ACL data no older than a client-specified change. Thus, for example, a client can remove a user from a group and be assured that subsequent membership checks reflect that removal. Zanzibar provides these ordering properties by storing ACLs in a globally distributed database system with external consistency guarantees [15, 18].
Zanzibar unterstützt globale Konsistenz von Zugriffskontrollentscheidungen durch zwei miteinander verknüpfte Eigenschaften. Erstens respektiert es die Reihenfolge, in der ACL-Änderungen im zugrunde liegenden Datenspeicher committet werden. Zweitens kann es sicherstellen, dass Autorisierungsprüfungen auf ACL-Daten beruhen, die nicht älter sind als eine vom Client angegebene Änderung. So kann ein Client beispielsweise einen Benutzer aus einer Gruppe entfernen und sich darauf verlassen, dass nachfolgende Mitgliedschaftsprüfungen diese Entfernung widerspiegeln. Zanzibar stellt diese Ordnungseigenschaften bereit, indem es ACLs in einem global verteilten Datenbanksystem mit Garantien externer Konsistenz speichert [15, 18].
Zanzibar employs an array of techniques to achieve low latency and high availability in this globally distributed environment. Its consistency protocol allows the vast majority of requests to be served with locally replicated data, without requiring cross-region round trips. Zanzibar stores its data in normalized forms for consistency. It handles hot spots on normalized data by caching final and intermediate results, and by deduplicating simultaneous requests. It also applies techniques such as hedging requests and optimizing computations on deeply nested sets with limited denormalization. Zanzibar responds to more than 95% of authorization checks within 10 milliseconds and has maintained more than 99.999% availability for the last 3 years.
Zanzibar setzt eine Reihe von Techniken ein, um in dieser global verteilten Umgebung niedrige Latenz und hohe Verfügbarkeit zu erreichen. Sein Konsistenzprotokoll erlaubt es, die überwiegende Mehrheit der Anfragen mit lokal replizierten Daten zu bedienen, ohne regionsübergreifende Round Trips zu erfordern. Zanzibar speichert seine Daten aus Konsistenzgründen in normalisierter Form. Hotspots auf normalisierten Daten behandelt es durch Caching von End- und Zwischenergebnissen sowie durch Deduplizierung gleichzeitiger Anfragen. Außerdem wendet es Techniken wie Request-Hedging und die Optimierung von Berechnungen auf tief verschachtelten Mengen mit begrenzter Denormalisierung an. Zanzibar beantwortet mehr als 95% der Autorisierungsprüfungen innerhalb von 10 Millisekunden und hat in den letzten 3 Jahren eine Verfügbarkeit von mehr als 99,999% aufrechterhalten.
The main contributions of this paper lie in conveying the engineering challenges in building and deploying a consistent, world-scale authorization system. While most elements of Zanzibar’s design have their roots in previous research, this paper provides a record of the features and techniques Zanzibar brings together to satisfy its stringent requirements for correctness, flexibility, latency, availability, and scalability. The paper also highlights lessons learned from operating Zanzibar in service of a diverse set of demanding clients.
Die wesentlichen Beiträge dieses Papers liegen darin, die technischen Herausforderungen beim Aufbau und Einsatz eines konsistenten Autorisierungssystems im Weltmaßstab zu vermitteln. Während die meisten Elemente des Designs von Zanzibar ihre Wurzeln in früherer Forschung haben, dokumentiert dieses Paper die Eigenschaften und Techniken, die Zanzibar zusammenführt, um seine strengen Anforderungen an Korrektheit, Flexibilität, Latenz, Verfügbarkeit und Skalierbarkeit zu erfüllen. Das Paper hebt außerdem Erkenntnisse aus dem Betrieb von Zanzibar im Dienst einer vielfältigen Menge anspruchsvoller Clients hervor.
This section describes Zanzibar’s data model, configuration language, and application programming interface (API).
Dieser Abschnitt beschreibt das Datenmodell, die Konfigurationssprache und die Programmierschnittstelle (API) von Zanzibar.
In Zanzibar, ACLs are collections of object-user or object-object relations represented as relation tuples. Groups are simply ACLs with membership semantics. Relation tuples have efficient binary encodings, but in this paper we represent them using a convenient text notation:
In Zanzibar sind ACLs Sammlungen von Objekt-Benutzer- oder Objekt-Objekt-Relationen, die als Relationstupel dargestellt werden. Gruppen sind einfach ACLs mit Mitgliedschaftssemantik. Relationstupel haben effiziente binäre Kodierungen, doch in diesem Paper stellen wir sie in einer handlichen Textnotation dar:
where ⟨namespace⟩ and ⟨relation⟩ are predefined in client configurations (§2.3), ⟨object_id⟩ is a string, and ⟨user_id⟩ is an integer. The primary keys required to identify a relation tuple are ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩, and ⟨user⟩. One feature worth noting is that a ⟨userset⟩ allows ACLs to refer to groups and thus supports representing nested group membership.
wobei ⟨namespace⟩ und ⟨relation⟩ in Client-Konfigurationen vordefiniert sind (§2.3), ⟨object_id⟩ ein String und ⟨user_id⟩ eine ganze Zahl ist. Die zur Identifikation eines Relationstupels erforderlichen Primärschlüssel sind ⟨namespace⟩, ⟨object_id⟩, ⟨relation⟩ und ⟨user⟩. Eine bemerkenswerte Eigenschaft ist, dass ein ⟨userset⟩ es ACLs erlaubt, auf Gruppen zu verweisen, und damit die Darstellung verschachtelter Gruppenmitgliedschaften unterstützt.
Table 1 shows some example tuples and corresponding semantics. While some relations (e.g. viewer) define access control directly, others (e.g. parent, pointing to a folder) only define abstract relations between objects. These abstract relations may indirectly affect access control given userset rewrite rules specified in namespace configs (§2.3.1).
Tabelle 1 zeigt einige Beispieltupel und die zugehörige Semantik. Während einige Relationen (z. B. viewer) die Zugriffskontrolle direkt definieren, definieren andere (z. B. parent, das auf einen Ordner verweist) lediglich abstrakte Relationen zwischen Objekten. Diese abstrakten Relationen können die Zugriffskontrolle indirekt beeinflussen, sofern in Namespace-Konfigurationen Userset-Umschreibregeln spezifiziert sind (§2.3.1).
Table 1: Example relation tuples. “#...” represents a relation that does not affect the semantics of the tuple.
Tabelle 1: Beispiele für Relationstupel. „#...“ steht für eine Relation, die die Semantik des Tupels nicht beeinflusst.
Defining our data model around tuples, instead of per-object ACLs, allows us to unify the concepts of ACLs and groups and to support efficient reads and incremental updates, as we will see in §2.4.
Unser Datenmodell um Tupel statt um ACLs pro Objekt herum zu definieren, erlaubt es uns, die Konzepte von ACLs und Gruppen zu vereinheitlichen sowie effiziente Lesevorgänge und inkrementelle Aktualisierungen zu unterstützen, wie wir in §2.4 sehen werden.
ACL checks must respect the order in which users modify ACLs and object contents to avoid unexpected sharing behaviors. Specifically, our clients care about preventing the “new enemy” problem, which can arise when we fail to respect the ordering between ACL updates or when we apply old ACLs to new content. Consider these two examples:
ACL-Prüfungen müssen die Reihenfolge respektieren, in der Benutzer ACLs und Objektinhalte ändern, um unerwartetes Freigabeverhalten zu vermeiden. Konkret liegt unseren Clients daran, das „New Enemy“-Problem zu verhindern, das entstehen kann, wenn wir die Reihenfolge zwischen ACL-Aktualisierungen nicht respektieren oder alte ACLs auf neue Inhalte anwenden. Betrachten Sie diese zwei Beispiele:
Example A: Neglecting ACL update order
- Alice removes Bob from the ACL of a folder;
- Alice then asks Charlie to move new documents to the folder, where document ACLs inherit from folder ACLs;
- Bob should not be able to see the new documents, but may do so if the ACL check neglects the ordering between the two ACL changes.
Beispiel A: Missachtung der Reihenfolge von ACL-Aktualisierungen
- Alice entfernt Bob aus der ACL eines Ordners;
- Alice bittet dann Charlie, neue Dokumente in den Ordner zu verschieben, wobei Dokument-ACLs von Ordner-ACLs erben;
- Bob sollte die neuen Dokumente nicht sehen können, kann dies aber, wenn die ACL-Prüfung die Reihenfolge zwischen den beiden ACL-Änderungen missachtet.
Example B: Misapplying old ACL to new content
- Alice removes Bob from the ACL of a document;
- Alice then asks Charlie to add new contents to the document;
- Bob should not be able to see the new contents, but may do so if the ACL check is evaluated with a stale ACL from before Bob’s removal.
Beispiel B: Fehlanwendung einer alten ACL auf neue Inhalte
- Alice entfernt Bob aus der ACL eines Dokuments;
- Alice bittet dann Charlie, dem Dokument neue Inhalte hinzuzufügen;
- Bob sollte die neuen Inhalte nicht sehen können, kann dies aber, wenn die ACL-Prüfung mit einer veralteten ACL von vor Bobs Entfernung ausgewertet wird.
Preventing the “new enemy” problem requires Zanzibar to understand and respect the causal ordering between ACL or content updates, including updates on different ACLs or objects and those coordinated via channels invisible to Zanzibar. Hence Zanzibar must provide two key consistency properties: external consistency [18] and snapshot reads with bounded staleness.
Um das „New Enemy“-Problem zu verhindern, muss Zanzibar die kausale Reihenfolge zwischen ACL- oder Inhaltsaktualisierungen verstehen und respektieren, einschließlich Aktualisierungen an unterschiedlichen ACLs oder Objekten sowie solcher, die über für Zanzibar unsichtbare Kanäle koordiniert werden. Daher muss Zanzibar zwei zentrale Konsistenzeigenschaften bereitstellen: externe Konsistenz [18] und Snapshot-Lesevorgänge mit begrenzter Veraltung.
External consistency allows Zanzibar to assign a timestamp to each ACL or content update, such that two causally related updates will be assigned timestamps that reflect the causal order: . With causally meaningful timestamps, a snapshot read of the ACL database at timestamp , which observes all updates with timestamps , will respect ordering between ACL updates. That is, if the read observes an update , it will observe all updates that happen causally before .
Externe Konsistenz erlaubt es Zanzibar, jeder ACL- oder Inhaltsaktualisierung einen Zeitstempel zuzuweisen, sodass zwei kausal zusammenhängenden Aktualisierungen Zeitstempel zugewiesen werden, die die kausale Reihenfolge widerspiegeln: . Mit kausal aussagekräftigen Zeitstempeln respektiert ein Snapshot-Lesevorgang der ACL-Datenbank zum Zeitstempel , der alle Aktualisierungen mit Zeitstempeln beobachtet, die Reihenfolge zwischen ACL-Aktualisierungen. Das heißt, wenn der Lesevorgang eine Aktualisierung beobachtet, beobachtet er auch alle Aktualisierungen, die kausal vor stattfinden.
Furthermore, to avoid applying old ACLs to new contents, the ACL check evaluation snapshot must not be staler than the causal timestamp assigned to the content update. Given a content update at timestamp , a snapshot read at timestamp ensures that all ACL updates that happen causally before the content update will be observed by the ACL check.
Um außerdem zu vermeiden, dass alte ACLs auf neue Inhalte angewendet werden, darf der Snapshot für die Auswertung der ACL-Prüfung nicht älter sein als der kausale Zeitstempel, der der Inhaltsaktualisierung zugewiesen wurde. Bei einer Inhaltsaktualisierung zum Zeitstempel stellt ein Snapshot-Lesevorgang zu einem Zeitstempel sicher, dass alle ACL-Aktualisierungen, die kausal vor der Inhaltsaktualisierung stattfinden, von der ACL-Prüfung beobachtet werden.
To provide external consistency and snapshot reads with bounded staleness, we store ACLs in the Spanner global database system [15]. Spanner’s TrueTime mechanism assigns each ACL write a microsecond-resolution timestamp, such that the timestamps of writes reflect the causal ordering between writes, and thereby provide external consistency. We evaluate each ACL check at a single snapshot timestamp across multiple database reads, so that all writes with timestamps up to the check snapshot, and only those writes, are visible to the ACL check.
Um externe Konsistenz und Snapshot-Lesevorgänge mit begrenzter Veraltung bereitzustellen, speichern wir ACLs im globalen Datenbanksystem Spanner [15]. Der TrueTime-Mechanismus von Spanner weist jedem ACL-Schreibvorgang einen Zeitstempel mit Mikrosekundenauflösung zu, sodass die Zeitstempel der Schreibvorgänge die kausale Reihenfolge zwischen Schreibvorgängen widerspiegeln und dadurch externe Konsistenz gewährleisten. Wir werten jede ACL-Prüfung über mehrere Datenbank-Lesevorgänge hinweg zu einem einzigen Snapshot-Zeitstempel aus, sodass alle Schreibvorgänge mit Zeitstempeln bis zum Snapshot der Prüfung, und nur diese, für die ACL-Prüfung sichtbar sind.
To avoid evaluating checks for new contents using stale ACLs, one could try to always evaluate at the latest snapshot such that the check result reflects all ACL writes up to the check call. However, such evaluation would require global data synchronization with high-latency round trips and limited availability. Instead, we design the following protocol to allow most checks to be evaluated on already replicated data with cooperation from Zanzibar clients:
Um zu vermeiden, dass Prüfungen für neue Inhalte mit veralteten ACLs ausgewertet werden, könnte man versuchen, stets auf dem neuesten Snapshot auszuwerten, sodass das Prüfergebnis alle ACL-Schreibvorgänge bis zum Aufruf der Prüfung widerspiegelt. Eine solche Auswertung würde jedoch eine globale Datensynchronisation mit Round Trips hoher Latenz und eingeschränkter Verfügbarkeit erfordern. Stattdessen entwerfen wir das folgende Protokoll, das es erlaubt, die meisten Prüfungen unter Mitwirkung der Zanzibar-Clients auf bereits replizierten Daten auszuwerten:
- A Zanzibar client requests an opaque consistency token called a zookie for each content version, via a content-change ACL check (§2.4.4) when the content modification is about to be saved. Zanzibar encodes a current global timestamp in the zookie and ensures that all prior ACL writes have lower timestamps. The client stores the zookie with the content change in an atomic write to the client storage. Note that the content-change check does not need to be evaluated in the same transaction as the application content modification, but only has to be triggered when the user modifies the contents.
- The client sends this zookie in subsequent ACL check requests to ensure that the check snapshot is at least as fresh as the timestamp for the content version.
- Ein Zanzibar-Client fordert für jede Inhaltsversion ein opakes Konsistenztoken namens zookie an, und zwar über eine ACL-Prüfung vom Typ Content-Change (§2.4.4), wenn die Inhaltsänderung gerade gespeichert werden soll. Zanzibar kodiert einen aktuellen globalen Zeitstempel im zookie und stellt sicher, dass alle vorherigen ACL-Schreibvorgänge niedrigere Zeitstempel haben. Der Client speichert den zookie zusammen mit der Inhaltsänderung in einem atomaren Schreibvorgang in den Client-Speicher. Man beachte, dass die Content-Change-Prüfung nicht in derselben Transaktion wie die Änderung des Anwendungsinhalts ausgewertet werden muss, sondern lediglich ausgelöst werden muss, wenn der Benutzer die Inhalte ändert.
- Der Client sendet diesen zookie in nachfolgenden ACL-Check-Anfragen mit, um sicherzustellen, dass der Snapshot der Prüfung mindestens so aktuell ist wie der Zeitstempel der Inhaltsversion.
External consistency and snapshot reads with staleness bounded by zookie prevent the “new enemy” problem. In Example A, ACL updates A1 and A2 will be assigned timestamps , respectively. Bob will not be able to see the new documents added by Charlie: if a check is evaluated at , the document ACLs will not include the folder ACL; if a check is evaluated at , the check will observe update A1, which removed Bob from the folder ACL. In Example B, Bob will not see the new contents added to the document. For Bob to see the new contents, the check must be evaluated with a zookie , the timestamp assigned to the content update. Because , such a check will also observe the ACL update B1, which removed Bob from the ACL.
Externe Konsistenz und Snapshot-Lesevorgänge mit durch den zookie begrenzter Veraltung verhindern das „New Enemy“-Problem. In Beispiel A werden den ACL-Aktualisierungen A1 und A2 jeweils die Zeitstempel zugewiesen. Bob wird die von Charlie hinzugefügten neuen Dokumente nicht sehen können: Wird eine Prüfung zu ausgewertet, enthalten die Dokument-ACLs die Ordner-ACL nicht; wird eine Prüfung zu ausgewertet, beobachtet die Prüfung die Aktualisierung A1, die Bob aus der Ordner-ACL entfernt hat. In Beispiel B wird Bob die dem Dokument hinzugefügten neuen Inhalte nicht sehen. Damit Bob die neuen Inhalte sieht, muss die Prüfung mit einem zookie ausgewertet werden, dem der Inhaltsaktualisierung zugewiesenen Zeitstempel. Da gilt, beobachtet eine solche Prüfung auch die ACL-Aktualisierung B1, die Bob aus der ACL entfernt hat.
The zookie protocol is a key feature of Zanzibar’s consistency model. It ensures that Zanzibar respects causal ordering between ACL and content updates, but otherwise grants Zanzibar freedom to choose evaluation timestamps so as to meet its latency and availability goals. The freedom arises from the protocol’s at-least-as-fresh semantics, which allow Zanzibar to choose any timestamp fresher than the one encoded in a zookie. Such freedom in turn allows Zanzibar to serve most checks at a default staleness with already replicated data (§3.2.1) and to quantize evaluation timestamps to avoid hot spots (§3.2.5).
Das zookie-Protokoll ist ein zentrales Merkmal des Konsistenzmodells von Zanzibar. Es stellt sicher, dass Zanzibar die kausale Reihenfolge zwischen ACL- und Inhaltsaktualisierungen respektiert, gewährt Zanzibar aber ansonsten die Freiheit, Auswertungszeitstempel so zu wählen, dass seine Latenz- und Verfügbarkeitsziele erreicht werden. Diese Freiheit ergibt sich aus der „mindestens so aktuell“-Semantik des Protokolls, die es Zanzibar erlaubt, jeden Zeitstempel zu wählen, der aktueller ist als der in einem zookie kodierte. Diese Freiheit wiederum erlaubt es Zanzibar, die meisten Prüfungen mit einer Standard-Veraltung auf bereits replizierten Daten zu bedienen (§3.2.1) und Auswertungszeitstempel zu quantisieren, um Hotspots zu vermeiden (§3.2.5).
Before clients can store relation tuples in Zanzibar, they must configure their namespaces. A namespace configuration specifies its relations as well as its storage parameters. Each relation has a name, which is a client-defined string such as viewer or editor, and a relation config. Storage parameters include sharding settings and an encoding for object IDs that helps Zanzibar optimize storage of integer, string, and other object ID formats.
Bevor Clients Relationstupel in Zanzibar speichern können, müssen sie ihre Namespaces konfigurieren. Eine Namespace-Konfiguration spezifiziert ihre Relationen sowie ihre Speicherparameter. Jede Relation hat einen Namen, einen vom Client definierten String wie viewer oder editor, und eine Relationskonfiguration. Zu den Speicherparametern gehören Sharding-Einstellungen und eine Kodierung für Objekt-IDs, die Zanzibar hilft, die Speicherung von Integer-, String- und anderen Objekt-ID-Formaten zu optimieren.
While relation tuples reflect relationships between objects and users, they do not completely define the effective ACLs. For example, some clients specify that users with editor permissions on each object should have viewer permission on the same object. While such relationships between relations can be represented by a relation tuple per object, storing a tuple for each object in a namespace would be wasteful and make it hard to make modifications across all objects. Instead, we let clients define object-agnostic relationships via userset rewrite rules in relation configs. Figure 1 demonstrates a simple namespace configuration with concentric relations, where viewer contains editor, and editor contains owner.
Obwohl Relationstupel Beziehungen zwischen Objekten und Benutzern widerspiegeln, definieren sie die effektiven ACLs nicht vollständig. Beispielsweise legen einige Clients fest, dass Benutzer mit editor-Berechtigungen für jedes Objekt die viewer-Berechtigung für dasselbe Objekt haben sollen. Zwar ließen sich solche Beziehungen zwischen Relationen durch ein Relationstupel pro Objekt darstellen, doch ein Tupel für jedes Objekt in einem Namespace zu speichern, wäre verschwenderisch und würde Änderungen über alle Objekte hinweg erschweren. Stattdessen lassen wir Clients objektunabhängige Beziehungen über Userset-Umschreibregeln in Relationskonfigurationen definieren. Abbildung 1 zeigt eine einfache Namespace-Konfiguration mit konzentrischen Relationen, wobei viewer editor enthält und editor owner enthält.
Figure 1: Simple namespace configuration with concentric relations on documents. All owners are editors, and all editors are viewers. Further, viewers of the parent folder are also viewers of the document.
Abbildung 1: Einfache Namespace-Konfiguration mit konzentrischen Relationen auf Dokumenten. Alle Eigentümer sind Bearbeiter, und alle Bearbeiter sind Betrachter. Darüber hinaus sind Betrachter des übergeordneten Ordners auch Betrachter des Dokuments.
Userset rewrite rules are defined per relation in a namespace. Each rule specifies a function that takes an object ID as input and outputs a userset expression tree. Each leaf node of the tree can be any of the following:
Userset-Umschreibregeln werden pro Relation in einem Namespace definiert. Jede Regel spezifiziert eine Funktion, die eine Objekt-ID als Eingabe nimmt und einen Userset-Ausdrucksbaum ausgibt. Jeder Blattknoten des Baums kann eines der Folgenden sein:
_this: Returns all users from stored relation tuples for the ⟨object#relation⟩ pair, including indirect ACLs referenced by usersets from the tuples. This is the default behavior when no rewrite rule is specified.computed_userset: Computes, for the input object, a new userset. For example, this allows the userset expression for aviewerrelation to refer to theeditoruserset on the same object, thus offering an ACL inheritance capability between relations.tuple_to_userset: Computes a tupleset (§2.4.1) from the input object, fetches relation tuples matching the tupleset, and computes a userset from every fetched relation tuple. This flexible primitive allows our clients to express complex policies such as “look up the parent folder of the document and inherit its viewers”.
_this: Gibt alle Benutzer aus gespeicherten Relationstupeln für das Paar ⟨object#relation⟩ zurück, einschließlich indirekter ACLs, auf die Usersets aus den Tupeln verweisen. Dies ist das Standardverhalten, wenn keine Umschreibregel angegeben ist.computed_userset: Berechnet für das Eingabeobjekt ein neues Userset. Dies erlaubt es beispielsweise dem Userset-Ausdruck für eineviewer-Relation, auf daseditor-Userset desselben Objekts zu verweisen, und bietet so eine ACL-Vererbung zwischen Relationen.tuple_to_userset: Berechnet aus dem Eingabeobjekt eine Tupelmenge (§2.4.1), ruft die zur Tupelmenge passenden Relationstupel ab und berechnet aus jedem abgerufenen Relationstupel ein Userset. Dieses flexible Primitiv erlaubt es unseren Clients, komplexe Richtlinien auszudrücken, etwa „ermittle den übergeordneten Ordner des Dokuments und erbe dessen Betrachter“.
A userset expression can also be composed of multiple sub-expressions, combined by operations such as union, intersection, and exclusion.
Ein Userset-Ausdruck kann auch aus mehreren Teilausdrücken zusammengesetzt sein, die durch Operationen wie Vereinigung, Schnittmenge und Ausschluss kombiniert werden.
In addition to supporting ACL checks, Zanzibar also provides APIs for clients to read and write relation tuples, watch tuple updates, and inspect the effective ACLs.
Zusätzlich zur Unterstützung von ACL-Prüfungen stellt Zanzibar Clients auch APIs bereit, um Relationstupel zu lesen und zu schreiben, Tupelaktualisierungen zu beobachten und die effektiven ACLs zu inspizieren.
A concept used throughout these API methods is that of a zookie. A zookie is an opaque byte sequence encoding a globally meaningful timestamp that reflects an ACL write, a client content version, or a read snapshot. Zookies in ACL read and check requests specify staleness bounds for snapshot reads, thus providing one of Zanzibar’s core consistency properties. We choose to use an opaque cookie instead of the actual timestamp to discourage our clients from choosing arbitrary timestamps and to allow future extensions.
Ein Konzept, das in all diesen API-Methoden verwendet wird, ist das des zookie. Ein zookie ist eine opake Bytefolge, die einen global aussagekräftigen Zeitstempel kodiert, der einen ACL-Schreibvorgang, eine Inhaltsversion des Clients oder einen Lese-Snapshot widerspiegelt. Zookies in ACL-Lese- und Check-Anfragen spezifizieren Veraltungsgrenzen für Snapshot-Lesevorgänge und stellen damit eine der zentralen Konsistenzeigenschaften von Zanzibar bereit. Wir haben uns entschieden, ein opakes Cookie anstelle des tatsächlichen Zeitstempels zu verwenden, um unsere Clients davon abzuhalten, beliebige Zeitstempel zu wählen, und um zukünftige Erweiterungen zu ermöglichen.
Our clients read relation tuples to display ACLs or group membership to users, or to prepare for a subsequent write. A read request specifies one or multiple tuplesets and an optional zookie.
Unsere Clients lesen Relationstupel, um Benutzern ACLs oder Gruppenmitgliedschaften anzuzeigen oder um einen nachfolgenden Schreibvorgang vorzubereiten. Eine Read-Anfrage spezifiziert eine oder mehrere Tupelmengen und optional einen zookie.
Each tupleset specifies keys of a set of relation tuples. The set can include a single tuple key, or all tuples with a given object ID or userset in a namespace, optionally constrained by a relation name. With the tuplesets, clients can look up a specific membership entry, read all entries in an ACL or group, or look up all groups with a given user as a direct member. All tuplesets in a read request are processed at a single snapshot.
Jede Tupelmenge spezifiziert Schlüssel einer Menge von Relationstupeln. Die Menge kann einen einzelnen Tupelschlüssel umfassen oder alle Tupel mit einer gegebenen Objekt-ID oder einem gegebenen Userset in einem Namespace, optional eingeschränkt durch einen Relationsnamen. Mit den Tupelmengen können Clients einen bestimmten Mitgliedschaftseintrag nachschlagen, alle Einträge einer ACL oder Gruppe lesen oder alle Gruppen nachschlagen, in denen ein gegebener Benutzer direktes Mitglied ist. Alle Tupelmengen einer Read-Anfrage werden auf einem einzigen Snapshot verarbeitet.
With the zookie, clients can request a read snapshot no earlier than a previous write if the zookie from the write response is given in the read request, or at the same snapshot as a previous read if the zookie from the earlier read response is given in the subsequent request. If the request doesn’t contain a zookie, Zanzibar will choose a reasonably recent snapshot, possibly offering a lower-latency response than if a zookie were provided.
Mit dem zookie können Clients einen Lese-Snapshot anfordern, der nicht früher als ein vorheriger Schreibvorgang liegt, wenn der zookie aus der Schreibantwort in der Read-Anfrage angegeben wird, oder denselben Snapshot wie ein vorheriger Lesevorgang, wenn der zookie aus der früheren Leseantwort in der nachfolgenden Anfrage angegeben wird. Enthält die Anfrage keinen zookie, wählt Zanzibar einen hinreichend aktuellen Snapshot und bietet damit möglicherweise eine Antwort mit geringerer Latenz, als wenn ein zookie angegeben worden wäre.
Read results only depend on contents of relation tuples and do not reflect userset rewrite rules. For example, even if the viewer userset always includes the owner userset, reading tuples with the viewer relation will not return tuples with the owner relation. Clients that need to understand the effective userset can use the Expand API (§2.4.5).
Leseergebnisse hängen nur vom Inhalt der Relationstupel ab und spiegeln keine Userset-Umschreibregeln wider. Selbst wenn beispielsweise das viewer-Userset stets das owner-Userset einschließt, liefert das Lesen von Tupeln mit der viewer-Relation keine Tupel mit der owner-Relation. Clients, die das effektive Userset kennen müssen, können die Expand-API verwenden (§2.4.5).
Clients may modify a single relation tuple to add or remove an ACL. They may also modify all tuples related to an object via a read-modify-write process with optimistic concurrency control [21] that uses a read RPC followed by a write RPC:
Clients können ein einzelnes Relationstupel ändern, um eine ACL hinzuzufügen oder zu entfernen. Sie können außerdem alle zu einem Objekt gehörenden Tupel über einen Read-Modify-Write-Prozess mit optimistischer Nebenläufigkeitskontrolle [21] ändern, der einen Lese-RPC gefolgt von einem Schreib-RPC verwendet:
- Read all relation tuples of an object, including a per-object “lock” tuple.
- Generate the tuples to write or delete. Send the writes, along with a touch on the lock tuple, to Zanzibar, with the condition that the writes will be committed only if the lock tuple has not been modified since the read.
- If the write condition is not met, go back to step 1.
- Alle Relationstupel eines Objekts lesen, einschließlich eines „Lock“-Tupels pro Objekt.
- Die zu schreibenden oder zu löschenden Tupel erzeugen. Die Schreibvorgänge zusammen mit einem Touch auf das Lock-Tupel an Zanzibar senden, mit der Bedingung, dass die Schreibvorgänge nur committet werden, wenn das Lock-Tupel seit dem Lesen nicht verändert wurde.
- Ist die Schreibbedingung nicht erfüllt, zurück zu Schritt 1.
The lock tuple is just a regular relation tuple used by clients to detect write races.
Das Lock-Tupel ist lediglich ein reguläres Relationstupel, das Clients verwenden, um Schreib-Races zu erkennen.
Some clients maintain secondary indices of relation tuples in Zanzibar. They can do so with our Watch API. A watch request specifies one or more namespaces and a zookie representing the time to start watching. A watch response contains all tuple modification events in ascending timestamp order, from the requested start timestamp to a timestamp encoded in a heartbeat zookie included in the watch response. The client can use the heartbeat zookie to resume watching where the previous watch response left off.
Einige Clients pflegen Sekundärindizes der Relationstupel in Zanzibar. Dies können sie mit unserer Watch-API tun. Eine Watch-Anfrage spezifiziert einen oder mehrere Namespaces und einen zookie, der den Zeitpunkt angibt, ab dem beobachtet werden soll. Eine Watch-Antwort enthält alle Tupeländerungsereignisse in aufsteigender Zeitstempelreihenfolge, vom angeforderten Startzeitstempel bis zu einem Zeitstempel, der in einem Heartbeat-zookie kodiert ist, welcher in der Watch-Antwort enthalten ist. Der Client kann den Heartbeat-zookie verwenden, um die Beobachtung dort fortzusetzen, wo die vorherige Watch-Antwort aufgehört hat.
A check request specifies a userset, represented by ⟨object#relation⟩, a putative user, often represented by an authentication token, and a zookie corresponding to the desired object version. Like reads, a check is always evaluated at a consistent snapshot no earlier than the given zookie.
Eine Check-Anfrage spezifiziert ein Userset, dargestellt durch ⟨object#relation⟩, einen mutmaßlichen Benutzer, der oft durch ein Authentifizierungstoken dargestellt wird, und einen zookie, der der gewünschten Objektversion entspricht. Wie Lesevorgänge wird ein Check stets auf einem konsistenten Snapshot ausgewertet, der nicht früher als der angegebene zookie liegt.
To authorize application content modifications, our clients send a special type of check request, a content-change check. A content-change check request does not carry a zookie and is evaluated at the latest snapshot. If a content change is authorized, the check response includes a zookie for clients to store along with object contents and use for subsequent checks of the content version. The zookie encodes the evaluation snapshot and captures any possible causality from ACL changes to content changes, because the zookie’s timestamp will be greater than that of the ACL updates that protect the new content (§2.2).
Um Änderungen an Anwendungsinhalten zu autorisieren, senden unsere Clients eine spezielle Art von Check-Anfrage, eine Content-Change-Prüfung. Eine Content-Change-Check-Anfrage trägt keinen zookie und wird auf dem neuesten Snapshot ausgewertet. Wird eine Inhaltsänderung autorisiert, enthält die Check-Antwort einen zookie, den Clients zusammen mit den Objektinhalten speichern und für nachfolgende Prüfungen der Inhaltsversion verwenden. Der zookie kodiert den Auswertungs-Snapshot und erfasst jede mögliche Kausalität von ACL-Änderungen zu Inhaltsänderungen, da der Zeitstempel des zookie größer ist als der der ACL-Aktualisierungen, die den neuen Inhalt schützen (§2.2).
The Expand API returns the effective userset given an ⟨object#relation⟩ pair and an optional zookie. Unlike the Read API, Expand follows indirect references expressed through userset rewrite rules. The result is represented by a userset tree whose leaf nodes are user IDs or usersets pointing to other ⟨object#relation⟩ pairs, and intermediate nodes represent union, intersection, or exclusion operators. Expand is crucial for our clients to reason about the complete set of users and groups that have access to their objects, which allows them to build efficient search indices for access-controlled content.
Die Expand-API gibt zu einem Paar ⟨object#relation⟩ und einem optionalen zookie das effektive Userset zurück. Anders als die Read-API folgt Expand indirekten Verweisen, die über Userset-Umschreibregeln ausgedrückt sind. Das Ergebnis wird durch einen Userset-Baum dargestellt, dessen Blattknoten Benutzer-IDs oder Usersets sind, die auf andere Paare ⟨object#relation⟩ verweisen, und dessen Zwischenknoten Vereinigungs-, Schnittmengen- oder Ausschlussoperatoren darstellen. Expand ist für unsere Clients entscheidend, um die vollständige Menge der Benutzer und Gruppen nachzuvollziehen, die Zugriff auf ihre Objekte haben, was es ihnen ermöglicht, effiziente Suchindizes für zugriffskontrollierte Inhalte aufzubauen.
Figure 2 shows the architecture of the Zanzibar system. aclservers are the main server type. They are organized in clusters and respond to Check, Read, Expand, and Write requests. Requests arrive at any server in a cluster and that server fans out the work to other servers in the cluster as necessary. Those servers may in turn contact other servers to compute intermediate results. The initial server gathers the final result and returns it to the client.
Abbildung 2 zeigt die Architektur des Zanzibar-Systems. aclservers sind der wichtigste Servertyp. Sie sind in Clustern organisiert und beantworten Check-, Read-, Expand- und Write-Anfragen. Anfragen treffen bei einem beliebigen Server eines Clusters ein, und dieser Server fächert die Arbeit bei Bedarf auf andere Server im Cluster auf. Diese Server können ihrerseits andere Server kontaktieren, um Zwischenergebnisse zu berechnen. Der ursprüngliche Server sammelt das Endergebnis und gibt es an den Client zurück.
Zanzibar stores ACLs and their metadata in Spanner databases. There is one database to store relation tuples for each client namespace, one database to hold all namespace configurations, and one changelog database shared across all namespaces. aclservers read and write those databases in the course of responding to client requests.
Zanzibar speichert ACLs und ihre Metadaten in Spanner-Datenbanken. Es gibt eine Datenbank zur Speicherung der Relationstupel für jeden Client-Namespace, eine Datenbank für alle Namespace-Konfigurationen und eine über alle Namespaces hinweg gemeinsam genutzte Changelog-Datenbank. aclservers lesen und schreiben diese Datenbanken bei der Beantwortung von Client-Anfragen.
watchservers are a specialized server type that respond to Watch requests. They tail the changelog and serve a stream of namespace changes to clients in near real time.
watchservers sind ein spezialisierter Servertyp, der Watch-Anfragen beantwortet. Sie verfolgen das Ende des Änderungsprotokolls (Changelog) und liefern Clients nahezu in Echtzeit einen Strom von Namespace-Änderungen.
Zanzibar periodically runs a data processing pipeline to perform a variety of offline functions across all Zanzibar data in Spanner. One such function is to produce dumps of the relation tuples in each namespace at a known snapshot timestamp. Another is to garbage-collect tuple versions older than a threshold configured per namespace.
Zanzibar führt periodisch eine Datenverarbeitungspipeline aus, um eine Vielzahl von Offline-Funktionen über alle Zanzibar-Daten in Spanner hinweg auszuführen. Eine solche Funktion ist das Erstellen von Dumps der Relationstupel in jedem Namespace zu einem bekannten Snapshot-Zeitstempel. Eine andere ist die Garbage Collection von Tupelversionen, die älter als ein pro Namespace konfigurierter Schwellenwert sind.
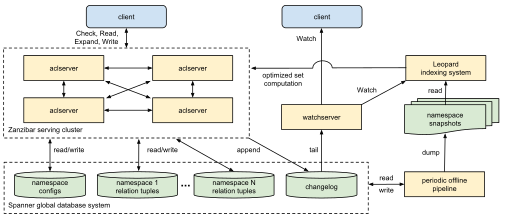
Figure 2: Zanzibar architecture. Arrows indicate the direction of data flow.
Abbildung 2: Architektur von Zanzibar. Pfeile geben die Richtung des Datenflusses an.
Leopard is an indexing system used to optimize operations on large and deeply nested sets. It reads periodic snapshots of ACL data and watches for changes between snapshots. It performs transformations on that data, such as denormalization, and responds to requests from aclservers.
Leopard ist ein Indexierungssystem, das dazu dient, Operationen auf großen und tief verschachtelten Mengen zu optimieren. Es liest periodische Snapshots der ACL-Daten und beobachtet Änderungen zwischen den Snapshots. Es führt Transformationen auf diesen Daten durch, etwa Denormalisierung, und beantwortet Anfragen von aclservers.
The rest of this section presents the implementation of these architectural elements in more detail.
Der Rest dieses Abschnitts stellt die Implementierung dieser Architekturelemente ausführlicher vor.
We store relation tuples of each namespace in a separate database, where each row is identified by primary key (shard ID, object ID, relation, user, commit timestamp). Multiple tuple versions are stored on different rows, so that we can evaluate checks and reads at any timestamp within the garbage collection window. The ordering of primary keys allows us to look up all relation tuples for a given object ID or (object ID, relation) pair.
Wir speichern die Relationstupel jedes Namespace in einer separaten Datenbank, in der jede Zeile durch den Primärschlüssel (Shard-ID, Objekt-ID, Relation, Benutzer, Commit-Zeitstempel) identifiziert wird. Mehrere Tupelversionen werden in verschiedenen Zeilen gespeichert, sodass wir Prüfungen und Lesevorgänge zu jedem Zeitstempel innerhalb des Garbage-Collection-Fensters auswerten können. Die Ordnung der Primärschlüssel erlaubt es uns, alle Relationstupel für eine gegebene Objekt-ID oder ein gegebenes Paar (Objekt-ID, Relation) nachzuschlagen.
Our clients configure sharding of a namespace according to its data pattern. Usually the shard ID is determined solely by the object ID. In some cases, for example, when a namespace stores groups with very large numbers of members, the shard ID is computed from both object ID and user.
Unsere Clients konfigurieren das Sharding eines Namespace entsprechend seinem Datenmuster. Üblicherweise wird die Shard-ID allein durch die Objekt-ID bestimmt. In einigen Fällen, beispielsweise wenn ein Namespace Gruppen mit sehr großen Mitgliederzahlen speichert, wird die Shard-ID sowohl aus der Objekt-ID als auch aus dem Benutzer berechnet.
Zanzibar also maintains a changelog database that stores a history of tuple updates for the Watch API. The primary keys are (changelog shard ID, timestamp, unique update ID), where a changelog shard is randomly selected for each write.
Zanzibar pflegt außerdem eine Changelog-Datenbank, die einen Verlauf der Tupelaktualisierungen für die Watch-API speichert. Die Primärschlüssel sind (Changelog-Shard-ID, Zeitstempel, eindeutige Update-ID), wobei für jeden Schreibvorgang zufällig ein Changelog-Shard ausgewählt wird.
Every Zanzibar write is committed to both the tuple storage and the changelog shard in a single transaction. We designate the Spanner server hosting the changelog shard as the transaction coordinator to minimize blocking of changelog reads on pending transactions.
Jeder Zanzibar-Schreibvorgang wird in einer einzigen Transaktion sowohl in den Tupelspeicher als auch in den Changelog-Shard committet. Wir bestimmen den Spanner-Server, der den Changelog-Shard hostet, als Transaktionskoordinator, um das Blockieren von Changelog-Lesevorgängen durch ausstehende Transaktionen zu minimieren.
Namespace configs are stored in a database with two tables. One table contains the configs and is keyed by namespace IDs. The other is a changelog of config updates and is keyed by commit timestamps. This structure allows a Zanzibar server to load all configs upon startup and monitor the changelog to refresh configs continuously.
Namespace-Konfigurationen werden in einer Datenbank mit zwei Tabellen gespeichert. Eine Tabelle enthält die Konfigurationen und ist nach Namespace-IDs indiziert. Die andere ist ein Changelog der Konfigurationsaktualisierungen und ist nach Commit-Zeitstempeln indiziert. Diese Struktur erlaubt es einem Zanzibar-Server, beim Start alle Konfigurationen zu laden und das Changelog zu überwachen, um die Konfigurationen kontinuierlich zu aktualisieren.
To reduce latency, Zanzibar data is replicated to be close to our clients. Replicas exist in dozens of locations around the world, with multiple replicas per region. The 5 voting replicas are in eastern and central United States, in 3 different metropolitan areas to isolate failures but within 25 milliseconds of each other so that Paxos transactions commit quickly.
Um die Latenz zu verringern, werden Zanzibar-Daten so repliziert, dass sie nahe bei unseren Clients liegen. Replikate existieren an Dutzenden von Standorten weltweit, mit mehreren Replikaten pro Region. Die 5 stimmberechtigten Replikate befinden sich im Osten und in der Mitte der Vereinigten Staaten, in 3 verschiedenen Ballungsräumen, um Ausfälle zu isolieren, aber innerhalb von 25 Millisekunden voneinander, damit Paxos-Transaktionen schnell committet werden.
As noted in §2.4, clients can provide zookies to ensure a minimum snapshot timestamp for request evaluation. When a zookie is not provided, the server uses a default staleness chosen to ensure that all transactions are evaluated at a timestamp that is as recent as possible without impacting latency.
Wie in §2.4 erwähnt, können Clients zookies angeben, um einen minimalen Snapshot-Zeitstempel für die Auswertung einer Anfrage sicherzustellen. Wird kein zookie angegeben, verwendet der Server eine Standard-Veraltung, die so gewählt ist, dass alle Transaktionen zu einem Zeitstempel ausgewertet werden, der so aktuell wie möglich ist, ohne die Latenz zu beeinträchtigen.
On each read request it makes to Spanner, Zanzibar receives a hint about whether or not the data at that timestamp required an out-of-zone read and thus incurred additional latency. Each server tracks the frequency of such out-of-zone reads for data at a default staleness as well as for fresher and staler data, and uses these frequencies to compute a binomial proportion confidence interval of the probability that any given piece of data is available locally at each staleness.
Bei jeder Leseanfrage, die Zanzibar an Spanner stellt, erhält es einen Hinweis darauf, ob die Daten zu diesem Zeitstempel einen zonenübergreifenden Lesevorgang erforderten und somit zusätzliche Latenz verursachten. Jeder Server verfolgt die Häufigkeit solcher zonenübergreifenden Lesevorgänge für Daten mit Standard-Veraltung sowie für aktuellere und ältere Daten und verwendet diese Häufigkeiten, um ein Konfidenzintervall für einen Binomialanteil zu berechnen, das die Wahrscheinlichkeit angibt, dass ein beliebiges Datum bei der jeweiligen Veraltung lokal verfügbar ist.
Upon collecting enough data, the server checks to see if each staleness value has a sufficiently low probability of incurring an out-of-zone read, and thus will be low-latency. If so, it updates the default staleness bound to the lowest “safe” value. If no known staleness values are safe, we use a two-proportion z-test to see if increasing the default will be a statistically significant amount safer. In that case, we increase the default value in the hopes of improving latency. This default staleness mechanism is purely a performance optimization. It does not violate consistency semantics because Zanzibar always respects zookies when provided.
Nachdem genügend Daten gesammelt wurden, prüft der Server, ob jeder Veraltungswert eine hinreichend geringe Wahrscheinlichkeit hat, einen zonenübergreifenden Lesevorgang zu verursachen, und somit eine niedrige Latenz aufweisen wird. Ist dies der Fall, setzt er die Standard-Veraltungsgrenze auf den niedrigsten „sicheren“ Wert. Ist keiner der bekannten Veraltungswerte sicher, verwenden wir einen Zwei-Stichproben-z-Test für Anteile, um festzustellen, ob eine Erhöhung des Standardwerts in statistisch signifikantem Maße sicherer wäre. In diesem Fall erhöhen wir den Standardwert in der Hoffnung, die Latenz zu verbessern. Dieser Mechanismus der Standard-Veraltung ist eine reine Leistungsoptimierung. Er verletzt die Konsistenzsemantik nicht, da Zanzibar zookies, sofern angegeben, stets respektiert.
Because changes to namespace configs can change the results of ACL evaluations, and therefore their correctness, Zanzibar chooses a single snapshot timestamp for config metadata when evaluating each client request. All aclservers in a cluster use that same timestamp for the same request, including for any subrequests that fan out from the original client request.
Da Änderungen an Namespace-Konfigurationen die Ergebnisse von ACL-Auswertungen und damit deren Korrektheit verändern können, wählt Zanzibar bei der Auswertung jeder Client-Anfrage einen einzigen Snapshot-Zeitstempel für die Konfigurationsmetadaten. Alle aclservers in einem Cluster verwenden für dieselbe Anfrage denselben Zeitstempel, auch für alle Unteranfragen, die sich aus der ursprünglichen Client-Anfrage auffächern.
Each server independently loads namespace configs from storage continuously as they change (§3.1.3). Therefore, each server in a cluster may have access to a different range of config timestamps due to restarts or network latency. Zanzibar must pick a timestamp that is available across all of them. To facilitate this, a monitoring job tracks the timestamp range available to every server and aggregates them, reporting a globally available range to every other server. On each incoming request the server picks a time from this range, ensuring that all servers can continue serving even if they are no longer able to read from the config storage.
Jeder Server lädt Namespace-Konfigurationen unabhängig und kontinuierlich aus dem Speicher, sobald sie sich ändern (§3.1.3). Daher kann jeder Server in einem Cluster aufgrund von Neustarts oder Netzwerklatenz Zugriff auf einen anderen Bereich von Konfigurationszeitstempeln haben. Zanzibar muss einen Zeitstempel wählen, der auf allen verfügbar ist. Um dies zu erleichtern, verfolgt ein Überwachungsjob den für jeden Server verfügbaren Zeitstempelbereich, aggregiert diese Bereiche und meldet allen anderen Servern einen global verfügbaren Bereich. Bei jeder eingehenden Anfrage wählt der Server einen Zeitpunkt aus diesem Bereich, wodurch sichergestellt wird, dass alle Server weiterhin Anfragen bedienen können, selbst wenn sie nicht mehr aus dem Konfigurationsspeicher lesen können.
Zanzibar evaluates ACL checks by converting check requests to boolean expressions. In a simple case, when there are no userset rewrite rules, checking a user against a userset ⟨object#relation⟩ can be expressed as
Zanzibar wertet ACL-Prüfungen aus, indem es Check-Anfragen in boolesche Ausdrücke umwandelt. Im einfachen Fall, wenn es keine Userset-Umschreibregeln gibt, lässt sich die Prüfung eines Benutzers gegen ein Userset ⟨object#relation⟩ ausdrücken als
Finding a valid involves evaluating membership on all indirect ACLs or groups, recursively. This kind of “pointer chasing” works well for most types of ACLs and groups, but can be expensive when indirect ACLs or groups are deep or wide. §3.2.4 explains how we handle this problem. Userset rewrite rules are also translated to boolean expressions as part of check evaluation.
Ein gültiges zu finden, erfordert die rekursive Auswertung der Mitgliedschaft in allen indirekten ACLs oder Gruppen. Diese Art von „Pointer-Chasing“ funktioniert für die meisten Arten von ACLs und Gruppen gut, kann aber teuer werden, wenn indirekte ACLs oder Gruppen tief oder breit sind. §3.2.4 erläutert, wie wir dieses Problem behandeln. Auch Userset-Umschreibregeln werden im Rahmen der Check-Auswertung in boolesche Ausdrücke übersetzt.
To minimize check latency, we evaluate all leaf nodes of the boolean expression tree concurrently. When the outcome of one node determines the result of a subtree, evaluation of other nodes in the subtree is cancelled.
Um die Latenz von Prüfungen zu minimieren, werten wir alle Blattknoten des booleschen Ausdrucksbaums nebenläufig aus. Wenn das Ergebnis eines Knotens das Ergebnis eines Teilbaums bestimmt, wird die Auswertung der anderen Knoten im Teilbaum abgebrochen.
Evaluation of leaf nodes usually involves reading relation tuples from databases. We apply a pooling mechanism to group reads for the same ACL check to minimize the number of read RPCs to Spanner.
Die Auswertung von Blattknoten erfordert in der Regel das Lesen von Relationstupeln aus Datenbanken. Wir setzen einen Pooling-Mechanismus ein, um Lesevorgänge für dieselbe ACL-Prüfung zu gruppieren und so die Anzahl der Lese-RPCs an Spanner zu minimieren.
Recursive pointer chasing during check evaluation has difficulty maintaining low latency with groups that are deeply nested or have a large number of child groups. For selected namespaces that exhibit such structure, Zanzibar handles checks using Leopard, a specialized index that supports efficient set computation.
Rekursives Pointer-Chasing während der Check-Auswertung hat Schwierigkeiten, bei Gruppen, die tief verschachtelt sind oder eine große Anzahl von Untergruppen haben, eine niedrige Latenz aufrechtzuerhalten. Für ausgewählte Namespaces, die eine solche Struktur aufweisen, behandelt Zanzibar Prüfungen mit Leopard, einem spezialisierten Index, der effiziente Mengenberechnungen unterstützt.
A Leopard index represents a collection of named sets using tuples, where is an enum representing the set type and and are 64-bit integers representing the set ID and the element ID, respectively. A query evaluates an expression of union, intersection, or exclusion of named sets and returns the result set ordered by the element ID up to a specified number of results.
Ein Leopard-Index stellt eine Sammlung benannter Mengen mithilfe von -Tupeln dar, wobei ein Enum ist, das den Mengentyp darstellt, und und 64-Bit-Ganzzahlen sind, die die Mengen-ID bzw. die Element-ID darstellen. Eine Abfrage wertet einen Ausdruck aus Vereinigung, Schnittmenge oder Ausschluss benannter Mengen aus und gibt die nach Element-ID geordnete Ergebnismenge bis zu einer angegebenen Anzahl von Ergebnissen zurück.
To index and evaluate group membership, Zanzibar represents group membership with two set types, and , which we show here as functions mapping from a set ID to element IDs:
Um Gruppenmitgliedschaften zu indexieren und auszuwerten, stellt Zanzibar Gruppenmitgliedschaften mit zwei Mengentypen dar, und , die wir hier als Funktionen zeigen, die eine Mengen-ID auf Element-IDs abbilden:
- , where represents an ancestor group and represents a descendent group that is directly or indirectly a sub-group of the ancestor group.
- , where represents an individual user and represents a parent group in which the user is a direct member.
- , wobei eine Vorfahrengruppe darstellt und eine Nachfahrengruppe, die direkt oder indirekt eine Untergruppe der Vorfahrengruppe ist.
- , wobei einen einzelnen Benutzer darstellt und eine übergeordnete Gruppe, in der der Benutzer direktes Mitglied ist.
To evaluate whether user is a member of group , we check whether
Um auszuwerten, ob Benutzer Mitglied der Gruppe ist, prüfen wir, ob
Group membership can be considered as a reachability problem in a graph, where nodes represent groups and users and edges represent direct membership. Flattening group-to-group paths allows reachability to be efficently evaluated by Leopard, though other types of denormalization can also be applied as data patterns demand.
Gruppenmitgliedschaft lässt sich als Erreichbarkeitsproblem in einem Graphen auffassen, in dem Knoten Gruppen und Benutzer darstellen und Kanten direkte Mitgliedschaften. Das Abflachen von Gruppe-zu-Gruppe-Pfaden erlaubt es Leopard, die Erreichbarkeit effizient auszuwerten, wobei je nach Datenmuster auch andere Arten der Denormalisierung angewendet werden können.
The Leopard system consists of three discrete parts: a serving system capable of consistent and low-latency operations across sets; an offline, periodic index building system; and an online real-time layer capable of continuously updating the serving system as tuple changes occur.
Das Leopard-System besteht aus drei getrennten Teilen: einem Serving-System, das konsistente Operationen mit niedriger Latenz über Mengen hinweg ausführen kann; einem offline arbeitenden, periodischen System zum Aufbau des Index; und einer Online-Echtzeitschicht, die das Serving-System kontinuierlich aktualisieren kann, während Tupeländerungen auftreten.
Index tuples are stored as ordered lists of integers in a structure such as a skip list, thus allowing for efficient union and intersections among sets. For example, evaluating the intersection between two sets, and , requires only skip-list seeks. The index is sharded by element IDs and can be distributed across multiple servers. Shards are usually served entirely from memory, but they can also be served from a mix of hot and cold data spread between memory and remote solid-state devices.
Indextupel werden als geordnete Listen von Ganzzahlen in einer Struktur wie einer Skip-Liste gespeichert, was effiziente Vereinigungen und Schnittmengen zwischen Mengen ermöglicht. Beispielsweise erfordert die Auswertung der Schnittmenge zweier Mengen und nur Skip-Listen-Suchschritte. Der Index ist nach Element-IDs geshardet und kann auf mehrere Server verteilt werden. Shards werden üblicherweise vollständig aus dem Arbeitsspeicher bedient, können aber auch aus einer Mischung heißer und kalter Daten bedient werden, die über Arbeitsspeicher und entfernte Solid-State-Speichergeräte verteilt sind.
The offline index builder generates index shards from a snapshot of Zanzibar relation tuples and configs, and replicates the shards globally. It respects userset rewrite rules and recursively expands edges in an ACL graph to form Leopard index tuples. The Leopard servers continously watch for new shards and swap old shards with new ones when they become available.
Der Offline-Index-Builder erzeugt Index-Shards aus einem Snapshot der Zanzibar-Relationstupel und -Konfigurationen und repliziert die Shards global. Er respektiert Userset-Umschreibregeln und expandiert Kanten in einem ACL-Graphen rekursiv, um Leopard-Indextupel zu bilden. Die Leopard-Server beobachten kontinuierlich, ob neue Shards vorliegen, und tauschen alte Shards gegen neue aus, sobald diese verfügbar werden.
The Leopard system described thus far is able to efficiently evaluate deeply and widely nested group membership, but cannot do so at a fresh and consistent snapshot due to offline index generation and shard swapping. To support consistent ACL evaluation, Leopard servers maintain an incremental layer that indexes all updates since the offline snapshot, where each update is represented by a tuple, where is the timestamp of the update and is a deletion marker. Updates with timestamps less than or equal to the query timestamp are merged on top of the offline index during query processing.
Das bisher beschriebene Leopard-System kann tief und breit verschachtelte Gruppenmitgliedschaften effizient auswerten, dies jedoch aufgrund der Offline-Indexerzeugung und des Austauschs von Shards nicht auf einem aktuellen und konsistenten Snapshot. Um eine konsistente ACL-Auswertung zu unterstützen, pflegen Leopard-Server eine inkrementelle Schicht, die alle Aktualisierungen seit dem Offline-Snapshot indexiert, wobei jede Aktualisierung durch ein -Tupel dargestellt wird, in dem der Zeitstempel der Aktualisierung und eine Löschmarkierung ist. Aktualisierungen mit Zeitstempeln kleiner oder gleich dem Abfragezeitstempel werden während der Abfrageverarbeitung über den Offline-Index gelegt und mit ihm zusammengeführt.
To maintain the incremental layer, the Leopard incremental indexer calls Zanzibar’s Watch API to receive a temporally ordered stream of Zanzibar tuple modifications and transforms the updates into a temporally ordered stream of Leopard tuple additions, updates, and deletions. Generating updates for the tuples requires the incremental indexer to maintain group-to-group membership for denormalizing the effects of a relation tuple update to potentially multiple index updates.
Um die inkrementelle Schicht zu pflegen, ruft der inkrementelle Indexer von Leopard die Watch-API von Zanzibar auf, um einen zeitlich geordneten Strom von Zanzibar-Tupeländerungen zu empfangen, und transformiert die Aktualisierungen in einen zeitlich geordneten Strom von Hinzufügungen, Aktualisierungen und Löschungen von Leopard-Tupeln. Das Erzeugen von Aktualisierungen für die -Tupel erfordert, dass der inkrementelle Indexer die Gruppe-zu-Gruppe-Mitgliedschaften pflegt, um die Auswirkungen einer Relationstupel-Aktualisierung auf potenziell mehrere Indexaktualisierungen zu denormalisieren.
In practice, a single Zanzibar tuple addition or deletion may yield potentially tens of thousands of discrete Leopard tuple events. Each Leopard serving instance receives the complete stream of these Zanzibar tuple changes through the Watch API. The Leopard serving system is designed to continuously ingest this stream and update its various posting lists with minimal impact to query serving.
In der Praxis kann eine einzige Hinzufügung oder Löschung eines Zanzibar-Tupels potenziell Zehntausende einzelner Leopard-Tupelereignisse nach sich ziehen. Jede Leopard-Serving-Instanz erhält über die Watch-API den vollständigen Strom dieser Zanzibar-Tupeländerungen. Das Leopard-Serving-System ist darauf ausgelegt, diesen Strom kontinuierlich aufzunehmen und seine verschiedenen Posting-Listen mit minimalen Auswirkungen auf die Beantwortung von Abfragen zu aktualisieren.
The workload of ACL reads and checks is often bursty and subject to hot spots. For example, answering a search query requires conducting ACL checks for all candidate results, whose ACLs often share common groups or indirect ACLs. To facilitate consistency, Zanzibar avoids storage denormalization and relies only on normalized data (except for the cases described in §3.2.4). With normalized data, hot spots on common ACLs (e.g., popular groups) may overload the underlying database servers. We found the handling of hot spots to be the most critical frontier in our pursuit of low latency and high availability.
Die Last aus ACL-Lesevorgängen und -Prüfungen tritt oft stoßweise auf und ist anfällig für Hotspots. Beispielsweise erfordert die Beantwortung einer Suchanfrage ACL-Prüfungen für alle Kandidatenergebnisse, deren ACLs häufig gemeinsame Gruppen oder indirekte ACLs teilen. Um Konsistenz zu erleichtern, vermeidet Zanzibar eine Denormalisierung im Speicher und stützt sich nur auf normalisierte Daten (mit Ausnahme der in §3.2.4 beschriebenen Fälle). Bei normalisierten Daten können Hotspots auf gemeinsam genutzten ACLs (z. B. populären Gruppen) die zugrunde liegenden Datenbankserver überlasten. Wir haben festgestellt, dass der Umgang mit Hotspots die kritischste Front in unserem Streben nach niedriger Latenz und hoher Verfügbarkeit ist.
Zanzibar servers in each cluster form a distributed cache for both reads and check evaluations, including intermediate check results evaluated during pointer chasing. Cache entries are distributed across Zanzibar servers with consistent hashing [20]. To process checks or reads, we fan out requests to the corresponding Zanzibar servers via an internal RPC interface. To minimize the number of internal RPCs, for most namespaces we compute the forwarding key from the object ID, since processing a check on ⟨object#relation⟩ often involves indirect ACL checks on other relations of the same object and reading relation tuples of the object. These checks and reads can be processed by the same server since they share the same forwarding key with the parent check request. To handle hot forwarding keys, we cache results at both the caller and the callee of internal RPCs, effectively forming cache trees. We also use Slicer [12] to help distribute hot keys to multiple servers.
Die Zanzibar-Server in jedem Cluster bilden einen verteilten Cache sowohl für Lesevorgänge als auch für Check-Auswertungen, einschließlich Zwischenergebnissen von Prüfungen, die während des Pointer-Chasing ausgewertet werden. Cache-Einträge werden mittels Consistent Hashing [20] auf die Zanzibar-Server verteilt. Um Prüfungen oder Lesevorgänge zu verarbeiten, fächern wir Anfragen über eine interne RPC-Schnittstelle an die entsprechenden Zanzibar-Server auf. Um die Anzahl interner RPCs zu minimieren, berechnen wir für die meisten Namespaces den Weiterleitungsschlüssel aus der Objekt-ID, da die Verarbeitung einer Prüfung auf ⟨object#relation⟩ oft indirekte ACL-Prüfungen auf anderen Relationen desselben Objekts und das Lesen von Relationstupeln des Objekts umfasst. Diese Prüfungen und Lesevorgänge können vom selben Server verarbeitet werden, da sie denselben Weiterleitungsschlüssel wie die übergeordnete Check-Anfrage haben. Um heiße Weiterleitungsschlüssel zu behandeln, cachen wir Ergebnisse sowohl beim Aufrufer als auch beim Aufgerufenen interner RPCs und bilden so effektiv Cache-Bäume. Wir verwenden außerdem Slicer [12], um heiße Schlüssel auf mehrere Server zu verteilen.
We avoid reusing results evaluated from a different snapshot by encoding snapshot timestamps in cache keys. We choose evaluation timestamps rounded up to a coarse granularity, such as one or ten seconds, while respecting staleness constraints from request zookies. This timestamp quantization allows the vast majority of recent checks and reads to be evaluated at the same timestamps and to share cache results, despite having microsecond-resolution timestamps in cache keys. It is worth noting that rounding up timestamps does not affect Zanzibar’s consistency properties, since Spanner ensures that a snapshot read at timestamp will observe all writes up to —this holds even if is in the future, in which case the read will wait until TrueTime has moved past .
Wir vermeiden die Wiederverwendung von Ergebnissen, die auf einem anderen Snapshot ausgewertet wurden, indem wir Snapshot-Zeitstempel in Cache-Schlüssel kodieren. Wir wählen Auswertungszeitstempel, die auf eine grobe Granularität aufgerundet sind, etwa eine oder zehn Sekunden, wobei wir die Veraltungsbeschränkungen aus den zookies der Anfragen respektieren. Diese Zeitstempelquantisierung erlaubt es, die überwiegende Mehrheit aktueller Prüfungen und Lesevorgänge zu denselben Zeitstempeln auszuwerten und Cache-Ergebnisse gemeinsam zu nutzen, obwohl die Cache-Schlüssel Zeitstempel mit Mikrosekundenauflösung enthalten. Es sei angemerkt, dass das Aufrunden von Zeitstempeln die Konsistenzeigenschaften von Zanzibar nicht beeinträchtigt, da Spanner sicherstellt, dass ein Snapshot-Lesevorgang zum Zeitstempel alle Schreibvorgänge bis beobachtet – dies gilt selbst dann, wenn in der Zukunft liegt; in diesem Fall wartet der Lesevorgang, bis TrueTime überschritten hat.
To handle the “cache stampede” problem [3], where concurrent requests create flash hot spots before the cache is populated with results, we maintain a lock table on each server to track outstanding reads and checks. Among requests sharing the same cache key only one request will begin processing; the rest block until the cache is populated.
Um das „Cache-Stampede“-Problem [3] zu behandeln, bei dem nebenläufige Anfragen kurzzeitige Hotspots erzeugen, bevor der Cache mit Ergebnissen befüllt ist, pflegen wir auf jedem Server eine Sperrtabelle, um ausstehende Lesevorgänge und Prüfungen zu verfolgen. Unter Anfragen mit demselben Cache-Schlüssel beginnt nur eine Anfrage mit der Verarbeitung; die übrigen blockieren, bis der Cache befüllt ist.
We can effectively handle the vast majority of hot spots with distributed caches and lock tables. Over time we made the following two improvements.
Mit verteilten Caches und Sperrtabellen können wir die überwiegende Mehrheit der Hotspots wirksam behandeln. Im Laufe der Zeit haben wir die folgenden zwei Verbesserungen vorgenommen.
First, direct membership checks of a user for an object and relation (i.e. ⟨object#relation@user⟩) are usually handled by a single relation tuple lookup. However, occasionally a very popular object invites many concurrent checks for different users, causing a hot spot on the storage server hosting relation tuples for the object. To avoid these hot spots, we read and cache all relation tuples of ⟨object#relation⟩ for the hot object, trading read bandwidth for cacheability. We dynamically detect hot objects to apply this method to by tracking the number of outstanding reads on each object.
Erstens werden direkte Mitgliedschaftsprüfungen eines Benutzers für ein Objekt und eine Relation (d. h. ⟨object#relation@user⟩) üblicherweise durch ein einziges Nachschlagen eines Relationstupels behandelt. Gelegentlich zieht jedoch ein sehr populäres Objekt viele nebenläufige Prüfungen für verschiedene Benutzer auf sich und verursacht so einen Hotspot auf dem Speicherserver, der die Relationstupel für das Objekt hostet. Um diese Hotspots zu vermeiden, lesen und cachen wir alle Relationstupel von ⟨object#relation⟩ für das heiße Objekt und tauschen so Lesebandbreite gegen Cachebarkeit. Wir erkennen heiße Objekte, auf die diese Methode angewendet werden soll, dynamisch, indem wir die Anzahl ausstehender Lesevorgänge für jedes Objekt verfolgen.
Second, indirect ACL checks are frequently cancelled when the result of the parent ACL check is already determined. This leaves the cache key unpopulated. While eager cancellation reduces resource usage significantly, it negatively affects latency of concurrent requests that are blocked by the lock table entry. To prevent this latency impact, we delay eager cancellation when there are waiters on the corresponding lock table entry.
Zweitens werden indirekte ACL-Prüfungen häufig abgebrochen, wenn das Ergebnis der übergeordneten ACL-Prüfung bereits feststeht. Dadurch bleibt der Cache-Schlüssel unbefüllt. Während ein frühzeitiger Abbruch den Ressourcenverbrauch erheblich senkt, wirkt er sich negativ auf die Latenz nebenläufiger Anfragen aus, die durch den Eintrag in der Sperrtabelle blockiert werden. Um diese Auswirkung auf die Latenz zu verhindern, verzögern wir den frühzeitigen Abbruch, wenn auf den entsprechenden Eintrag in der Sperrtabelle gewartet wird.
Performance isolation is indispensable for shared services targeting low latency and high availability. If Zanzibar or one of its clients occasionally fails to provision enough resources to handle an unexpected usage pattern, the following isolation mechanisms ensure that performance problems are isolated to the problematic use case and do not adversely affect other clients.
Leistungsisolation ist für gemeinsam genutzte Dienste, die niedrige Latenz und hohe Verfügbarkeit anstreben, unverzichtbar. Wenn es Zanzibar oder einem seiner Clients gelegentlich nicht gelingt, genügend Ressourcen bereitzustellen, um ein unerwartetes Nutzungsmuster zu bewältigen, stellen die folgenden Isolationsmechanismen sicher, dass Leistungsprobleme auf den problematischen Anwendungsfall beschränkt bleiben und andere Clients nicht beeinträchtigen.
First, to ensure proper allocation of CPU capacity, Zanzibar measures the cost of each RPC in terms of generic cpu-seconds, a hardware-agnostic metric. Each client has a global limit on maximum CPU usage per second; its RPCs will be throttled if it exceeds the limit and there is no spare capacity in the overall system.
Erstens misst Zanzibar, um eine angemessene Zuteilung der CPU-Kapazität sicherzustellen, die Kosten jedes RPC in generischen CPU-Sekunden, einer hardwareunabhängigen Metrik. Jeder Client hat ein globales Limit für die maximale CPU-Nutzung pro Sekunde; seine RPCs werden gedrosselt, wenn er das Limit überschreitet und im Gesamtsystem keine freie Kapazität vorhanden ist.
Each Zanzibar server also limits the total number of outstanding RPCs to control its memory usage. Likewise it limits the number of oustanding RPCs per client.
Jeder Zanzibar-Server begrenzt außerdem die Gesamtzahl ausstehender RPCs, um seinen Speicherverbrauch zu kontrollieren. Ebenso begrenzt er die Anzahl ausstehender RPCs pro Client.
Zanzibar further limits the maximum number of concurrent reads per (object, client) and per client on each Spanner server. This ensures that no single object or client can monopolize a Spanner server.
Zanzibar begrenzt ferner die maximale Anzahl nebenläufiger Lesevorgänge pro (Objekt, Client) und pro Client auf jedem Spanner-Server. Dies stellt sicher, dass kein einzelnes Objekt und kein einzelner Client einen Spanner-Server monopolisieren kann.
Finally, we use different lock table keys for requests from different clients to prevent any throttling that Spanner applies to one client from affecting other clients.
Schließlich verwenden wir für Anfragen verschiedener Clients unterschiedliche Sperrtabellenschlüssel, um zu verhindern, dass eine Drosselung, die Spanner auf einen Client anwendet, andere Clients beeinträchtigt.
Zanzibar’s distributed processing requires measures to accommodate slow tasks. For calls to Spanner and to the Leopard index we rely on request hedging [16] (i.e. we send the same request to multiple servers, use whichever response comes back first, and cancel the other requests). To reduce round-trip times, we try to place at least two replicas of these backend services in every geographical region where we have Zanzibar servers. To avoid unnecessarily multiplying load, we first send one request and defer sending hedged requests until the initial request is known to be slow.
Die verteilte Verarbeitung von Zanzibar erfordert Maßnahmen, um langsame Tasks abzufangen. Für Aufrufe an Spanner und an den Leopard-Index setzen wir auf Request-Hedging [16] (d. h. wir senden dieselbe Anfrage an mehrere Server, verwenden die Antwort, die zuerst zurückkommt, und brechen die anderen Anfragen ab). Um Round-Trip-Zeiten zu verringern, versuchen wir, in jeder geografischen Region, in der wir Zanzibar-Server haben, mindestens zwei Replikate dieser Backend-Dienste zu platzieren. Um die Last nicht unnötig zu vervielfachen, senden wir zunächst eine Anfrage und schieben das Senden von Hedging-Anfragen auf, bis bekannt ist, dass die ursprüngliche Anfrage langsam ist.
To determine the appropriate hedging delay threshold, each server maintains a delay estimator that dynamically computes an Nth percentile latency based on recent measurements. This mechanism allows us to limit the additional traffic incurred by hedging to a small fraction of total traffic.
Um den geeigneten Verzögerungsschwellenwert für das Hedging zu bestimmen, pflegt jeder Server einen Verzögerungsschätzer, der auf Grundlage aktueller Messungen dynamisch eine Latenz im N-ten Perzentil berechnet. Dieser Mechanismus erlaubt es uns, den durch Hedging verursachten zusätzlichen Datenverkehr auf einen kleinen Bruchteil des gesamten Datenverkehrs zu begrenzen.
Effective hedging requires the requests to have similar costs. In the case of Zanzibar’s authorization checks, some checks are inherently more time-consuming than others because they require more work. Hedging check requests would result in duplicating the most expensive workloads and, ironically, worsening latency. Therefore we do not hedge requests between Zanzibar servers, but rely on the previously discussed sharding among multiple replicas and on monitoring mechanisms to detect and avoid slow servers.
Wirksames Hedging setzt voraus, dass die Anfragen ähnliche Kosten haben. Im Fall der Autorisierungsprüfungen von Zanzibar sind manche Prüfungen von Natur aus zeitaufwendiger als andere, da sie mehr Arbeit erfordern. Hedging von Check-Anfragen würde dazu führen, die teuersten Arbeitslasten zu duplizieren und die Latenz ironischerweise zu verschlechtern. Daher setzen wir kein Hedging für Anfragen zwischen Zanzibar-Servern ein, sondern stützen uns auf das zuvor besprochene Sharding über mehrere Replikate sowie auf Überwachungsmechanismen, um langsame Server zu erkennen und zu meiden.
Zanzibar has been in production use for more than 5 years. Throughout that time, the number of clients using Zanzibar and the load they place on Zanzibar have grown steadily. This section discusses our experience operating Zanzibar as a globally distributed authorization system.
Zanzibar ist seit mehr als 5 Jahren im Produktiveinsatz. Während dieser gesamten Zeit sind die Anzahl der Clients, die Zanzibar nutzen, und die Last, die sie auf Zanzibar erzeugen, stetig gewachsen. Dieser Abschnitt erörtert unsere Erfahrungen mit dem Betrieb von Zanzibar als global verteiltes Autorisierungssystem.
Zanzibar manages more than 1,500 namespaces defined by hundreds of client applications. The size of a namespace configuration file serves as a rough measure of the complexity of the access control policy implemented by that namespace. These configuration files range from tens of lines to thousands of lines, with the median near 500 lines.
Zanzibar verwaltet mehr als 1.500 Namespaces, die von Hunderten von Client-Anwendungen definiert werden. Die Größe einer Namespace-Konfigurationsdatei dient als grobes Maß für die Komplexität der von diesem Namespace implementierten Zugriffskontrollrichtlinie. Diese Konfigurationsdateien reichen von Dutzenden bis zu Tausenden von Zeilen, mit einem Median von etwa 500 Zeilen.
These namespaces contain more than 2 trillion relation tuples that occupy close to 100 terabytes. The number of tuples per namespace ranges over many orders of magnitude, from tens to a trillion, with the median near 15,000. This data is fully replicated in more than 30 locations around the world to maintain both proximity to users and high availability.
Diese Namespaces enthalten mehr als 2 Billionen Relationstupel, die fast 100 Terabyte belegen. Die Anzahl der Tupel pro Namespace erstreckt sich über viele Größenordnungen, von Dutzenden bis zu einer Billion, mit einem Median von etwa 15.000. Diese Daten werden vollständig an mehr als 30 Standorten weltweit repliziert, um sowohl Nähe zu den Benutzern als auch hohe Verfügbarkeit zu gewährleisten.
Zanzibar serves more than 10 million client queries per second (QPS). Over a sample 7-day period in December 2018, Check requests peak at roughly 4.2M QPS, Read at 8.2M, Expand at 760K, and Write at 25K. Queries that read data are thus two orders of magnitude more frequent than those that write data.
Zanzibar bedient mehr als 10 Millionen Client-Anfragen pro Sekunde (QPS). Über einen beispielhaften Zeitraum von 7 Tagen im Dezember 2018 erreichen Check-Anfragen Spitzenwerte von etwa 4,2M QPS, Read von 8,2M, Expand von 760K und Write von 25K. Anfragen, die Daten lesen, sind somit um zwei Größenordnungen häufiger als solche, die Daten schreiben.
Zanzibar distributes this load across more than 10,000 servers organized in several dozen clusters around the world. The number of servers per cluster ranges from fewer than 100 to more than 1,000, with the median near 500. Clusters are sized in proportion to load in their geographic regions.
Zanzibar verteilt diese Last auf mehr als 10.000 Server, die in mehreren Dutzend Clustern weltweit organisiert sind. Die Anzahl der Server pro Cluster reicht von weniger als 100 bis zu mehr als 1.000, mit einem Median von etwa 500. Cluster werden proportional zur Last in ihren geografischen Regionen dimensioniert.
We divide requests into two categories according to the required data freshness, which can have a large impact on latency and availability of the requests. Specifically, Check, Read, and Expand requests carry zookies to specify lower bounds on evaluation timestamps. When a zookie timestamp is higher than that of the most recent data replicated to the region, the storage reads require cross-region round trips to the leader replica to retrieve fresher data. As our storage is configured with replication heartbeats with 8-second intervals, we divide our requests into two categories: Safe requests have zookies more than 10 seconds old and can be served within the region most of time, while Recent requests have zookies less than 10 seconds old and often require inter-region round trips. We report separate statistics for each.
Wir teilen Anfragen gemäß der erforderlichen Datenaktualität, die großen Einfluss auf Latenz und Verfügbarkeit der Anfragen haben kann, in zwei Kategorien ein. Konkret tragen Check-, Read- und Expand-Anfragen zookies, um untere Schranken für Auswertungszeitstempel festzulegen. Ist ein zookie-Zeitstempel höher als der der neuesten in die Region replizierten Daten, erfordern die Speicherlesevorgänge regionsübergreifende Round Trips zum Leader-Replikat, um aktuellere Daten abzurufen. Da unser Speicher mit Replikations-Heartbeats in 8-Sekunden-Intervallen konfiguriert ist, teilen wir unsere Anfragen in zwei Kategorien ein: Safe-Anfragen haben zookies, die älter als 10 Sekunden sind, und können meistens innerhalb der Region bedient werden, während Recent-Anfragen zookies haben, die jünger als 10 Sekunden sind, und oft Round Trips zwischen Regionen erfordern. Wir berichten für beide getrennte Statistiken.
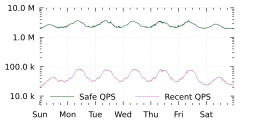
Figure 3: Rate of Check Safe and Check Recent requests over a 7-day period in December 2018.
Abbildung 3: Rate der Check-Safe- und Check-Recent-Anfragen über einen Zeitraum von 7 Tagen im Dezember 2018.
Figure 3 shows the rate of Check Safe and Check Recent requests over 7 days. Both exhibit a diurnal cycle. The rate of Safe requests is about two orders of magnitude larger than that of Recent requests, which allows Zanzibar to serve the vast majority of ACL checks locally.
Abbildung 3 zeigt die Rate der Check-Safe- und Check-Recent-Anfragen über 7 Tage. Beide weisen einen Tageszyklus auf. Die Rate der Safe-Anfragen ist etwa zwei Größenordnungen größer als die der Recent-Anfragen, was es Zanzibar erlaubt, die überwiegende Mehrheit der ACL-Prüfungen lokal zu bedienen.
Zanzibar’s latency budget is generally a small fraction of the few hundreds of milliseconds of total response time that its clients must provide to be viable interactive services. Consider for example a client that performs authorization checks on multiple documents before it can show the results of a search on those documents.
Das Latenzbudget von Zanzibar ist im Allgemeinen ein kleiner Bruchteil der wenigen hundert Millisekunden Gesamtantwortzeit, die seine Clients bieten müssen, um als interaktive Dienste tragfähig zu sein. Man denke beispielsweise an einen Client, der Autorisierungsprüfungen für mehrere Dokumente durchführt, bevor er die Ergebnisse einer Suche über diese Dokumente anzeigen kann.
We measure latency on the server side using live traffic because (1) latency is heavily influenced by our caching and de-duplication mechanisms so that it is only realistically reflected by live traffic, and (2) accurately measuring latency from clients requires well-behaving clients. Provisioning of client jobs is outside of Zanzibar’s control and sometimes client jobs are overloaded.
Wir messen die Latenz serverseitig anhand des Live-Datenverkehrs, da (1) die Latenz stark von unseren Caching- und Deduplizierungsmechanismen beeinflusst wird, sodass sie nur durch Live-Datenverkehr realistisch abgebildet wird, und (2) eine genaue Latenzmessung auf Client-Seite sich korrekt verhaltende Clients voraussetzt. Die Ressourcenbereitstellung für Client-Jobs liegt außerhalb der Kontrolle von Zanzibar, und manchmal sind Client-Jobs überlastet.
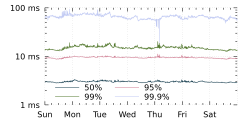
Figure 4: Latency of Check Safe responses at different percentiles over a 7-day period in December 2018.
Abbildung 4: Latenz der Check-Safe-Antworten in verschiedenen Perzentilen über einen Zeitraum von 7 Tagen im Dezember 2018.
Figure 4 shows the latency of Check Safe responses over 7 days. At the 50th, 95th, 99th, and 99.9th percentiles it peaks at roughly 3, 11, 20, and 93 msec, respectively. This performance meets our latency goals for an operation that is frequently in the critical path of user interactions.
Abbildung 4 zeigt die Latenz der Check-Safe-Antworten über 7 Tage. Im 50., 95., 99. und 99,9. Perzentil erreicht sie Spitzenwerte von etwa 3, 11, 20 bzw. 93 ms. Diese Leistung erfüllt unsere Latenzziele für eine Operation, die häufig im kritischen Pfad von Benutzerinteraktionen liegt.
Table 2 summarizes the latency distributions of Check, Read, Expand, and Write responses over the same 7 days. As intended, the more frequently used Safe versions of Check, Read, and Expand are significantly faster than the less frequently used Recent versions. Writes are the least frequently used of all the APIs, and the slowest because they always require distributed coordination among Spanner servers.
Tabelle 2 fasst die Latenzverteilungen der Check-, Read-, Expand- und Write-Antworten über dieselben 7 Tage zusammen. Wie beabsichtigt sind die häufiger verwendeten Safe-Varianten von Check, Read und Expand deutlich schneller als die seltener verwendeten Recent-Varianten. Writes sind von allen APIs am seltensten genutzt und am langsamsten, da sie stets eine verteilte Koordination zwischen Spanner-Servern erfordern.
Table 2: Mean and standard deviation of RPC response latency over a 7-day period in December 2018.
Tabelle 2: Mittelwert und Standardabweichung der RPC-Antwortlatenz über einen Zeitraum von 7 Tagen im Dezember 2018.
We define availability as the fraction of “qualified” RPCs the service answers successfully within latency thresholds: 5 seconds for a Safe request, and 15 seconds for a Recent request as leader re-election in Spanner may take up to 10 seconds. For an RPC to be qualified, the request must be well-formed and have a deadline longer than the latency threshold. In addition, the client must stay within its resource quota.
Wir definieren Verfügbarkeit als den Anteil „qualifizierter“ RPCs, die der Dienst innerhalb der Latenzschwellen erfolgreich beantwortet: 5 Sekunden für eine Safe-Anfrage und 15 Sekunden für eine Recent-Anfrage, da eine Neuwahl des Leaders in Spanner bis zu 10 Sekunden dauern kann. Damit ein RPC qualifiziert ist, muss die Anfrage wohlgeformt sein und eine Deadline haben, die länger als die Latenzschwelle ist. Außerdem muss der Client innerhalb seines Ressourcenkontingents bleiben.
For these reasons, we cannot measure availability directly with live traffic, as our clients sometimes send RPCs with short deadlines or cancel their in-progress RPCs. Instead, we sample a small fraction of valid requests from live traffic and replay them later with our own probers. When replaying the requests, we set the timeout to be longer than the availability threshold. We also adjust the request zookie, if one is specified, so that the relative age of the zookie remains the same as when the request was received in the live traffic. Finally, we run 3 probers per cluster and exclude outliers to eliminate false alarms caused by rare prober failures.
Aus diesen Gründen können wir die Verfügbarkeit nicht direkt anhand des Live-Datenverkehrs messen, da unsere Clients manchmal RPCs mit kurzen Deadlines senden oder laufende RPCs abbrechen. Stattdessen ziehen wir eine kleine Stichprobe gültiger Anfragen aus dem Live-Datenverkehr und spielen sie später mit unseren eigenen Probern erneut ab. Beim erneuten Abspielen der Anfragen setzen wir das Timeout länger als die Verfügbarkeitsschwelle. Außerdem passen wir den zookie der Anfrage, sofern einer angegeben ist, so an, dass das relative Alter des zookie dasselbe bleibt wie zu dem Zeitpunkt, als die Anfrage im Live-Datenverkehr empfangen wurde. Schließlich betreiben wir 3 Prober pro Cluster und schließen Ausreißer aus, um Fehlalarme durch seltene Prober-Ausfälle zu eliminieren.
To compute availability, we aggregate success ratios over 90-day windows averaged across clusters. Figure 5 shows Zanzibar’s availability as measured by these probers. Availability has remained above 99.999% over the past 3 years of operation at Google. In other words, for every quarter, Zanzibar has less than 2 minutes of global downtime and fewer than 13 minutes when the global error ratio exceeds 10%.
Zur Berechnung der Verfügbarkeit aggregieren wir Erfolgsquoten über 90-Tage-Fenster, gemittelt über die Cluster. Abbildung 5 zeigt die von diesen Probern gemessene Verfügbarkeit von Zanzibar. Die Verfügbarkeit lag in den vergangenen 3 Betriebsjahren bei Google durchgehend über 99,999%. Mit anderen Worten: In jedem Quartal hat Zanzibar weniger als 2 Minuten globale Ausfallzeit und weniger als 13 Minuten, in denen die globale Fehlerquote 10% übersteigt.
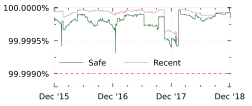
Figure 5: Zanzibar’s availability over the past three years has remained above 99.999%.
Abbildung 5: Die Verfügbarkeit von Zanzibar lag in den vergangenen drei Jahren durchgehend über 99,999%.
Zanzibar servers delegate checks and reads to each other based on consistent hashing, and both the caller and the callee sides of the delegated operations cache the results to prevent hot spots (§3.2.5). At peak, Zanzibar handles 22 million internal “delegated” RPCs per second, split about evenly between reads and checks. In-memory caching handles approximately 200 million lookups per second at peak, 150 million from checks and 50 million from reads. Caching for checks has a 10% hit rate on the delegate’s side, with an additional 12% saved by the lock table. Meanwhile, caching on the delegator’s side has a 2% hit rate with an additional 3% from the lock table. While these hit rates appear low, they prevent 500K internal RPCs per second from creating hot spots.
Zanzibar-Server delegieren Prüfungen und Lesevorgänge auf Grundlage von Consistent Hashing aneinander, und sowohl die aufrufende als auch die aufgerufene Seite der delegierten Operationen cachen die Ergebnisse, um Hotspots zu verhindern (§3.2.5). In Spitzenzeiten verarbeitet Zanzibar 22 Millionen interne „delegierte“ RPCs pro Sekunde, die sich etwa gleichmäßig auf Lesevorgänge und Prüfungen verteilen. Das In-Memory-Caching verarbeitet in Spitzenzeiten etwa 200 Millionen Lookups pro Sekunde, 150 Millionen aus Prüfungen und 50 Millionen aus Lesevorgängen. Das Caching für Prüfungen hat auf der Seite des Delegierten eine Trefferquote von 10%, wobei zusätzlich 12% durch die Sperrtabelle eingespart werden. Das Caching auf der Seite des Delegierenden hat dagegen eine Trefferquote von 2%, mit zusätzlich 3% durch die Sperrtabelle. Auch wenn diese Trefferquoten niedrig erscheinen, verhindern sie, dass 500K interne RPCs pro Sekunde Hotspots erzeugen.
Delegated reads see higher hit rates on the delegate’s side—24% on the cache and 9% on the lock table—but the delegator’s cache is hit less than 1% of the time. For super-hot groups, Zanzibar further optimizes by reading and caching the full set of members in advance—this happens for 0.1% of groups but further prevents hot spots.
Delegierte Lesevorgänge erzielen auf der Seite des Delegierten höhere Trefferquoten – 24% im Cache und 9% in der Sperrtabelle –, doch der Cache des Delegierenden wird in weniger als 1% der Fälle getroffen. Für extrem heiße Gruppen optimiert Zanzibar zusätzlich, indem es die vollständige Mitgliedermenge im Voraus liest und cacht – dies geschieht bei 0,1% der Gruppen, verhindert aber zusätzlich Hotspots.
This caching, along with aggressive pooling of read requests, allows Zanzibar to issue only 20 million read RPCs per second to Spanner. The median of these requests reads 1.5 rows per RPC, but at the 99th percentile they each read close to 1 thousand rows.
Dieses Caching erlaubt es Zanzibar zusammen mit aggressivem Pooling von Leseanfragen, nur 20 Millionen Lese-RPCs pro Sekunde an Spanner zu stellen. Im Median liest jede dieser Anfragen 1,5 Zeilen pro RPC, im 99. Perzentil liest jedoch jede nahezu tausend Zeilen.
Zanzibar’s Spanner reads take 0.5 msec at the median, and 2 msec at the 95th percentile. We find that 1% of Spanner reads, or 200K reads per second, benefit from hedging. We note that Zanzibar uses an instance of Spanner that runs internally to Google, not an instance of Cloud Spanner [6].
Die Spanner-Lesevorgänge von Zanzibar dauern im Median 0,5 ms und im 95. Perzentil 2 ms. Wir stellen fest, dass 1% der Spanner-Lesevorgänge, also 200K Lesevorgänge pro Sekunde, von Hedging profitieren. Wir merken an, dass Zanzibar eine Spanner-Instanz verwendet, die intern bei Google läuft, und keine Instanz von Cloud Spanner [6].
The Leopard index is performing 1.56M QPS at the median, or 2.22M QPS at the 99th percentile, based on data aggregated over 7 days. Over the same 7 days, Leopard servers respond in fewer than 150 μsec at the median, or under 1 msec at the 99th percentile. Leopard’s incremental layer during those 7 days writes roughly 500 index updates per second at the median, and approximately 1.5K updates per second at the 99th percentile.
Der Leopard-Index verarbeitet im Median 1,56M QPS bzw. im 99. Perzentil 2,22M QPS, basierend auf über 7 Tage aggregierten Daten. Über dieselben 7 Tage antworten Leopard-Server im Median in weniger als 150 μs bzw. im 99. Perzentil in unter 1 ms. Die inkrementelle Schicht von Leopard schreibt während dieser 7 Tage im Median etwa 500 Indexaktualisierungen pro Sekunde und im 99. Perzentil etwa 1,5K Aktualisierungen pro Sekunde.
Zanzibar has evolved to meet the varied and heavy demands of a growing set of clients, including Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos, and YouTube. This section highlights lessons learned from this experience.
Zanzibar hat sich weiterentwickelt, um die vielfältigen und hohen Anforderungen einer wachsenden Menge von Clients zu erfüllen, darunter Google Calendar, Google Cloud, Google Drive, Google Maps, Google Photos und YouTube. Dieser Abschnitt hebt die aus dieser Erfahrung gewonnenen Erkenntnisse hervor.
One common theme has been the importance of flexibility to accommodate differences between clients. For example:
Ein wiederkehrendes Thema war die Bedeutung von Flexibilität, um Unterschieden zwischen Clients gerecht zu werden. Zum Beispiel:
- Access control patterns vary widely: Over time we have added features to support specific clients. For instance, we added
computed_usersetto allow inferring an object’s owner ID from the object ID prefix, which reduces space requirements for clients such as Drive and Photos that manage many private objects. Similarly, we addedtuple_to_usersetto represent object hierarchy with only one relation tuple per hop. The benefits are both space reduction and flexibility—it allows clients such as Cloud both to express ACL inheritance compactly and to change ACL inheritance rules without having to update large numbers of tuples. See §2.3.1. - Freshness requirements are often but not always loose: Clients often allow unspecified, moderate staleness during ACL evaluation, but sometimes require more precisely specified freshness. We designed our zookie protocol around this property so that we can serve most requests from a default, already replicated snapshot, while allowing clients to bound the staleness when needed. We also tuned the granularity of our snapshot timestamps to match clients’ freshness requirements. The resulting coarse timestamp quanta allow us to perform the majority of authorization checks on a small number of snapshots, thus greatly reducing the frequency of database reads. See §3.2.1.
- Zugriffskontrollmuster variieren stark: Im Laufe der Zeit haben wir Funktionen hinzugefügt, um bestimmte Clients zu unterstützen. So haben wir beispielsweise
computed_usersethinzugefügt, um die Eigentümer-ID eines Objekts aus dem Präfix der Objekt-ID ableiten zu können, was den Speicherbedarf für Clients wie Drive und Photos verringert, die viele private Objekte verwalten. Ebenso haben wirtuple_to_usersethinzugefügt, um Objekthierarchien mit nur einem Relationstupel pro Hop darzustellen. Die Vorteile sind sowohl Platzersparnis als auch Flexibilität – es erlaubt Clients wie Cloud, ACL-Vererbung kompakt auszudrücken und ACL-Vererbungsregeln zu ändern, ohne große Mengen von Tupeln aktualisieren zu müssen. Siehe §2.3.1. - Aktualitätsanforderungen sind oft, aber nicht immer locker: Clients erlauben während der ACL-Auswertung oft eine nicht näher spezifizierte, moderate Veraltung, verlangen aber manchmal eine genauer spezifizierte Aktualität. Wir haben unser zookie-Protokoll um diese Eigenschaft herum entworfen, sodass wir die meisten Anfragen von einem standardmäßigen, bereits replizierten Snapshot bedienen können und Clients dennoch erlauben, die Veraltung bei Bedarf zu begrenzen. Außerdem haben wir die Granularität unserer Snapshot-Zeitstempel auf die Aktualitätsanforderungen der Clients abgestimmt. Die daraus resultierenden groben Zeitstempelquanten erlauben es uns, die Mehrheit der Autorisierungsprüfungen auf einer kleinen Anzahl von Snapshots durchzuführen, was die Häufigkeit von Datenbank-Lesevorgängen stark reduziert. Siehe §3.2.1.
Another theme has been the need to add performance optimizations to support client behaviors observed in production. For example:
Ein weiteres Thema war die Notwendigkeit, Leistungsoptimierungen hinzuzufügen, um im Produktivbetrieb beobachtetes Client-Verhalten zu unterstützen. Zum Beispiel:
- Request hedging is key to reducing tail latency: Clients that offer search capabilities to their users, such as Drive, often issue tens to hundreds of authorization checks to serve a single set of search results. We introduced hedging of Spanner and Leopard requests to prevent an occasional slow operation from slowing the overall user interaction. See §3.2.7.
- Hot-spot mitigation is critical for high availability: Some workloads create hot spots in ACL data that can overwhelm the underlying database servers. A common pattern is a burst of ACL checks for an object that is indirectly referenced by the ACLs for many different objects. Specific instances arise from the search use case mentioned above, where the documents in the search indirectly share ACLs for a large social or work group, and Cloud use cases where many objects indirectly share ACLs for the same object high in a hierarchy. Zanzibar handles most hot spots with general mechanisms such as its distributed cache and lock table, but we have found the need to optimize specific uses cases. For example, we added cache prefetching of all relation tuples for a hot object. We also delayed cancellation of secondary ACL checks when there are concurrent requests for the same ACL data. See §3.2.5.
- Performance isolation is indispensable to protect against misbehaving clients: Even with hot-spot mitigation measures, unexpected and sometimes unintended client behaviors could still overload our system or its underlying infrastructure. Examples include when clients launch new features that prove unexpectedly popular or exercise Zanzibar in unintended ways. Over time we have added isolation safeguards to ensure that there are no cascading failures between clients or between objects of the same client. These safeguards include fine-grained cost accounting, quotas, and throttling. See §3.2.6.
- Request-Hedging ist der Schlüssel zur Verringerung der Tail-Latenz: Clients, die ihren Benutzern Suchfunktionen anbieten, wie etwa Drive, führen oft Dutzende bis Hunderte von Autorisierungsprüfungen durch, um eine einzige Menge von Suchergebnissen auszuliefern. Wir haben Hedging von Spanner- und Leopard-Anfragen eingeführt, um zu verhindern, dass eine gelegentliche langsame Operation die gesamte Benutzerinteraktion verlangsamt. Siehe §3.2.7.
- Die Abmilderung von Hotspots ist entscheidend für hohe Verfügbarkeit: Manche Arbeitslasten erzeugen Hotspots in ACL-Daten, die die zugrunde liegenden Datenbankserver überlasten können. Ein häufiges Muster ist eine Häufung von ACL-Prüfungen für ein Objekt, auf das die ACLs vieler verschiedener Objekte indirekt verweisen. Konkrete Fälle ergeben sich aus dem oben erwähnten Suchanwendungsfall, bei dem die Dokumente in der Suche indirekt ACLs für eine große soziale oder Arbeitsgruppe teilen, sowie aus Cloud-Anwendungsfällen, in denen viele Objekte indirekt ACLs für dasselbe, in einer Hierarchie weit oben liegende Objekt teilen. Zanzibar behandelt die meisten Hotspots mit allgemeinen Mechanismen wie seinem verteilten Cache und seiner Sperrtabelle, doch wir haben festgestellt, dass bestimmte Anwendungsfälle optimiert werden müssen. Beispielsweise haben wir Cache-Prefetching aller Relationstupel für ein heißes Objekt hinzugefügt. Außerdem haben wir den Abbruch sekundärer ACL-Prüfungen verzögert, wenn es nebenläufige Anfragen für dieselben ACL-Daten gibt. Siehe §3.2.5.
- Leistungsisolation ist unverzichtbar zum Schutz vor sich fehlverhaltenden Clients: Selbst mit Maßnahmen zur Abmilderung von Hotspots könnte unerwartetes und manchmal unbeabsichtigtes Client-Verhalten unser System oder die zugrunde liegende Infrastruktur dennoch überlasten. Beispiele sind Fälle, in denen Clients neue Funktionen einführen, die sich als unerwartet populär erweisen, oder Zanzibar auf unbeabsichtigte Weise nutzen. Im Laufe der Zeit haben wir Isolationsschutzmaßnahmen hinzugefügt, um sicherzustellen, dass es keine kaskadierenden Ausfälle zwischen Clients oder zwischen Objekten desselben Clients gibt. Zu diesen Schutzmaßnahmen gehören feingranulare Kostenerfassung, Kontingente und Drosselung. Siehe §3.2.6.
Zanzibar is a planet-scale distributed ACL storage and evaluation system. Many of its authorization concepts have been explored previously within the domains of access control and social graphs, and its scaling challenges have been investigated within the field of distributed systems.
Zanzibar ist ein verteiltes System zur Speicherung und Auswertung von ACLs im planetaren Maßstab. Viele seiner Autorisierungskonzepte wurden bereits zuvor in den Bereichen Zugriffskontrolle und soziale Graphen untersucht, und seine Skalierungsherausforderungen wurden auf dem Gebiet der verteilten Systeme erforscht.
Access control is a core part of multi-user operating systems. Multics [23] supports ACLs on segments and directories. ACL entries consist of a principal identifier and a set of permissions bits. In the first edition of UNIX [9], file flags indicate whether owner and non-owner can read or write the file. By the 4th edition, the permissions bits had been expanded to read/write/execute bits for owner, group, and others. POSIX ACLs [4] add an arbitrary list of users and groups, each with up to 32 permissions bits. VMS [7, 8] supports ACL inheritance for files created within a directory tree. Zanzibar’s data model supports permissions, users, groups, and inheritance as found in the above systems.
Zugriffskontrolle ist ein Kernbestandteil von Mehrbenutzer-Betriebssystemen. Multics [23] unterstützt ACLs auf Segmenten und Verzeichnissen. ACL-Einträge bestehen aus einem Principal-Bezeichner und einer Menge von Berechtigungsbits. In der ersten Ausgabe von UNIX [9] geben Datei-Flags an, ob Eigentümer und Nicht-Eigentümer die Datei lesen oder schreiben dürfen. Bis zur 4. Ausgabe waren die Berechtigungsbits auf Lese-/Schreib-/Ausführungsbits für Eigentümer, Gruppe und andere erweitert worden. POSIX-ACLs [4] fügen eine beliebige Liste von Benutzern und Gruppen hinzu, jeweils mit bis zu 32 Berechtigungsbits. VMS [7, 8] unterstützt ACL-Vererbung für Dateien, die innerhalb eines Verzeichnisbaums erstellt werden. Das Datenmodell von Zanzibar unterstützt Berechtigungen, Benutzer, Gruppen und Vererbung, wie sie in den oben genannten Systemen zu finden sind.
Taos [24, 10] supports compound principals that incorporate how an identity has been transformed as it passes through a distributed system. For example, if user logged into workstation to access file server , would see requests authenticated as “ for ” rather than just . This would allow one to write an ACL on a user’s e-mail that would be accessible only to the user, and only if being accessed via the mail server. Abadi et al. discuss in [11] a model of group-based ACLs with support for compound identities. Their notion of “blessings” are similar to Zanzibar tuples. However, Zanzibar adopts a unified representation for ACLs and groups using usersets, while they are separate concepts in [11].
Taos [24, 10] unterstützt zusammengesetzte Principals, die abbilden, wie eine Identität beim Durchlaufen eines verteilten Systems transformiert wurde. Wenn sich beispielsweise Benutzer an Workstation angemeldet hat, um auf Dateiserver zuzugreifen, würde Anfragen sehen, die als „ für “ statt nur als authentifiziert sind. Dies würde es ermöglichen, für die E-Mail eines Benutzers eine ACL zu schreiben, die nur für den Benutzer zugänglich wäre, und nur dann, wenn der Zugriff über den Mailserver erfolgt. Abadi et al. erörtern in [11] ein Modell gruppenbasierter ACLs mit Unterstützung für zusammengesetzte Identitäten. Ihr Begriff der „Blessings“ ähnelt den Zanzibar-Tupeln. Zanzibar verwendet jedoch mithilfe von Usersets eine einheitliche Darstellung für ACLs und Gruppen, während diese in [11] getrennte Konzepte sind.
Role-based access control (RBAC), first proposed in [17], introduced the notion of roles, which are similar to Zanzibar relations. Roles can inherit from each other and imply permissions. A number of Zanzibar clients have implemented RBAC policies on top of Zanzibar’s namespace configuration language.
Rollenbasierte Zugriffskontrolle (RBAC), erstmals in [17] vorgeschlagen, führte den Begriff der Rollen ein, die den Relationen von Zanzibar ähneln. Rollen können voneinander erben und Berechtigungen implizieren. Eine Reihe von Zanzibar-Clients hat RBAC-Richtlinien auf Basis der Namespace-Konfigurationssprache von Zanzibar implementiert.
A discussion of ACL stores in 2019 would be remiss without mentioning the Identity and Access Management (IAM) systems offered commercially by Amazon [1], Google [5], Microsoft [2], and others. These systems allow customers of those companies’ cloud products to configure flexible access controls based on various features such as: assigning users to roles or groups; domain-specific policy languages; and APIs that allow the creation and modification of ACLs. What all of these systems have in common is unified ACL storage and an RPC-based API, a philosophy also core to Zanzibar’s design. Google’s Cloud IAM system [5] is built as a layer on top of Zanzibar’s ACL storage and evaluation system.
Eine Diskussion von ACL-Speichern im Jahr 2019 wäre unvollständig ohne die Erwähnung der Identity-and-Access-Management-Systeme (IAM), die kommerziell von Amazon [1], Google [5], Microsoft [2] und anderen angeboten werden. Diese Systeme erlauben es Kunden der Cloud-Produkte dieser Unternehmen, flexible Zugriffskontrollen auf Basis verschiedener Funktionen zu konfigurieren, etwa: Zuweisung von Benutzern zu Rollen oder Gruppen; domänenspezifische Richtliniensprachen; und APIs, die das Erstellen und Ändern von ACLs ermöglichen. Allen diesen Systemen gemeinsam sind eine einheitliche ACL-Speicherung und eine RPC-basierte API, eine Philosophie, die auch für das Design von Zanzibar zentral ist. Das Cloud-IAM-System von Google [5] ist als Schicht auf dem ACL-Speicher- und Auswertungssystem von Zanzibar aufgebaut.
TAO [13] is a distributed datastore for Facebook’s social graph. Several Zanzibar clients also use Zanzibar to store their social graphs. Both Zanzibar and TAO provide authorization checks to clients. Both are deployed as single-instance services, both operate at a large scale, and both are optimized for read-only operations. TAO offers eventual global consistency with asynchronous replication and best-effort read-after-write consistency with synchronous cache updates. In contrast, Zanzibar provides external consistency and snapshot reads with bounded staleness, so that it respects causal ordering between ACL and content updates and thus protects against the “new enemy” problem.
TAO [13] ist ein verteilter Datenspeicher für den sozialen Graphen von Facebook. Mehrere Zanzibar-Clients nutzen Zanzibar ebenfalls, um ihre sozialen Graphen zu speichern. Sowohl Zanzibar als auch TAO stellen Clients Autorisierungsprüfungen bereit. Beide werden als Single-Instance-Dienste betrieben, beide arbeiten in großem Maßstab, und beide sind für reine Leseoperationen optimiert. TAO bietet letztendliche globale Konsistenz (Eventual Consistency) mit asynchroner Replikation und Read-after-Write-Konsistenz nach dem Best-Effort-Prinzip mit synchronen Cache-Aktualisierungen. Im Gegensatz dazu bietet Zanzibar externe Konsistenz und Snapshot-Lesevorgänge mit begrenzter Veraltung, sodass es die kausale Reihenfolge zwischen ACL- und Inhaltsaktualisierungen respektiert und damit vor dem „New Enemy“-Problem schützt.
Lamport clocks [22] provide partially ordered vector timestamps that can be used to determine the order of events. However, Lamport clocks require explicit participation of all “processes”, where in Zanzibar’s use cases some of the “processes” can be external clients or even human users. In contrast, Zanzibar relies on its underlying database system, Spanner [15], to offer both external consistency and snapshot reads with bounded staleness. In particular, Zanzibar builds on Spanner’s TrueTime abstraction [15] to provide linearizable commit timestamps encoded as zookies.
Lamport-Uhren [22] liefern teilweise geordnete Vektor-Zeitstempel, mit denen sich die Reihenfolge von Ereignissen bestimmen lässt. Lamport-Uhren erfordern jedoch die explizite Beteiligung aller „Prozesse“, wobei in den Anwendungsfällen von Zanzibar einige der „Prozesse“ externe Clients oder sogar menschliche Benutzer sein können. Im Gegensatz dazu stützt sich Zanzibar auf sein zugrunde liegendes Datenbanksystem Spanner [15], um sowohl externe Konsistenz als auch Snapshot-Lesevorgänge mit begrenzter Veraltung zu bieten. Insbesondere baut Zanzibar auf der TrueTime-Abstraktion von Spanner [15] auf, um linearisierbare Commit-Zeitstempel bereitzustellen, die als zookies kodiert sind.
At the same time, Zanzibar adds a number of features on top of those provided by Spanner. For one, the zookie protocol does not let clients read or evaluate ACLs at an arbitrary snapshot. This restriction allows Zanzibar to choose a snapshot that facilitates fast ACL evaluation. In addition, Zanzibar provides resilience to database hotspots (e.g. authorization checks on a suddenly popular video) and safe pointer chasing despite potentially deep recursion (e.g. membership checks on hierarchical groups).
Zugleich fügt Zanzibar den von Spanner bereitgestellten Funktionen eine Reihe weiterer Funktionen hinzu. Zum einen lässt das zookie-Protokoll Clients ACLs nicht auf einem beliebigen Snapshot lesen oder auswerten. Diese Einschränkung erlaubt es Zanzibar, einen Snapshot zu wählen, der eine schnelle ACL-Auswertung begünstigt. Darüber hinaus bietet Zanzibar Widerstandsfähigkeit gegenüber Datenbank-Hotspots (z. B. Autorisierungsprüfungen für ein plötzlich populäres Video) und sicheres Pointer-Chasing trotz potenziell tiefer Rekursion (z. B. Mitgliedschaftsprüfungen auf hierarchischen Gruppen).
The Chubby distributed lock service [14] offers reliable storage, linearizes writes, and provides access control, but it lacks features needed to support Zanzibar’s use cases. In particular, it does not support high volumes of data, efficient range reads, or reads at a client-specified snapshot with bounded staleness. Its cache invalidation mechanism also limits its write throughput.
Der verteilte Lock-Dienst Chubby [14] bietet zuverlässige Speicherung, linearisiert Schreibvorgänge und stellt Zugriffskontrolle bereit, doch ihm fehlen Funktionen, die zur Unterstützung der Anwendungsfälle von Zanzibar erforderlich sind. Insbesondere unterstützt er keine großen Datenmengen, keine effizienten Bereichslesevorgänge und keine Lesevorgänge auf einem vom Client angegebenen Snapshot mit begrenzter Veraltung. Sein Mechanismus zur Cache-Invalidierung begrenzt zudem seinen Schreibdurchsatz.
Finally, ZooKeeper offers a high-performance coordination service [19] but also lacks features required by Zanzibar. Relative to Chubby, it can handle higher read and write rates with more relaxed cache consistency. However, it does not provide external consistency for updates across different nodes since its linearizability is on a per-node basis. It also does not provide snapshot reads with bounded staleness.
Schließlich bietet ZooKeeper einen hochperformanten Koordinationsdienst [19], dem jedoch ebenfalls Funktionen fehlen, die Zanzibar benötigt. Im Vergleich zu Chubby kann er höhere Lese- und Schreibraten bei gelockerter Cache-Konsistenz bewältigen. Er bietet jedoch keine externe Konsistenz für Aktualisierungen über verschiedene Knoten hinweg, da seine Linearisierbarkeit pro Knoten gilt. Außerdem bietet er keine Snapshot-Lesevorgänge mit begrenzter Veraltung.
The Zanzibar authorization system unifies access control data and logic for Google. Its simple yet flexible data model and configuration language support a variety of access control policies from both consumer and enterprise applications.
Das Autorisierungssystem Zanzibar vereinheitlicht Zugriffskontrolldaten und -logik für Google. Sein einfaches und zugleich flexibles Datenmodell und seine Konfigurationssprache unterstützen eine Vielfalt von Zugriffskontrollrichtlinien sowohl von Verbraucher- als auch von Unternehmensanwendungen.
Zanzibar’s external consistency model is one of its most salient features. It respects the ordering of user actions, yet at the same time allows authorization checks to be evaluated at distributed locations without global synchronization.
Das Modell der externen Konsistenz von Zanzibar ist eines seiner herausragendsten Merkmale. Es respektiert die Reihenfolge von Benutzeraktionen und erlaubt es zugleich, Autorisierungsprüfungen an verteilten Standorten ohne globale Synchronisation auszuwerten.
Zanzibar employs other key techniques to provide scalability, low latency, and high availability. For example, it evaluates deeply or widely nested group membership with Leopard, a specialized index for efficient computation of set operations with snapshot consistency. As another example, it combines a distributed cache with a mechanism to deduplicate in-flight requests. It thus mitigates hot spots, a critical production issue when serving data on top of normalized, consistent storage. These measures together result in a system that scales to trillions of access control rules and millions of authorization requests per second.
Zanzibar setzt weitere zentrale Techniken ein, um Skalierbarkeit, niedrige Latenz und hohe Verfügbarkeit zu bieten. Beispielsweise wertet es tief oder breit verschachtelte Gruppenmitgliedschaften mit Leopard aus, einem spezialisierten Index für die effiziente Berechnung von Mengenoperationen mit Snapshot-Konsistenz. Als weiteres Beispiel kombiniert es einen verteilten Cache mit einem Mechanismus zur Deduplizierung laufender Anfragen. Damit mildert es Hotspots ab, ein kritisches Problem im Produktivbetrieb, wenn Daten auf Basis eines normalisierten, konsistenten Speichers ausgeliefert werden. Zusammen ergeben diese Maßnahmen ein System, das auf Billionen von Zugriffskontrollregeln und Millionen von Autorisierungsanfragen pro Sekunde skaliert.
Many people have made technical contributions to Zanzibar. We thank previous and recent members of the development team, including Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp, and Yuliya Zabiyaka. We also thank previous and current members of the Site Reliability Engineering team, including Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson, and Andrea Yu.
Viele Menschen haben technische Beiträge zu Zanzibar geleistet. Wir danken früheren und aktuellen Mitgliedern des Entwicklungsteams, darunter Dan Barella, Miles Chaston, Daria Jung, Alex Mendes da Costa, Xin Pan, Scott Smith, Matthew Steffen, Riva Tropp und Yuliya Zabiyaka. Wir danken außerdem früheren und aktuellen Mitgliedern des Site-Reliability-Engineering-Teams, darunter Randall Bosetti, Hannes Eder, Robert Geisberger, Tom Li, Massimo Maggi, Igor Oks, Aaron Peterson und Andrea Yu.
In addition, a number of people have helped to improve this paper. We received insightful comments from David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen, and Lawrence You. We are also grateful to Nadav Eiron and Royal Hansen for their support. Finally, we thank the anonymous reviewers and our shepherd, Eric Eide, for their constructive feedback.
Darüber hinaus haben eine Reihe von Personen geholfen, dieses Paper zu verbessern. Wir haben aufschlussreiche Kommentare von David Bacon, Carolin Gäthke, Brad Krueger, Ari Shamash, Kai Shen und Lawrence You erhalten. Wir sind außerdem Nadav Eiron und Royal Hansen für ihre Unterstützung dankbar. Schließlich danken wir den anonymen Gutachtern und unserem Shepherd, Eric Eide, für ihr konstruktives Feedback.